
Hur fungerar ljudtranskribering med tidsstämplar och händelsetaggning?
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
En inbyggd transkriberingsmodell på ordnivå tar emot en ljudinspelning eller ström i realtid och returnerar en strukturerad uppsättning taggade token-objekt med tidsstämplar som representerar tal och ljud som inte är tal. Varje token har en av tre typer: word, spacing eller audio_event. Ljudhändelser kan vara skratt, applåder eller andra bakgrundsljud.
I den här artikeln går vi igenom hur ljudtranskribering med tidsstämplar fungerar och varför den är en mer flexibel och kraftfull transkriberingsform än vanlig transkribering som bygger på forcerad justering.
Sammanfattning
- Transkribering på ordnivå returnerar direkt strukturerade uppsättningar av taldata och icke-verbala ljudhändelser med tidsstämplar.
- Detta skiljer sig från vanliga modeller för automatisk taligenkänning, som returnerar hela textblock. För att tidsstämpla dem mot råljudet måste du utföra en andra process för forcerad justering, vilket tar längre tid och kräver mer beräkningskapacitet.
- Händelsetaggar hjälper dig att fånga icke-verbalt innehåll, som skratt eller applåder. Eftersom datan är sökbar kan du använda den för att identifiera höjdpunkter eller virala ögonblick utifrån publikens reaktioner.
- Du kan skicka den strukturerade utdatadatan till applikationer för flera användningsområden, bland annat mycket exakt textning, sökbara ljudarkiv och automatiserad klippning för sociala medier.
- Scribes transkribering på ordnivå stöder upp till 5 kanaler, som transkriberas oberoende av varandra.
Vad är ljudtranskribering med tidsstämplar och händelsetaggar?
Transkribering med tidsstämplar är en form av automatisk taligenkänning (ASR) som registrerar exakta start- och sluttider för ord och andra ljudhändelser, som applåder, medan den transkriberar. Resultatet är helt strukturerad och navigerbar data.
Vanlig ASR-transkribering omvandlar ljud till stora block av läsbar text. Du får undertexter och ett transkript för mänskliga läsare, men det är inte särskilt användbart som data.
Om du vill strukturera den med tidsstämplar måste du köra den genom en separat maskininlärningstjänst som kopplar texten till ljudet. Du kan till slut skapa liknande utdata, men det kräver flera bearbetningssteg i stället för att komma direkt från API:et, vilket ger viss fördröjning och extra beräkningsbelastning.
Gör ljud navigerbart
Den främsta fördelen med transkribering med tidsstämplar och händelsetaggar är att den kan läsas av både människor och maskiner. Det har flera viktiga användningsområden för företag:
- Efterlevnadsgranskning: Du kan söka efter nyckelord i en transkribering och få exakta tidsstämplar för varje förekomst av känsliga uppgifter.
- Videoproduktion och redigering: Videoproduktionsprogram kan synkronisera undertexter med det som sägs på skärmen, ner till millisekunden. De kan också märka upp publikreaktioner på rätt sätt.
- Sökbara arkiv: Team inom bland annat PR, försäljning och utbildning kan transkribera stora mängder kundintervjuer, tal från mässor, webbinarier eller personalmöten till omfattande, sökbara arkiv.
- Marknadsanalys och kundsentiment: Händelsetaggning kan märka upp publikreaktioner som annars kan försvinna i enkel texttranskribering.
Vilka fördelar finns med inbyggda tidsstämplar på ordnivå?
Vanliga Speech to Text-modeller bearbetar tal i segment, vanligtvis hela meningar eller stycken. Om du vill ha tidsstämplar ord för ord måste du skapa ytterligare ett bearbetningslager som utför så kallad forcerad justering i ett andra steg. Det kräver mer infrastruktur, ger fördröjning och fler möjliga felpunkter. De kan till exempel glida ur synk eller helt misslyckas när de ska bearbeta snabbt tal eller tal som överröstas av högt bakgrundsljud.
Transkribering med tidsstämplar, som Scribe kan utföra, undviker detta genom att transkribera mer detaljerat, ord för ord. Det sker i ett enda API-anrop. Ingen ytterligare infrastruktur eller skript krävs. Modellen beräknar tidsstämplarna medan den transkriberar, så taldatan återspeglar alltid ljudet korrekt.

Hur fungerar transkribering med tidsstämplar och händelsetaggar?
Låt oss använda Scribe som exempel.
En inbyggd transkriberingsmodell på ordnivå mappar talljuden i ett ljudflöde till en strukturerad uppsättning token-objekt. Den märker varje token som en av tre typer: word, spacing eller audio_event.
- word: Ett identifierat, enskilt talat ord med angivna start- och sluttider samt en speaker_id-tagg.
- spacing: Explicit taggad tystnad eller pauser mitt i talet. Hjälper textningstjänster att hålla rätt tempo. Används inte för identifierade språk som saknar mellanslag mellan ord, till exempel japanska, mandarin, thailändska, lao, burmesiska och kantonesiska.
- audio_event: Meningsfullt icke-verbalt ljud, som skratt eller applåder. Modellen strukturerar detta som en separat händelsetyp och tvingar inte in ljudet som påhittat tal.

Parametrar för strömning i realtid
Transkriberingsmodeller på ordnivå kan även ha särskilda funktioner som stöder ljudtranskribering via WebSocket i realtid. Till exempel:
- include_timestamps=true: Den här parametern gör att anslutningen inkluderar tidsstämplar på ordnivå i JSON-meddelandena committed_transcript_with_timestamps, som skickas i slutet av varje slutfört ljudsegment. Du får alltså tidsstämplar medan strömmen fortfarande körs. Taggar för ljudhändelser inkluderas bara om tag_audio_events också är aktiverat.
- include_language_detection=true: Den här parametern gör att anslutningen taggar olika upptäckta talade språk tillsammans med modellens konfidenspoäng för identifieringen. Det hjälper dig att skapa flerspråkig textning i realtid.
Hur taggar en Speech to Text-modell händelser som inte är tal?
Scribe taggar ljudhändelser när parametern tag_audio_events är aktiverad. Då taggar den och tidsstämplar specifika start- och sluttider precis som för ord. Den kan tagga flera sorters reaktioner, oftast skratt och applåder, men också andra omgivningsljud som kan vara relevanta i sammanhanget, till exempel fotsteg eller bakgrundsmusik.
På en grundläggande nivå gör detta transkript och textning mer innehållsrika genom att lägga till viktig kontext. Sarkasm kan vara svårare för en läsare att uppfatta i enkel, platt text. En [laughter]-tagg berikar transkriptet och gör det mer känslomässigt uttrycksfullt.
Bättre analys
Händelsetaggning gör också efterföljande analys renare, eftersom verktygen inte behöver tolka ett enda block med ostrukturerad text. Inbyggd transkribering på ordnivå separerar ljudhändelser som strukturerad data, så dina verktyg kan helt enkelt filtrera bort dem vid behov och arbeta med enbart verbalt innehåll.
Eftersom spacing-token gör pauser synliga kan du analysera dem. Det kan vara värdefullt för sentimentanalys och QA, till exempel för att mäta hur länge en kundtjänstmedarbetare var tyst under ett samtal.
Enklare sökning efter tidsstämplar
Du kan också söka specifikt efter dem. Om du gör sentimentanalys av en intervju om produkttestning kan du lyfta fram betydelsefulla känslomässiga reaktioner. Eller om du driver ett konto i sociala medier kan du snabbt söka efter skratt i ett timslångt tal för att hitta de klipp som du tror har störst chans att bli virala.
Vilka praktiska användningsområden finns för strukturerade transkript med tidsstämplar?
Att få strukturerad data direkt i transkriberingar har flera viktiga användningsområden.
Skapa bildtexter och undertexter
Du kan exportera transkript med tidsstämplar direkt till produktionsformat för textning, inklusive SRT och VTT, utan mellanliggande bearbetning. Ditt videoredigeringsverktyg kan använda ordtajming för att markera ord i undertexterna när de sägs.
Transkriberingsmodellen kan enkelt tolka snabbt tal eftersom den bearbetar det ord för ord. Där en vanlig modell kan få problem med snabbt tal eller överlappande röster kan en modell på ordnivå, som Scribe, skapa en ren och strukturerad transkribering.
Sökning i ljud och video
Vanlig transkribering låter dig matcha nyckelord i textblocket, men utan forcerad justering kan du inte hoppa till ögonblicket då en fras yttrades. En nyckelordssökning i en transkribering på ordnivå är helt indexerad och leder dig direkt till sekunden då en fras sades i ljudet. Det förvandlar i praktiken ditt ljudarkiv till en helt sökbar referenskatalog. Funktionen är särskilt användbar för att hantera stora mediebibliotek, podcastnätverk och företagsarkiv.
Efterlevnads- och riskgranskning
Ofta vill du spela in ljud som innehåller känslig information, till exempel kundtjänstsamtal för QA. Det är också de samtal som mest sannolikt innehåller känsliga eller reglerade personuppgifter.
För att följa reglerna och samtidigt ha ljuddata för analys behöver du kunna maskera känsliga uppgifter i transkript i realtid. Inbyggd tidsstämpling på ordnivå låter dig använda funktioner som ElevenLabs Entity Detection, som markerar känsliga entiteter, som kreditkortsnummer eller namn, och returnerar deras positioner och tidsstämplar så att du kan maskera dem i dina transkript medan de strömmas in.
Du kan till exempel identifiera och maskera ett kreditkortsnummer, moderns flicknamn, födelsedatum och kundnamn när de sägs i ett samtal där personens identitet verifieras.
Automatiserad klippning för sociala medier
Du kan också automatisera nyckelordssökningar programmässigt för att hitta höjdpunkter i längre innehåll. Du kan till exempel lyfta fram viktiga ögonblick från ett kampanjtal eller ett företagsseminarium. Det hjälper dig att omvandla nytt innehåll till professionellt redigerade höjdpunkter för YouTube, LinkedIn eller TikTok.
Tajming för flera kanaler och talare
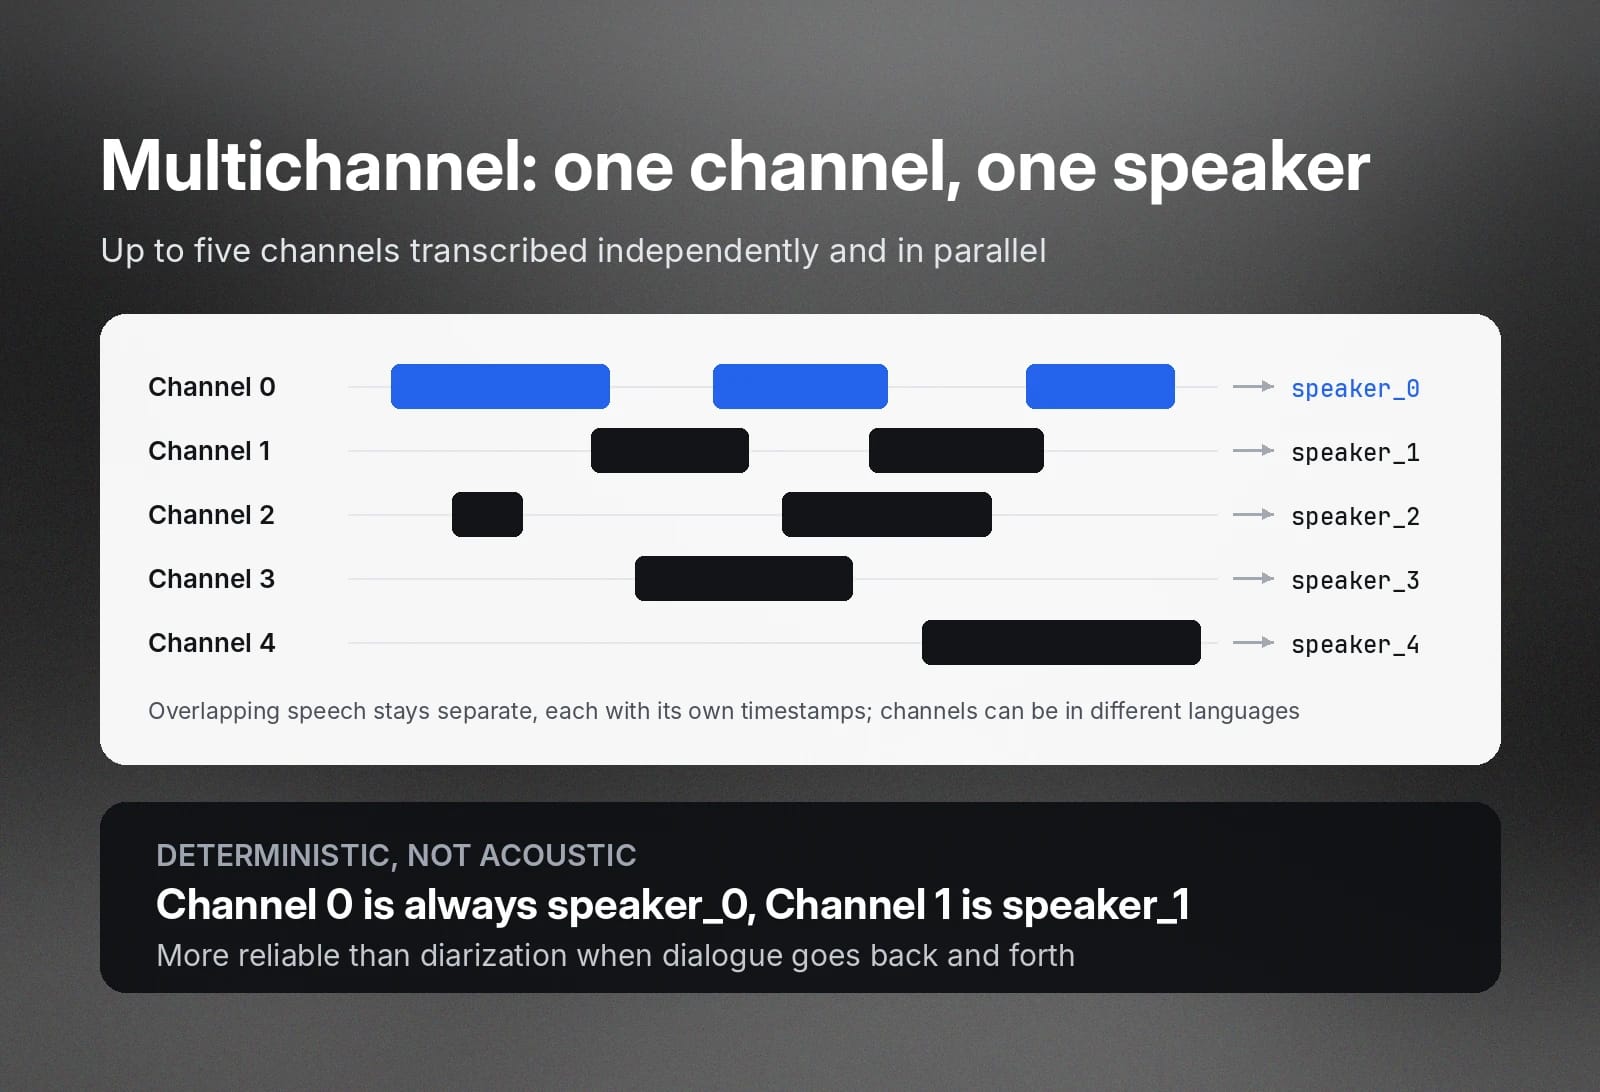
Scribe kan transkribera upp till fem kanaler oberoende och parallellt. Varje kanal får ett talar-ID och tidsstämplar. Det är mer tillförlitligt än vanlig akustisk talardiarisering, som ofta har svårt med dialoger där talarna växlar fram och tillbaka. För flerkanalsinspelningar är Scribes talartilldelning helt deterministisk. Det innebär att kanal 0 mappas till speaker_0, kanal 1 till speaker_1 och så vidare.
Den kan identifiera talare som försöker prata samtidigt och ändå skapa oberoende tidsstämplar för deras tal. De kan dessutom tala olika språk.
Exportera tidsstämplad data i det format du behöver
Om du vill distribuera vanliga transkriberingar i flera format behöver du sannolikt skriva analysskripten själv. Scribe kan exportera transkriberingar i flera format beroende på hur du ska använda dem. Du hittar fullständiga schemadefinitioner i ElevenLabs API-referens för Create Transcript.
Strukturerad data för utvecklare: JSON
Scribe stöder export till JSON för utvecklare som vill ha data i ett schema som de kan skicka vidare till efterföljande applikationer. Utvecklare kan till exempel använda JSON-datan för att bygga interaktiva medier eller en databas för semantisk sökning för organisationen. Hela uppsättningen med word-, spacing- och audio_event-token returneras med start- och slutpositioner samt talar-ID:n.
Medietextning: SRT och VTT
Scribe kan returnera SRT- och VTT-transkript som du kan mata direkt in i Adobe Premiere eller andra produktionsapplikationer utan manuell synkronisering.
Läsbart för människor: TXT, DOCX och PDF
Den kan även returnera transkript i läsarvänliga format. I dessa format tar Scribe bort detaljerade tidsmarkörer för att göra texten mer lättläst och lämplig för juridisk dokumentation eller revisionsunderlag. Det är till exempel användbart när du snabbt behöver distribuera protokoll från styrelsemöten direkt efter ett möte, publicera podcasttranskript för SEO eller arkivera juridiska handlingar.

Börja använda ElevenLabs transkriberingar med tidsstämplar och händelsetaggar
Inbyggd transkribering på ordnivå ger dig den strukturerade data du behöver för dina arbetsflöden, snabbt och effektivt.
Kom igång i dag och transkribera ditt ljud med Scribe i ElevenAPI eller läs mer om transkribering på ordnivå.


