
Vad är latens i Conversational AI och vad påverkar den?
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
För Conversational AI är latens det som skiljer bra applikationer från riktigt bra.
Conversational AI är till sin natur strävsamt. Målet är att efterlikna känslan av att samtala med en människa, med samma känslomässiga omfång, tonläge och rytm. Lägg till den fördröjning som känns ”naturlig” mellan att du slutar prata och att en AI-agent börjar svara, så får du ett latensmål som utgår från hur människor faktiskt kommunicerar.
Företag som vill driftsätta Conversational AI-agenter i stor skala måste minska latensen så mycket som möjligt för att skapa den naturliga känslan. Den här artikeln går igenom vad latens i Conversational AI är, vad som orsakar fördröjningar i hela pipelinen och hur du kan minska dem.
Sammanfattning
- Latens i Conversational AI är den totala fördröjningen från att en användare slutar prata tills hen hör agentens första ord.
- Agenter med en latens över 700 ms kan kännas onaturliga, och de över 1 200 ms har hög avhoppsfrekvens.
- Latens byggs på i varje steg av pipelinen för Conversational AI.
- ElevenAgents hanterar hela pipelinen i en enda enhetlig arkitektur, vilket gör Conversational AI med låg latens tillgängligt för ditt företag.
Vad är latens i Conversational AI?
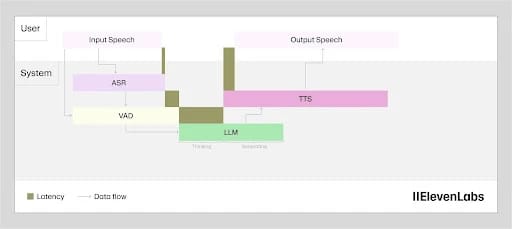
Latens i Conversational AI är den totala tiden det tar för ett system att svara efter att du har pratat. För moderna AI-modeller mäts latens i ms. Bakom kulisserna består den totala latensen av flera separata processer, som var och en utgör en del av hela pipelinen.
En typisk pipeline för Conversational AI ser ut så här:
- En användare pratar
- Ljudet transkriberas av en Speech to Text-modell
- Transkriptionen skickas till en LLM-modell som skapar ett svar
- LLM:ens text syntetiseras sedan till ljud med en Text to Speech-modell
- Ljudet spelas sedan upp för användaren
Vart och ett av dessa steg bidrar med latens till ett Conversational AI-system. Därför finns det några olika förkortningar att reda ut när man pratar om latens.
Modellens inferenslatens
Modellens inferenslatens är den tid en modell lägger på att generera output, mätt internt och utan externa faktorer. Det är ett modellspecifikt mått på hur snabbt din motor presterar för typiska indata. Flash v2.5 har till exempel en inferenslatens på ungefär 75 ms. Med det kan du jämföra hur snabba modeller är mellan olika konkurrenter.
Kom dock ihåg att detta inte är den latens som användaren faktiskt upplever. Måttet gäller enbart den totala tid som en modell lägger på att generera output.
LLM:s tid till första token
Tid till första token (TTFT) för en stor språkmodell (LLM) är den totala tid det tar för modellen att bearbeta en prompt och generera sin första användbara output-token.
TTS-generering startar när den första tokenen anländer från din LLM, så detta mäter hur lång tid LLM:en behöver för att börja trigga din TTS-modell. I de flesta kompletta Conversational AI-system utgör LLM TTFT en betydande del av den totala latensen.
TTS-tid till första ljudet (TTFA)
TTS-tid till första ljudet (TTFA) mäter tiden från den första TTS-begäran tills den första ljudbiten faktiskt lämnar modellen. Det beskriver inferenslatens för modeller, men specifikt för TTS-motorer.
Komplett tid till första ljudet (TTFA)
Den kompletta TTFA:n är den totala latensen i Conversational AI. Den är summan av alla delar av pipelinen, från taligenkänning, LLM TTFT, TTS och TTFA till alla nätverksöverföringar mellan stegen. När man talar om latens i Conversational AI som helhet är detta måttet som användaren upplever.
När användaren pratar väntar hen på den kompletta TTFA:n innan hen hör något från din agent. Det är ett helhetsmått, vilket innebär att en förbättring i vilken del av pipelinen som helst förbättrar det.
Varför latens i Conversational AI är viktigt
När en användare pratar med din AI-agent blir latens avgörande för hur upplevelsen uppfattas. Låg latens minskar tiden användaren måste vänta på ett svar, så att samtalet känns naturligt och agenten framstår som kompetent.
Agenter med hög latens känns konstlade och mindre kompetenta, även om kvaliteten på deras svar är densamma. För företag kan till och med skillnaden på några hundra ms kännas som en evighet och få din kundsupportagent att kännas klumpig och ineffektiv.
Här är några scenarier som visar varför latens i Conversational AI spelar roll i praktiken:
- Under 500 ms: En konversationsagent känns responsiv och smidig. Användarna kanske inte märker fördröjningen mellan att de slutar prata och får sitt första svar, vilket gör att samtalet flyter på.
- 500 ms till 1 000 ms: Fördröjningen mellan att användaren slutar prata och får ett svar kan bli märkbar. Den är bara lite för lång, så användarna kanske försöker anpassa sig i förväg genom att upprepa sig eller pausa för att se om agenten verkligen har förstått dem.
- Över 1 000 ms: Fördröjningarna börjar kännas långsamma, med pauser som får vissa användare att känna att AI-agenten inte riktigt hänger med i samtalet. Transkriptioner kan visa enstaka avbrott eller önskemål om att få prata med en mänsklig agent. I vissa fall kan användarna avbryta samtalet.
Vart och ett av dessa tröskelvärden leder till verkliga affärsresultat.
I den lägre delen av latensspektrumet får du en kundtjänstagent som naturligt kan hantera inkommande frågor och hjälpa användare att lösa sina ärenden utan extra hjälp. Det avlastar dina mänskliga agenter och håller kundnöjdheten hög. I den högre delen av latensspektrumet frustrerar du kunderna med en agent som verkar tveka alldeles för länge.
Vi har definierat riktvärden för latensbudget för röstassistenter i en annan artikel, för att visa hur bra latens ser ut för både P50- och P95-värden.
Vad orsakar latens i Conversational AI?
Latens i Conversational AI är ett samlingsbegrepp för flera olika processer, där varje del bidrar till helheten. Därför är flaskhalsen för låg latens snarare ett problem på systemnivå än något som löses genom att bara välja en bättre modell. Flera modeller samverkar trots allt i pipelinen.
För utvecklare har vi skrivit en djupgående teknisk guide om latensoptimering för röstassistenter som du kan använda för att förbättra varje steg i den kompletta tiden till första ljudet (TTFA).
Utöver kärnpipelinen bidrar även andra faktorer, som telefoni och funktionsanrop, till latens, trots att de inte ingår i modellinfrastrukturen.
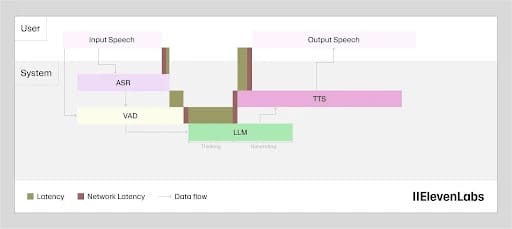
Här är en översikt över alla faktorer som bidrar till latens i Conversational AI.
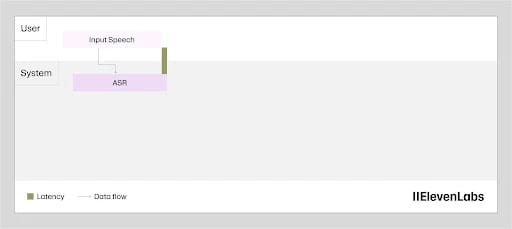
Automatisk taligenkänning
Latensen för taligenkänning är inte tiden det tar att skapa en transkription. Transkriberingsprocessen körs i bakgrunden medan användaren pratar, så när talet tar slut är texten i stort sett klar.
Latensen här är i själva verket glappet mellan när talet slutar och när transkriptionen färdigställs och skickas vidare till nästa steg. Scribe v2 Realtime minskar detta glapp till cirka 150 ms genom kontinuerlig streaming, så att outputen är klar i samma ögonblick som turen avslutas.
Turtagning och slutpunktsidentifiering
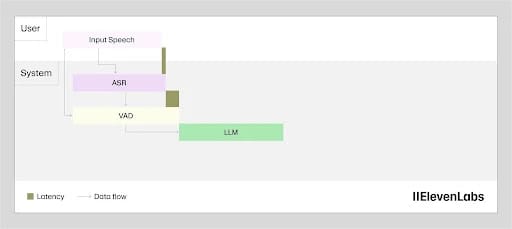
En Voice Activity Detector (VAD) finns mellan taligenkänningen och språkmodellen. Dess uppgift är att avgöra när användaren faktiskt har pratat klart.
För att undvika fel väntar VAD:en på en viss sammanhängande tystnad innan den avgör att turen är slut, och den väntan tillför latens innan språkmodellen bearbetar ett ord. Den lilla extra latensen tar visserligen tid, men förhindrar också att systemet börjar svara medan användaren fortfarande pratar.
Rent tekniskt skulle latensen från turtagning vara bra om alla andra komponenter i Conversational AI hade noll latens. Människor väntar en kort stund innan de svarar på tal. En maskin som pausar på liknande sätt gör interaktionen mer realistisk. Men eftersom andra komponenter i Conversational AI redan tillför latens är minimal latens bäst.
Språkmodellsbearbetning
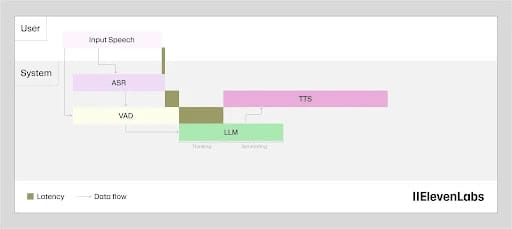
När transkriptionen är klar från Speech to Text-motorn (STT) genererar språkmodellen ett svar. Latensen här är tiden det tar att börja generera token, inte att generera hela svaret. Dessa token strömmas direkt till TTS-steget när de anländer, så TTFT är det viktigaste måttet.
Utöver modellval påverkar både promptens längd och kunskapsbasens storlek detta steg. Ju mer kontext LLM:en måste ta hänsyn till, desto längre tid tar det. När du utformar dessa system i stor skala behöver du hitta rätt balans mellan en användbar kunskapsbas och en slimmad prompt för att behålla hög hastighet.
Talsyntes
TTS-latens är tiden mellan att de första tokenen tas emot från språkmodellen och att ljudet börjar. Eftersom token anländer snabbare än mänskligt tal spelas upp väntar syntesmodellen aldrig på hela svaret. TTS-latens är enbart tiden till den första ljudbiten.
Detta steg var tidigare den enskilt största bidragande faktorn till latens i Conversational AI, eftersom äldre modeller behövde 2–3 sekunder för att börja generera tal. ElevenLabs Flash v2.5 löser detta direkt genom att leverera talsyntes med cirka 75 ms latens och minska flaskhalsen från sekunder till en bråkdel av en sekund.
Nätverkslatens
Att skicka data från en plats till en annan tillför alltid latens, och geografiskt avstånd förvärrar bara nätverkslatensen för tur och retur.
Eftersom flera komponenter samarbetar för ett komplett svar kan betydande latens byggas upp över flera uppsättningar nätverkshopp.
Funktionsanrop
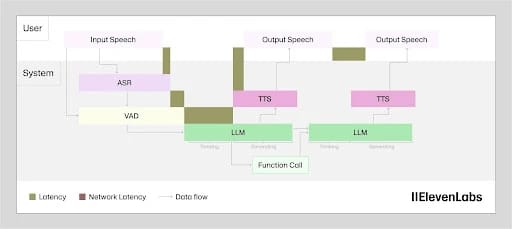
Funktionsanrop tillför API-turer och returer i LLM-steget. En snabb intern uppslagning tillför tiotals millisekunder, medan en betaltjänst eller ett lagersystem kan tillföra sekunder. Hur mycket latens som uppstår beror helt på tjänsten som anropas, vilket gör detta till det svåraste steget att optimera direkt.
Det effektivaste mönstret är att uppmana LLM:en att svara innan verktygsanropet är klart. En fras som ”Låt mig kontrollera det åt dig” håller användaren engagerad medan det externa anropet slutförs, i stället för att lämna tystnad. Röstsvar startar medan verktyget körs parallellt.
Så minskar du latens i Conversational AI
För att minska latens i Conversational AI behöver du hantera varje steg i pipelinen i ordning efter påverkan. Enskilda förbättringar påverkar visserligen latensen, men du måste arbeta med hela pipelinen som en helhet för att se den största förändringen.
Här är några principer som på en övergripande nivå kan hjälpa dig att minska latens i Conversational AI:
- Val av TTS-modell: Hastighetsoptimerade TTS-modeller som Flash v2.5 använder andra arkitekturer än kvalitetsoptimerade modeller som Eleven v3. För röstassistenter i realtid är rätt val den modell med högst kvalitet som uppfyller ditt latensmål, vilket nästan alltid är en modell optimerad för hastighet. röstassistenter
- Val av LLM-modell: Mindre och snabbare LLM:er ger vanligtvis kortare tid till första token än större modeller. Att välja den snabbaste LLM:en som fortfarande uppfyller dina kvalitetskrav för uppgiften är lika viktigt som valet av TTS-modell.
- Streaming: Med streaming-TTS returneras ljud i bitar medan syntesen pågår, så användaren hör första ordet medan modellen fortfarande genererar resten. Samma koncept gäller LLM-output: genom att börja TTS-syntesen vid första meningen medan språkmodellen genererar de följande kan du minska latensen i pipelinen.
- Systemprompt-design: Användare kan effektivisera systemprompter genom att flytta instruktioner till procedurer eller workflows, i stället för att ha dem som en del av varje beslutssteg. Det minskar mängden kontext som modellen behöver resonera kring vid varje tur.
- Skyddsräcken: Genom att köra skyddsräcken i streamingmodellen kan output börja spelas upp innan kontrollen är klar, i stället för att blockera uppspelningen tills kontrollen har slutförts.
- Samlokalisering av modeller: Genom att använda samlokaliserade modeller där det är möjligt, som ElevenLabs Agents-stacken, hålls komponenterna nära varandra så att latens inte tillkommer från hopp mellan modeller som driftas separat.
- Geografi: Kort avstånd mellan dina servrar och användarna kan minska latensen betydligt, eftersom det direkt minskar nätverkets bidrag till komplett TTFA.
Utöver dessa faktorer kan du använda den här tekniska guiden om att optimera latens för mer information.
Kom igång med Conversational AI med låg latens i ElevenAgents
Latens i Conversational AI är en mycket viktig faktor att ha i åtanke när du bygger och driftsätter agenter. Med ElevenAgents är latensoptimering inbyggd i processen. Från överlappande tekniker för att vinna tid till låg inferenslatens i enskilda komponenter bygger ElevenAgents Conversational AI-stackar med låg latens för ditt företag.
I slutändan är målet att skapa realism. Användaren ska känna att det är lika enkelt att prata med en människa, samtidigt som hen får fördelarna med ett datorprogram. Genom att effektivisera delprocesserna är detta nu möjligt.
Läs mer om ElevenAgents eller kontakta säljavdelningen för att komma igång i dag.


