Vad är RAG? Så fungerar Retrieval-Augmented Generation
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
AI-modeller genererar svar utifrån det de lärde sig under träningen. Det innebär att de inte automatiskt känner till ett företags policyer, produkter eller annan information som skapats efter träningen. RAG (Retrieval-Augmented Generation) löser detta genom att hämta relevant extern information och ge den till modellen innan den svarar.
RAG förankrar svaren från en AI i företagets faktiska dokument. En kundtjänstagent som använder RAG kan hämta den aktuella returpolicyn eller produktspecifikationen innan den svarar, vilket minskar risken för hallucinationer.
Den här guiden förklarar vad RAG innebär inom AI, hur hämtning och generering fungerar tillsammans och hur RAG skiljer sig från en fristående LLM. Vi går också igenom RAG:s begränsningar, var det fungerar bra i generativa AI-applikationer och hur RAG stöder kunskapshämtning i AI-agenter.

Sammanfattning
- RAG kombinerar ett hämtningssystem med en generativ modell, så att modellen kan använda information utöver sina träningsdata.
- Kunskapen som RAG hämtar finns utanför modellen och kan därför uppdateras utan att något behöver tränas om.
- ElevenAgents använder automatiskt RAG när en kunskapsbas är för stor för att rymmas direkt i modellens kontext. Svaren förblir snabba utan att precisionen försämras för stora och komplexa kunskapsbaser.
Vad är RAG inom AI?
RAG är en systemarkitektur som byggs kring en LLM för att förse den med extern information, såsom varumärkesriktlinjer, produktmanualer, kunskapsbasartiklar eller interna databaser. Det gör att AI kan arbeta med företagsspecifik information, så att svaren kan spegla aktuella policyer, privat kunskap och företagsuppgifter som modellen aldrig tränats på.
En LLM kan dessutom bara ta hänsyn till en begränsad mängd information åt gången, vilket kallas dess kontextfönster. En stor organisatorisk kunskapsbas kan snabbt överskrida den gränsen, så RAG håller informationen utanför LLM:en och hämtar bara de avsnitt som behövs för den aktuella frågan.
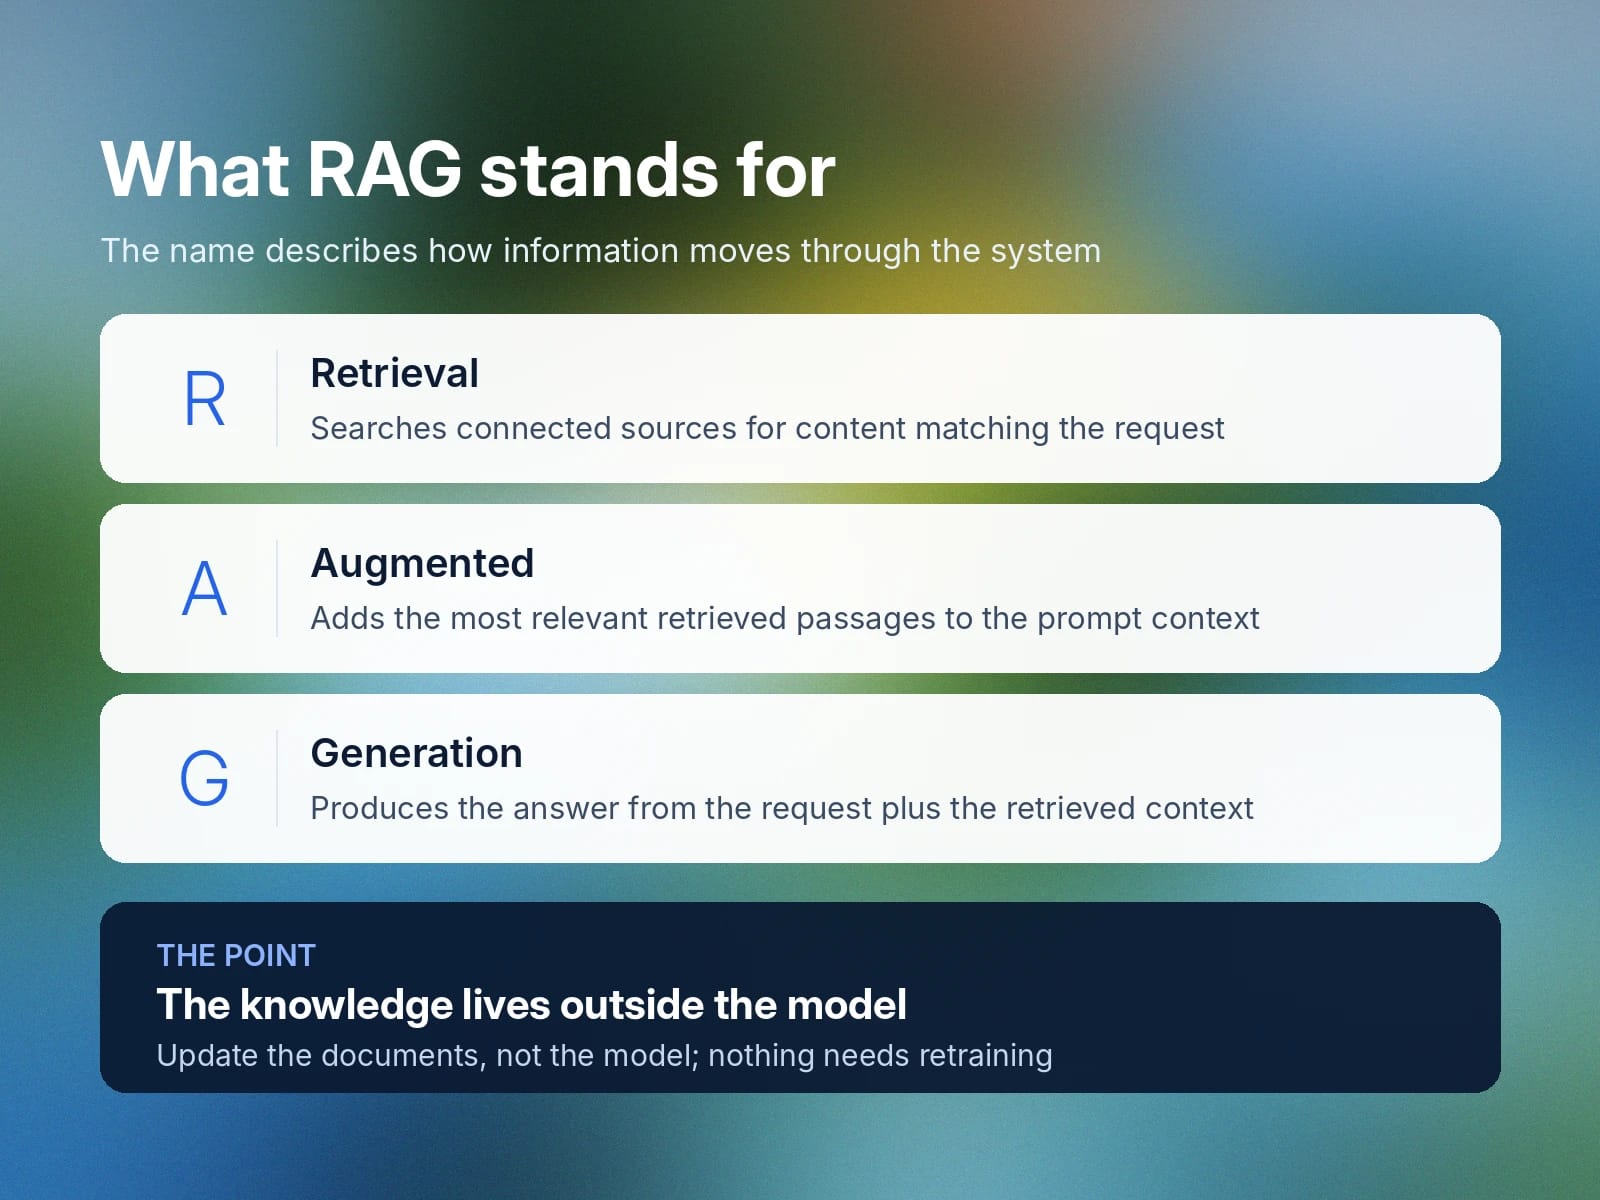
Namnet beskriver hur information rör sig genom systemet:
- Hämtning: Söker i anslutna källor, till exempel policydokument, ärendeloggar från kundtjänsten eller lagerfiler, efter innehåll som matchar användarens begäran.
- Utökning: Lägger till de mest relevanta hämtade avsnitten i promptens kontext.
- Generering: Använder användarens begäran och den hämtade kontexten för att skapa svaret.
RAG stöder också förankring, det vill säga att koppla ett AI-svar till specifik källinformation, genom att ge LLM:en relevant material att använda när den genererar ett svar. Om en kund exempelvis frågar om en garantipolicy hämtar RAG-systemet de relevanta villkoren från företagets dokumentation och ger dem till LLM:en som underlag för svaret.
Hur fungerar Retrieval-Augmented Generation?
Ett RAG-system förbereder extern kunskap för sökning, hämtar den information som är mest relevant för användarens fråga och ger den informationen till LLM:en som kontext innan den genererar ett svar.
RAG-implementeringar varierar i komplexitet. Grundläggande RAG använder en enkel process för att hämta och generera, medan mer avancerade metoder kan lägga till omskrivning av frågor, filtrering, omrangordning eller andra hämtningstekniker.
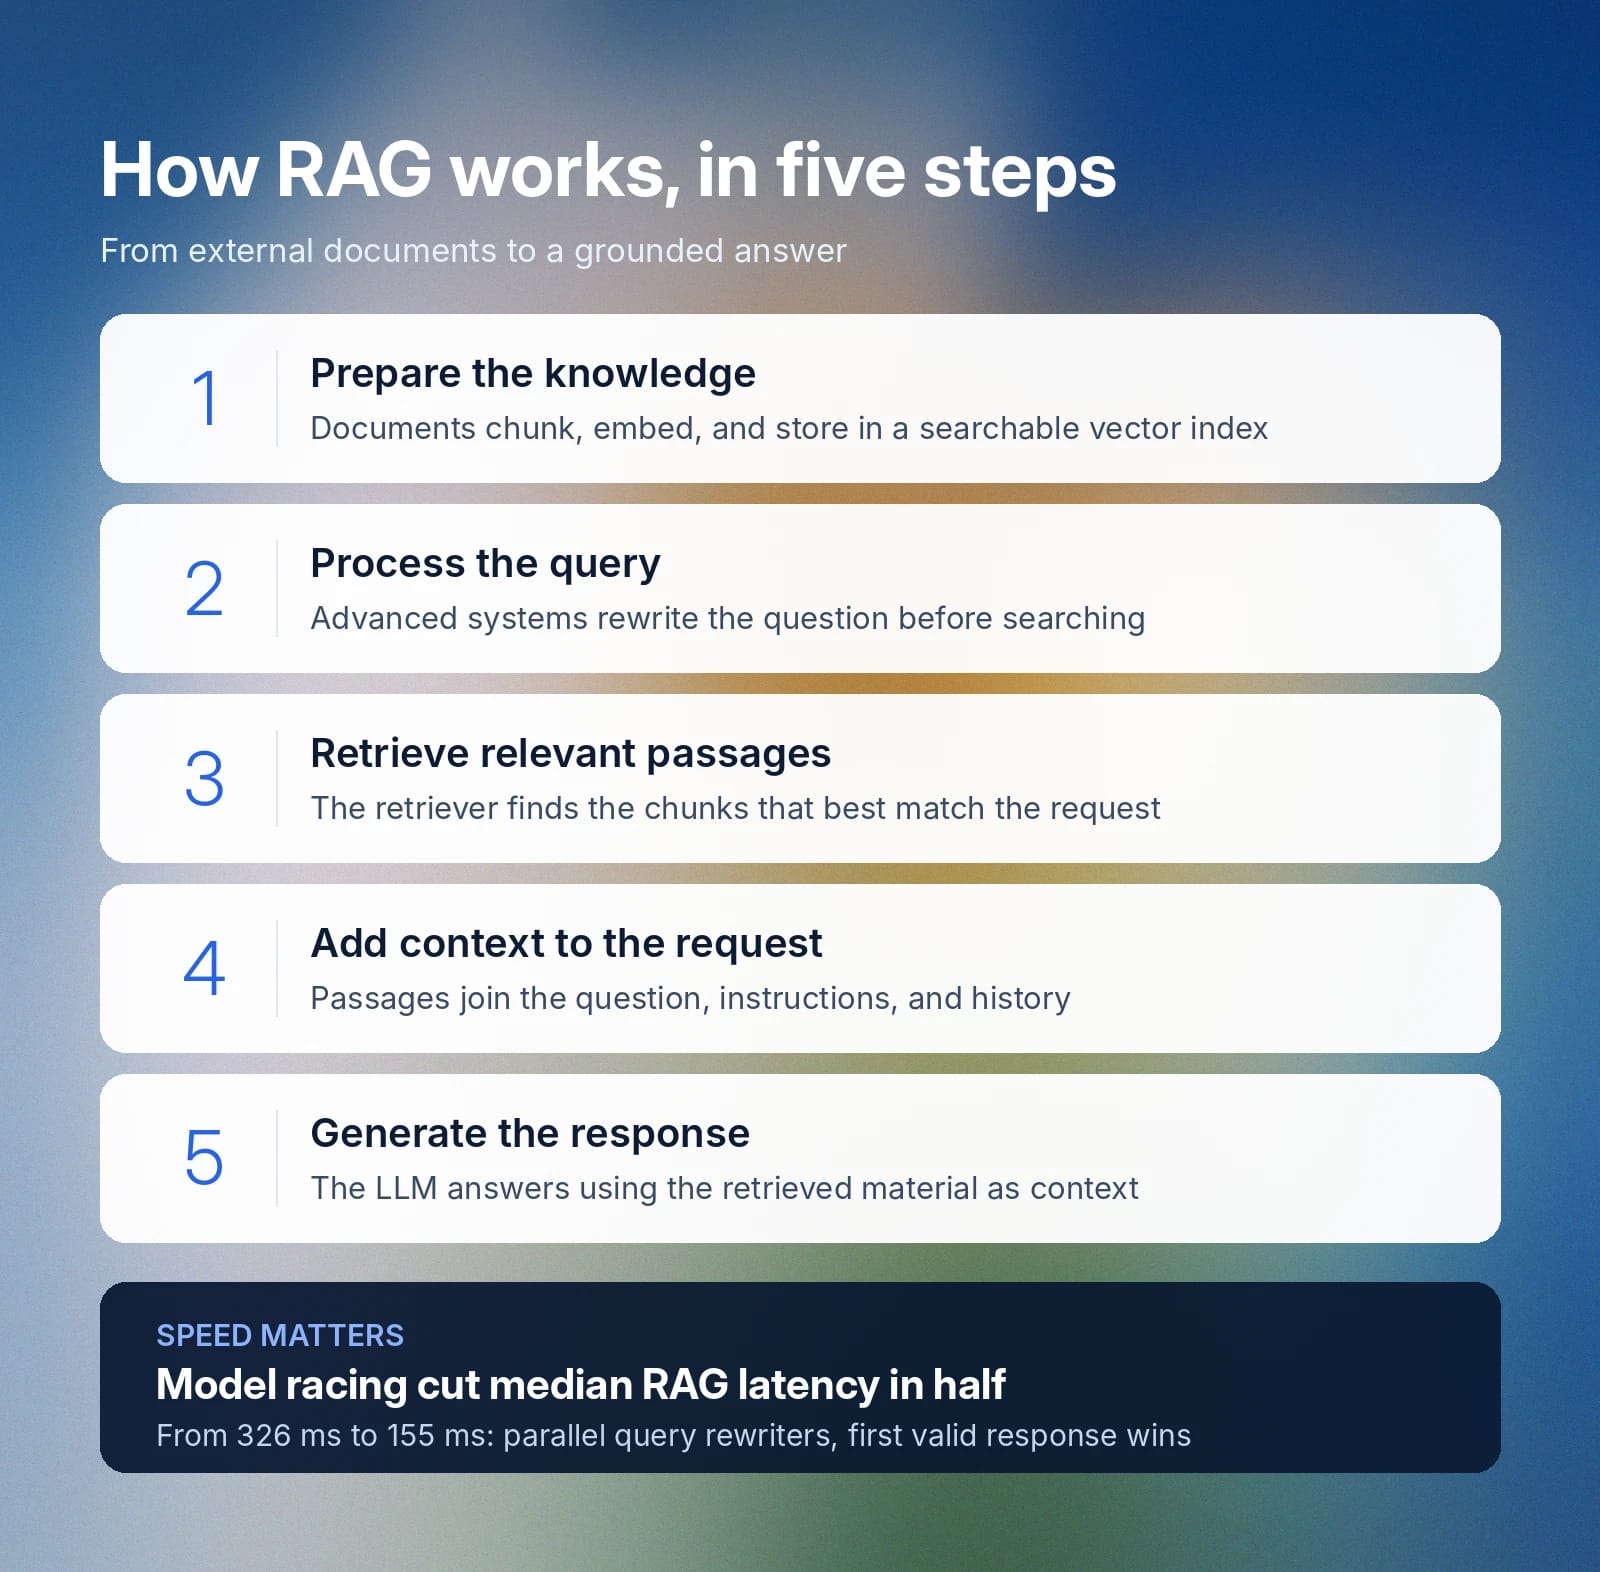
RAG-processen följer vanligtvis fem steg:
- Förbered kunskapen: Dokument delas upp i mindre avsnitt (en process som kallas ”chunking”), omvandlas till matematiska representationer som kallas embeddings och lagras i ett sökbart index eller en vektordatabas.
- Bearbeta frågan: Systemet tolkar användarens fråga och skriver i mer avancerade RAG-system om eller förfinar den före sökningen.
- Hämta relevanta avsnitt: Hämtningssystemet söker i den indexerade kunskapsbasen efter de textstycken som bäst matchar begäran.
- Lägg till kontext i modellbegäran: De utvalda avsnitten skickas till LLM:en tillsammans med användarens fråga, relevanta instruktioner och konversationshistorik.
- Generera svaret: LLM:en producerar ett svar där det hämtade materialet ingår i kontexten.
Många RAG-system aktiverar selektivt hämtning som ett externt verktyg. ElevenAgents låter team aktivera RAG för en kunskapsbas direkt i agentinställningarna, och systemet använder omskrivning av frågor för att omvandla tidigare dialog och vaga hänvisningar till en precis, fristående sökfråga vid uppföljningar i en konversation.
För att säkerställa snabba svar utvecklade ElevenLabs också en model racing-arkitektur som skickar varje fråga till flera omskrivningsmodeller parallellt och använder det första giltiga svaret. Metoden halverade medianlatensen för RAG, från 326 ms till 155 ms, vilket håller hämtningen tillräckligt snabb för att bevara ett naturligt samtalsflöde även när den utlöses av en stor kunskapsbas.
Vad är skillnaden mellan LLM:er och RAG-modeller?
En LLM är en modell som förstår och genererar språk. RAG är en arkitektur kring LLM:en som hämtar extern information när applikationen behöver den.
Det här förändras när en LLM kombineras med RAG:
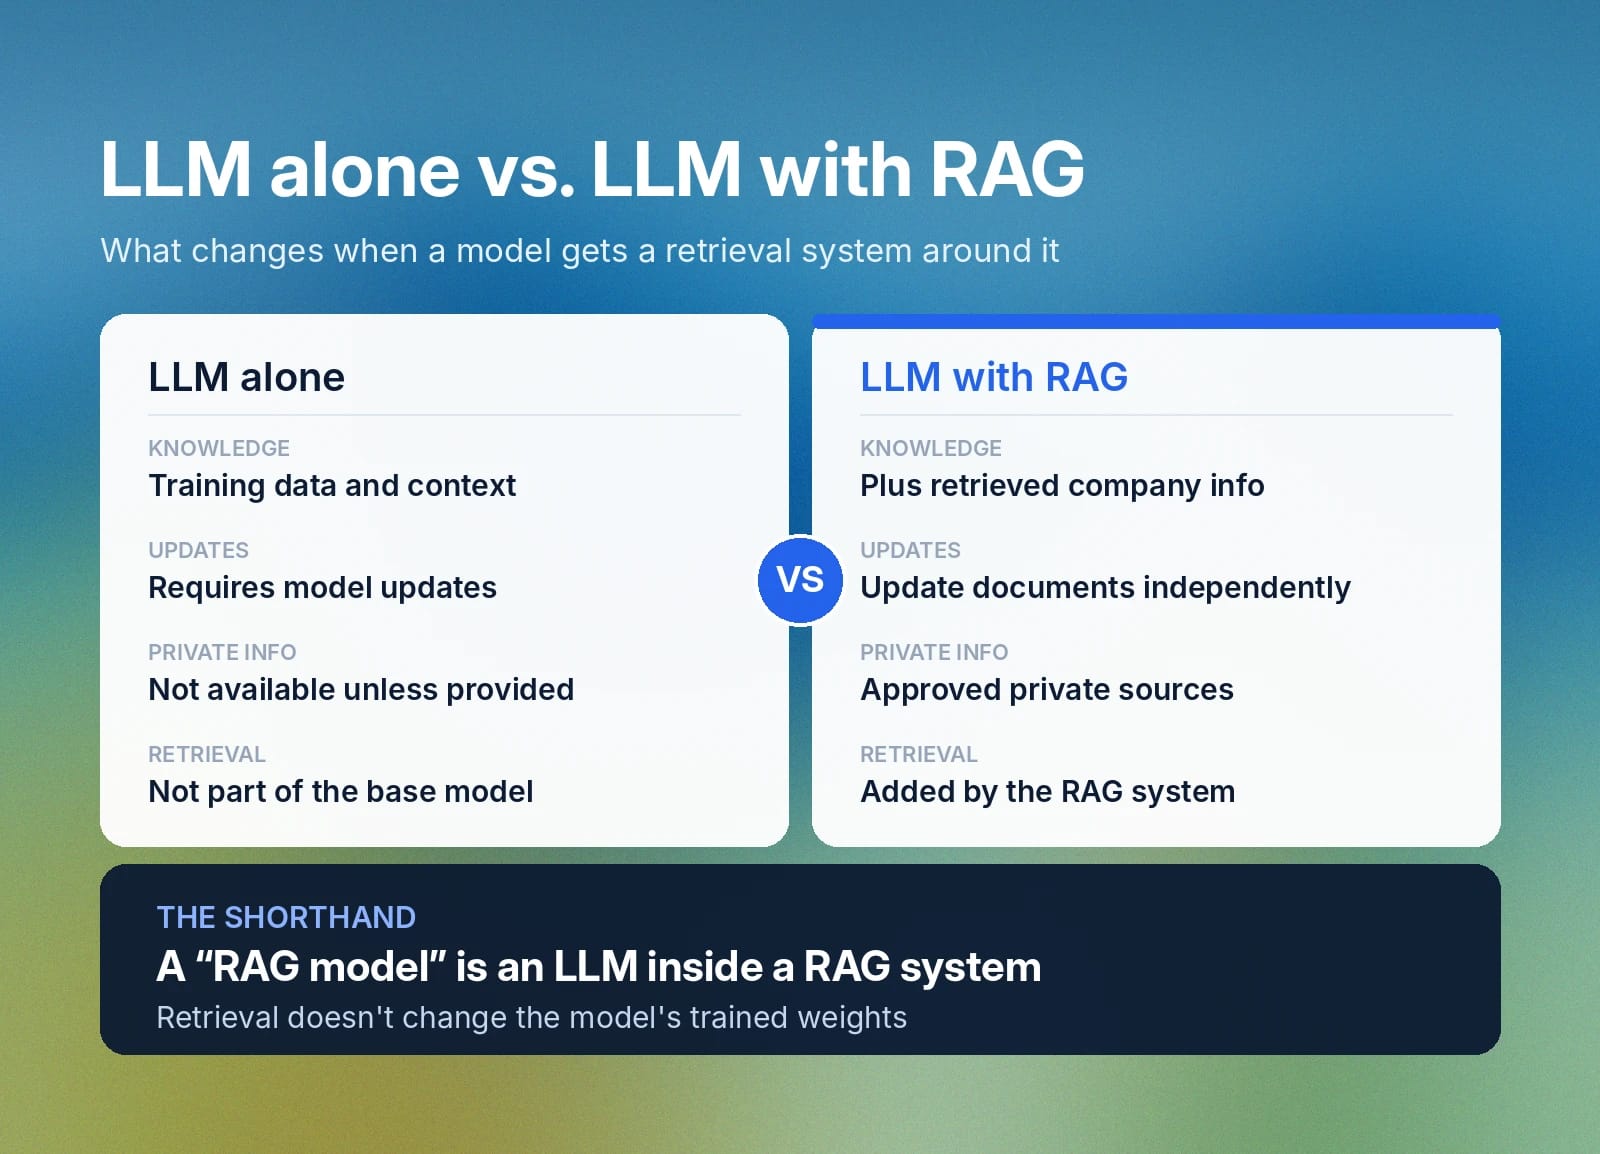
Funktion | Enbart LLM | LLM med RAG |
Kunskap | Träningsdata och aktuell kontext | Träningsdata, aktuell kontext och hämtad företagsinformation, som policyer, produktdokumentation eller innehåll från kunskapsbasen |
Uppdateringar | Ny information måste tillföras i kontexten eller genom modelluppdateringar | Extern kunskap kan uppdateras separat från modellen |
Privat information | Inte tillgänglig om den inte tillhandahålls | Kan hämta från godkända privata källor |
Hämtning | Ingår inte i grundmodellen | Läggs till av det omgivande RAG-systemet |
”RAG-modell” används ibland som en förkortning för en LLM som används i ett RAG-system. Ett företag kan till exempel säga att det använder en ”RAG-modell” för kundtjänst när den faktiska lösningen är en LLM som hämtar relevant innehåll från kundtjänsten eller policyer innan den genererar ett svar.
Begränsningar med RAG-modeller i verkliga tillämpningar
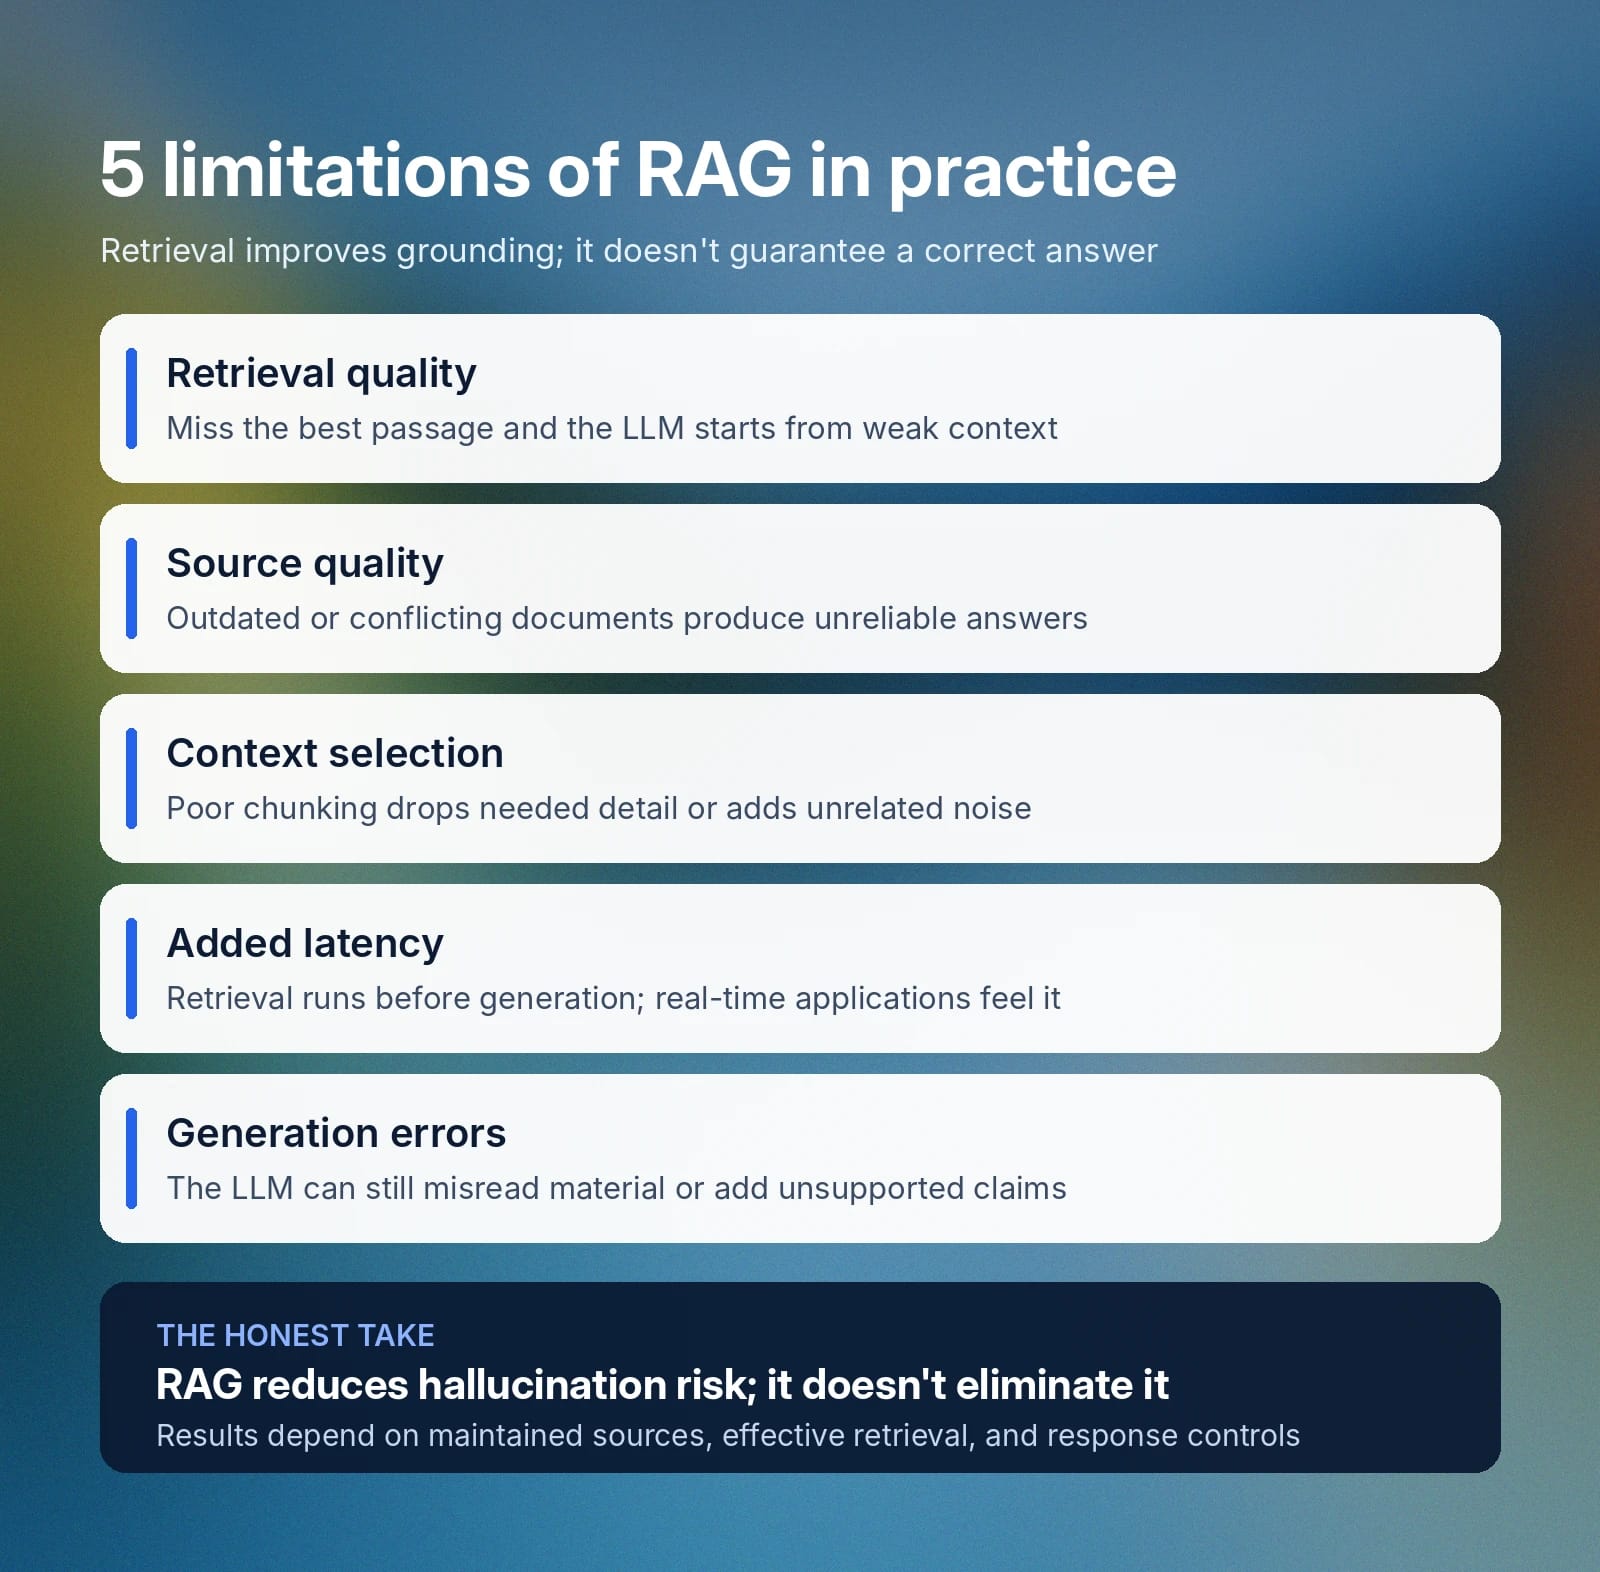
RAG förbättrar åtkomsten till relevant affärskunskap som lagras utanför LLM:en, men hämtning medför egna begränsningar och garanterar inte ett korrekt svar. De främsta begränsningarna gäller vad systemet hämtar, vad det skickar till modellen och hur modellen svarar:
- Hämtningskvalitet: Om systemet missar det mest relevanta avsnittet börjar LLM:en med ofullständig eller svag kontext. Dåligt formulerade frågor, svaga semantiska matchningar eller tvetydiga formuleringar kan alla leda hämtningen åt fel håll.
- Källkvalitet: Inaktuella, motstridiga eller ofullständiga dokument kan leda till opålitliga svar.
- Val av kontext: Bristfällig chunking eller felaktiga val vid hämtningen kan ta bort nödvändiga detaljer eller föra in orelaterad information.
- Ökad latens: Hämtning och frågebearbetning sker före genereringen, vilket kan göra svaren långsammare i realtidsapplikationer.
- Genereringsfel: LLM:en kan fortfarande misstolka hämtad information eller lägga till påståenden utan stöd.
RAG kan minska risken för hallucinationer, men eliminerar den inte helt. Korrekta resultat är fortfarande beroende av väl underhållna källor, effektiv hämtning och kontroller kring det slutliga svaret.
RAG inom generativ AI: praktiska användningsfall och fördelar
RAG är som mest användbart när en AI-applikation behöver information som ändras ofta, tillhör organisationen eller är för omfattande för att tas med i varje modellbegäran.
Här gör RAG störst skillnad:
Hålla jämna steg med information som uppdateras ofta
RAG hjälper team att hålla AI-svar i linje med aktuella produktuppgifter, priser, policyer och lagersaldon. Team kan uppdatera källinformationen oberoende, och RAG hämtar den relevanta versionen när en fråga ställs. Till exempel kan en agent för leadskvalificering hämta de senaste priserna eller planuppgifterna när den kvalificerar en inkommande uppringare.
Använda privat eller specialiserad kunskap
Viss kunskap är privat eller specialiserad snarare än offentlig, till exempel interna policyer, teknisk dokumentation eller supportinnehåll för ett specifikt team. RAG låter en agent hämta direkt från dessa källor i stället för att enbart förlita sig på det som är offentligt tillgängligt eller inbyggt i modellen.
En intern helpdesk-agent för IT eller HR kan till exempel hämta information från en HR-specifik kunskapsbas för att besvara frågor om medarbetarförmåner, i stället för att söka i offentlig dokumentation som saknar den informationen.
Söka i stora kunskapsbaser
RAG hjälper när ett företag har betydligt mer dokumentation än en LLM kan ta hänsyn till i en och samma begäran. Den hämtar bara de avsnitt som är relevanta för den aktuella frågan i stället för att skicka hela samlingen till modellen. I ett säljsammanhang kan en teknisk assistent söka i produktmanualer för att hitta relevanta krav under ett samtal.
Kom igång med ElevenAgents för avancerade RAG-lösningar
ElevenAgents ger team möjlighet att bygga AI-röst- och chattagenter som använder RAG med anslutna kunskapskällor, antingen via webbplattformen utan kod eller via API:et för team som vill bädda in agenter direkt i sina egna produkter.
För RAG-aktiverade agenter kan team lägga till dokument, URL:er eller text i en kunskapsbas och bara hämta den information som är relevant för varje fråga.
ElevenLabs har också optimerat hämtningen för realtidssamtal och minskat medianlatensen för RAG från 326 ms till 155 ms i sin ElevenAgents-arkitektur. Team som bygger med ElevenAgents får dessa hämtningsfunktioner direkt, oavsett om de konfigurerar en agent via kontrollpanelen eller bygger vidare på den via API.
Börja bygga med ElevenAgents eller kontakta vårt team för att diskutera rätt upplägg för din applikation.


