Interaktionsmodeller: Bygga naturlig dialog mellan människa och AI
- Skriven av
- Jack Limebear
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
Den som har försökt avbryta en AI-röstagent mitt i en mening vet hur det känns när ett system inte är byggt för mänskliga samtal. Rytmen är fel, rösten är frånkopplad från innehållet och även när informationen stämmer känns interaktionen fel: inte som att prata med en kunnig person, utan som att navigera i programvara som råkar använda ord.
Orsaken till den här onaturliga känslan är strukturell: många AI-röstsystem byggdes för att hantera turer, inte samtal. De lyssnar, bearbetar och svarar på ett utbyte i taget. Det fungerar för enkla demoversioner, men faller samman när samtalet blir känslomässigt och oförutsägbart.
Interaktionsmodeller är AI-system som är utformade för att kommunicera via ljud och text i realtid. De uppfattar inte bara vad som sägs, utan också när det sägs och vilken känslomässig respons situationen kräver. Den här artikeln förklarar vad som skiljer en interaktionsmodell från andra modeller, varför den är viktig för företag som använder AI-röster och hur ElevenLabs arbetar för att nå dit.
Sammanfattning
- De flesta AI-röstsystem brister i riktiga samtal eftersom de inte kan hantera avbrott, tystnad eller kontext som följer med mellan turer.
- ElevenLabs interaktionsstack är utformad för att hantera avbrott, pauser och överlappande tal utan att tappa kontexten eller bryta samtalets flöde.
- ElevenLabs arbetar mot verkliga interaktionsmodeller med en avancerad kaskadarkitektur, egenutvecklad Speech to Text (STT) och Text to Speech (TTS) samt en stack optimerad för låg latens och naturliga samtal som flyter fram och tillbaka.
Varför de flesta människa–AI-röstsamtal inte känns naturliga
De flesta AI-röstsystem behandlar ett samtal som en serie separata in- och utdata: systemet väntar på ett talblock, omvandlar det till text, bearbetar texten och svarar. Det fungerar för interaktioner med kommandon och svar, men ett verkligt samtal är inte en ren följd av textutbyten. Det är ett ständigt fram och tillbaka med pauser och inflikningar.
När flödet mellan turerna och kontexten som följer med mellan dem försvinner uppstår tre konkreta problem:
- Det avbryter dig eller får dig att vänta: Systemet kan inte skilja en tankepaus från en avslutad tur, så det antingen avbryter medan du fortfarande pratar eller blir tyst när du har slutat. Samla tankarna mitt i en mening, så blir du avbruten; avsluta din poäng, så får du vänta genom ett ögonblick av tom tystnad.
- Det kan inte reagera när det väl har börjat prata: I samma stund som systemet börjar svara slutar det lyssna. Om du avbryter för att styra om fortsätter det att ge svaret på en fråga du redan har gått vidare från, eftersom det inte kan uppfatta att något förändrats.
- Det glömmer under samtalets gång: Varje tur bearbetas isolerat, så kontexten från fem utbyten tillbaka följer inte med. Du får upprepa dig, eller så svarar systemet som om samtalet just har börjat.
Resultatet är ett samtal som kan vara funktionellt korrekt och ändå kännas fel.
Vad interaktionsmodeller kan göra som traditionell röst-AI inte kan
Där traditionell röst-AI hanterar en tur i taget driver en interaktionsmodell hela samtalet och uppmärksammar både vad som sägs och vad som behöver hända härnäst, samtidigt. Den funktionella skillnaden är att en interaktionsmodell svarar på det faktiska läget i samtalet, inte bara den senaste inmatningen.
Interaktionsmodeller har:
- Svar i realtid: Systemet är utformat för att svara i samtalstempo, med en hel cykel från början till slut som beroende på konfiguration kan ta mindre än en sekund.
- Naturlig hantering av avbrott, tystnad och överlappningar: Den skiljer en tankepaus från en avslutad tur, så den varken avbryter människor eller lämnar tom tystnad. När kunden pratar samtidigt för att styra om hanterar den överlappningen utan att tappa kontext eller få samtalet att bryta ihop.
- Kontinuitet genom hela samtalet: I stället för att återställa kontexten vid varje tur för systemet samtalets historik vidare, så att det som sägs i tur 10 återspeglar allt som har hänt sedan tur ett.
- Anpassad leverans: Rösten kan programmeras för att ändras – lugnare, mer direkt eller mer betryggande – beroende på vilken typ av uppgift den utför.
- Parallell uppgiftskörning: Systemet hämtar information, kör verktygsanrop och fortsätter prata samtidigt, i stället för att bli tyst medan det letar upp något.
Det verkliga testet för en interaktionsmodell är ett samtal som går dåligt. I inspelningen nedan ringer en kund om en inställd flygning. Kunden är spänd och behöver snabbt få sitt problem löst.

Agenten uppfattar omedelbart kundens brådska och frustration utifrån orden kunden använder. Den anpassar tonen, hanterar avbrottet utan att tappa tråden och använder sina anslutna verktyg för att erbjuda verkliga lösningar på den inställda flygningen. Till slut får kunden en lösning utan att behöva en mänsklig agent.
Jämför det med de typiska turbaserade agenter som används i dag. De här systemen skulle vänta vid varje paus, svara utifrån ett neutralt grundläge och helt missa kundens frustration. Efter några utbyten som inte bemöter vad uppringaren faktiskt känner skulle samtalet troligen behöva lämnas över till en människa, vilket gör kunden mer frustrerad än från början.
Så arbetar ElevenLabs mot interaktionsmodeller
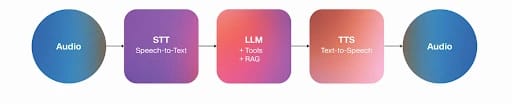
Vår samtalspipeline använder en avancerad kaskadarkitektur i stället för en sammanslagen arkitektur. Det innebär att varje steg är en egen specialiserad komponent, i stället för att en enda modell hanterar allt.
Fördelen med det här arbetssättet är att vi kan optimera varje steg i pipelinen oberoende av de andra och byta till en bättre modell för valfri komponent utan att bygga om hela systemet. Eftersom vi utvecklar komponenterna själva samoptimeras de för att överföra rik kontext till varandra, inte bara data. Det innebär att pipelinen fortfarande fungerar som ett sammanhängande samtal, snarare än en kedja av separata verktyg.
Struktur för kaskadmodell
Struktur för sammanslagen modell
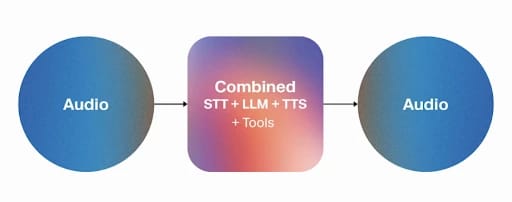
Bilder: Kaskadmodeller jämfört med sammanslagna modeller
Här är tekniken som för närvarande utgör pipelinen:
- Scribe v2 Realtime: Vår egenutvecklade STT-modell transkriberar tal på omkring 150 ms på över 90 språk och klarar bakgrundsljud, accenter, avbrott och icke-verbala händelser som skratt och pauser. Den är även byggd för att hantera branschspecifik vokabulär, från medicinska termer till finansiell jargong.
- Spekulativ turhantering: Det här systemet avgör när det ska prata, pausa eller vänta genom att tolka samtalets flöde i stället för att förlita sig på en fast tystnadströskel. Förbättringar i vår modell för röstaktivitetsdetektering hjälper den att bättre filtrera bort bakgrundstal och korta svar, vilket gör turhanteringen mer naturlig.
- Eleven v3 Conversational: Vår mest uttrycksfulla TTS-modell, byggd för direkta dialoger fram och tillbaka. Den för vidare samtalets känslomässiga ton mellan turerna, så att agentens sätt att uttrycka sig i tur 10 återspeglar allt som kom före, inte bara det senaste svaret.
- Expressive Mode: Byggd på Eleven v3 Conversational och systemet för turhantering, Expressive Mode styr hur agenten låter i stunden – lugnande när kunder är frustrerade, betryggande när de är förvirrade och direkt när tydlighet behövs. Den läser också uttryckstaggar, så modellen kan agera på signaler som [laughs], [whispers] eller [sighs] för att forma specifika delar av leveransen.
- Flash v2.5: Vår TTS-modell med låg latens har stöd för 32 språk och genererar tal på under 75 ms. När låg latens är viktigast håller den svarstiden inom ramen för en naturlig mänsklig rytm.
- Speech Engine: Det sammanlänkande lagret som binder ihop stacken och kopplar din server till vår ElevenAPI via WebSocket, med en anslutning per samtal. Vi hanterar STT och TTS medan din server kör LLM:en, så tekniska team kan använda sin egen modell och behålla samtalslogiken i sin egen infrastruktur.
De här modellerna förbättras ständigt och nya versioner släpps regelbundet. Varje ny version minskar avståndet mellan att prata med programvara och att prata med en person, med snabbare svar, bättre känsloigenkänning, fler språk och jämnare leverans.
Prata medan den tänker
Alla delar av en interaktionsmodell behöver inte köras i en strikt följd. ElevenAgents kan fortsätta arbeta i bakgrunden medan samtalet pågår, i stället för att bli tyst mellan en fråga och ett svar.
Några centrala system samarbetar för att möjliggöra att prata och tänka samtidigt:
- Parallella verktygsanrop: Agenten kan fråga en databas, köra ett verktyg eller kontrollera en orderstatus medan den fortfarande pratar, så att informationshämtning aldrig känns som en tom paus i samtalet.
- Mjuk timeout: Om en LLM tar längre tid än väntat på sig att skapa ett svar säger agenten en kort utfyllnadsfras som ”Låt mig tänka” eller ”hmmm” i stället för att lämna en obekväm tystnad. Mjuk timeout hjälper till att behålla ett naturligt samtalsflöde och minskar risken för avbrott.
- Termer som ignorerar avbrott: I stället för att använda en fast tystnadströskel försöker systemet tolka innebörden i det som sägs för att avgöra när en tur faktiskt är avslutad. På samma sätt kan korta bekräftelser som ”okej” eller ”mm-hmm” konfigureras för att passera utan att utlösa ett fullständigt avbrott, vilket innebär att agenten inte tappar tråden varje gång uppringaren flikar in.
Tillsammans ser de här systemen till att agenten inte känns som om den buffrar eller laddar ett svar. De bildar en effektiv samtalsmotor som naturligt fyller mellanrummen på samma sätt som en person skulle göra, samtidigt som den bearbetar information och samlar tankarna i bakgrunden.
Så fungerar ett samtal med ElevenLabs i praktiken
Komponenterna ovan körs inte efter varandra i en prydlig rad. De överlappar. Så här skulle en agent från ElevenLabs hantera en uppringare som frågar: ”Har min beställning skickats än, eller behandlas den fortfarande?” mitt under ett supportsamtal.
- Uppringaren talar: Ljud strömmas till ElevenLabs via WebSocket-anslutningen och Scribe börjar transkribera i realtid, omkring 150 ms efter rösten.
- Systemet läser flödet: Medan Scribe fortfarande transkriberar bedömer den spekulativa turhanteringen redan om uppringaren har pratat klart eller är mitt i en tanke. Avslutningen ”eller behandlas den fortfarande?” tolkas som en överlämning snarare än en paus, så den utlöser nästa steg i stället för att vänta i tystnad.
- LLM:en samlar kontext och svarar: Den transkriberade frågan skickas till LLM:en tillsammans med samtalshistoriken, orderuppgifterna som hämtats från företagets egna system via RAG, resultat från verktyg som använts tidigare i samtalet och systemprompten. Den resonerar utifrån allt detta och skapar ett svar som bygger på uppringarens faktiska beställning, inte ett generiskt statusmeddelande.
- Eleven v3 syntetiserar svaret: Texten blir naturligt ljud. Om Expressive Mode är aktivt får svaret uttryckssignaler som passar situationen, så att en rutinuppdatering låter lugn och avslappnad i stället för platt. När låg latens är viktigast hanterar Flash syntesen på under 75 ms.
- Svaret strömmas tillbaka: Ljudet börjar spelas upp innan syntesen är klar, så uppringaren hör början av svaret medan resten fortfarande genereras.
- Cykeln upprepas: Varje ny tur för samtalets ton, kontext och historik vidare.
Genom den här snabba processen känns samtalet naturligt. Uppringaren slutar anpassa sig till maskinen: personen saktar inte ner, överartikulerar inte och väntar inte på en signal. Personen pratar bara, på samma sätt som med en människa.
Driftsätt naturligt låtande röstagenter i hela företaget
Allt som beskrivs här används i produktion i dag, inte bara på en roadmap. Från kaskadarkitekturen till pipelinen med svar på under en sekund använder företag över hela världen redan ElevenAgents för att hantera verkliga kundsamtal i stor skala.
Det gäller även reglerade miljöer med höga krav, eftersom vår agentarkitektur har stöd för skyddsräcken, revisionsloggar och kontroller för regelefterlevnad. ElevenLabs är certifierat enligt SOC 2 Type II, ISO 27001, HIPAA och PCI DSS Level 1, med Zero Retention Mode och regional datalagring för team som behöver hålla data inom en viss gräns.
Redo att sätta en agent i arbete? Du kan skapa en agent och börja bygga i konsolen, eller prata med vårt säljteam om en driftsättning anpassad till din miljö.