Praktisk guide: agentramverk med öppen källkod och ElevenAgents
- Skriven av
- Akhil Chauhan
- Publicerad
- Senast uppdaterad
LyssnaLyssna på den här artikeln
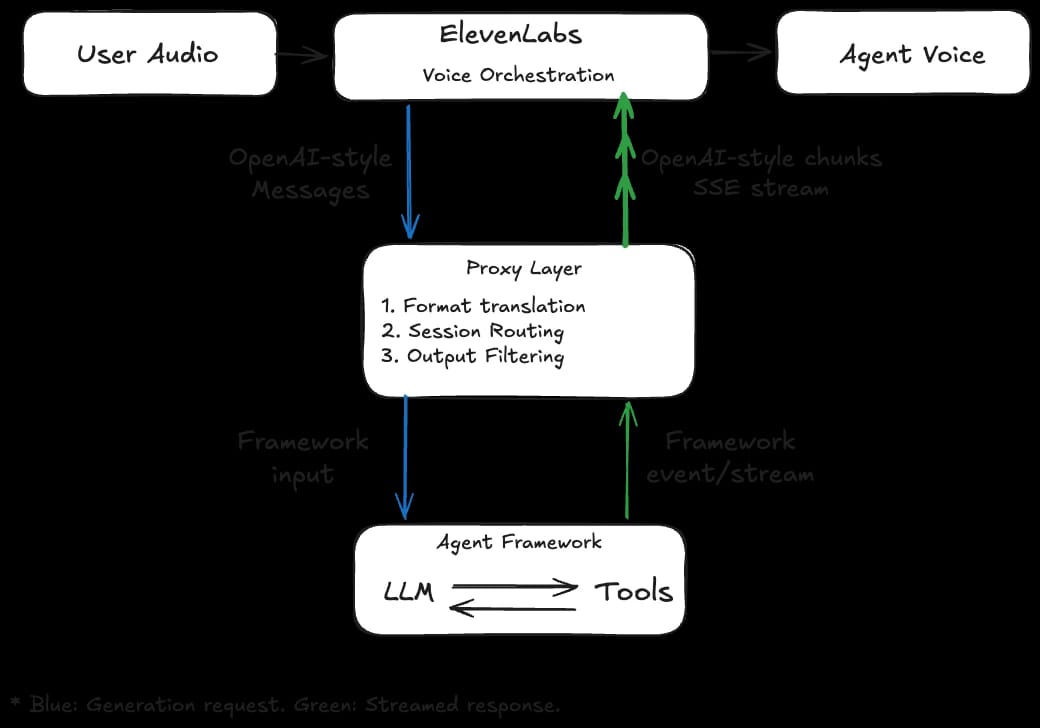
I vårt tidigare inlägg om att integrera externa agenter med ElevenLabs Voice Orchestration, beskrev vi hur team kan ansluta sin befintliga textbaserade agentorkestrering till ElevenLabs via Custom LLM. Med den grunden visar den här guiden hur ledande agentramverk med öppen källkod kan anpassas och driftsättas bakom Custom LLM-gränssnittet. Resultatet är en flexibel arkitektur där röst läggs ovanpå etablerade agentsystem utan att kompromissa med tillståndshantering, verktygsorkestrering eller applikationsspecifik kontroll. Oavsett ramverk följer vi samma trestegsmönster: skapa en genereringsbegäran, extrahera det slutliga textsvar och formatera om det i ett OpenAI-kompatibelt Server-Sent Events-format (SSE). ElevenLabs har stöd för både Chat Completions och Responses-formaten. Även om den här guiden omfattar fyra välanvända ramverk går mönstren att tillämpa på alla runtime-miljöer som kan skapa OpenAI-kompatibel strömmande output.
Allmän konfiguration
Exemplen i det här avsnittet använder Python och FastAPI, men valfri stack som hanterar HTTP POST-begäranden och strömmande SSE-svar fungerar. När ElevenLabs röstorkestrering upptäcker ett sannolikt turavslut skickar den en genereringsbegäran till den konfigurerade Custom LLM-slutpunkten. I det här avsnittet går vi igenom kärnkomponenterna i översättningslagret – bryggan eller proxyn som får röstorkestreringen och agentramverket att tala samma språk.
Olika kunder kan förståeligt nog välja olika ramverk, antingen av vana eller för att ramverket fyller ett specifikt syfte. LlamaIndex utvecklades till exempel ursprungligen för att göra det enklare att konfigurera Retrieval-Augmented Generation (RAG), medan CrewAI byggdes för att automatisera definierade uppgifter i agenternas era. Olika designmål ger olika svarsstrukturer, och varje struktur kräver särskild hantering. Att strömma delar medan LLM:en genererar dem, i stället för att vänta på en komplett tur, är avgörande eftersom det gör att Text-to-Speech-modellen (TTS) kan börja generera tal tidigare och därmed minska den upplevda latensen. Vi fokuserar på fyra populära ramverk: LangGraph, Google ADK, CrewAI och LlamaIndex.
En kommentar om delad kod
Varje ramverk måste strömma svar som OpenAI-kompatibla SSE-delar. Vi introducerar en liten hjälpfunktion som används i samtliga exempel för att skapa dessa delar.
Med den grunden på plats börjar vi med LangGraph.
LangGraph
LangGraph modellerar agenter som grafer, där noder representerar enskilda steg och kanter definierar kontrollflödet mellan dem. Minsta möjliga konfiguration är enkel: initiera en chattmodell, definiera agentverktyg och skapa runtime-miljön för agentgrafen.
För varje genereringsbegäran tar LangGraph Agent emot hela konversationshistoriken, vilket gör att den kan behålla det nödvändiga tillståndet internt. LangGraph har stöd för beständig lagring på serversidan via Checkpoints, men för att hålla implementeringen minimal tar vi inte upp dem här.
När tillståndshanteringen är klar är nästa LangGraph-specifika val strömningsläge. LangGraph erbjuder två alternativ, vart och ett för olika användningsfall:
- stream_mode="values" ger ögonblicksbilder av graftillståndet. Det är enklare att implementera men inkluderar ett mer fullständigt meddelandetillstånd i varje svar, vilket ökar latensen i konversationsflöden i realtid.
- stream_mode="messages" strömmar inkrementella meddelandedelar från modellen. Det är vanligtvis att föredra för röstinteraktioner i realtid eftersom det minskar tiden till första ljudet i ElevenLabs orkestreringslager.
Mer specifikt innehåller meddelandeimplementeringen av agentloopen mellanliggande steg, till exempel uppdateringar för verktygsanrop, som inte bör läsas upp. Proxyn filtrerar bort dem och skickar endast svarstext för användaren till TTS-lagret. Här är ett exempel på en tur med verktygsanrop.
[1] Modellen beslutar att anropa ett verktyg (tool_calls=["get_price"])[2] Verktyget körs och returnerar data (result="$24.99") [3] Modellen skapar ett svar med resultatet (content="Det kostar $24.99")
Naturligtvis ska endast delarna från steg 3 vidarebefordras i SSE-strömmen. I praktiken hanterar två kontrollvillkor filtreringen i strömningsslingan: ett som bara behåller händelser där langgraph_node == "model", och ett som hoppar över tomt innehåll. Tillsammans säkerställer de att endast användarvänd assistenttext skickas vidare till ElevenLabs som SSE. Med dessa koncept på plats kan vi skapa en lättviktig implementation av begärandeproxyn.
Detta säkerställer att endast modellsvar för användaren skickas vidare till ElevenLabs. Eftersom LangGraph visar sin interna verktygskörning via tillståndsströmmen är filtreringen explicit och styrs av proxyn.
Härnäst går vi in på detaljerna i att arbeta med Googles Agent Development Kit (ADK)
Google ADK
Googles ADK abstraherar runtime-loopen bakom några centrala primitiver: Agent, Runner och SessionService. ADK:s Runner ligger mellan HTTP-lagret och agentdefinitionen. Den hanterar meddelanderoutning, verktygsorkestrering, sessionslivscykeln och händelseströmning.
När agenten, sessionsbackend och runner har initierats hämtar eller skapar proxyn en ADK-session för varje inkommande begäran. I ADK styr session_id beständig minneslagring: om samma session_id återanvänds mellan turer följer historik, verktygsanrop och tidigare svar automatiskt med. Eftersom konversationens identitet finns uppströms i ElevenLabs hanterar proxyn denna mappning explicit. Genom att skicka rätt identifierare för genereringsbegäran kan SDK:t hantera tidigare kontext internt. Vi skickar den godtyckliga identifieraren när konversationen initieras via extra parametrar som skickas i begärans body.
När meddelandet och sessionen är förberedda kan runnern anropas. Verktygsanrop och verktygsresultat visas fortfarande som interna ADK-händelser under körningen, men de behandlas som mellanliggande orkestreringssteg snarare än användarvänd output. Därför behövs inget manuellt filter, till skillnad från ramverk där verktygsanrop visas som text för användaren.
Hanterningen nedan är en förenklad implementation där sessionsuppslagning och get-or-create-logik ingår direkt i koden.
Härnäst tittar vi på CrewAI, som till sin utformning är mer uppgiftscentrerat.
CrewAI
CrewAI utformades för att orkestrera fleragentarbetsflöden kring strukturerade uppgifter (research, skriva, sammanfatta), snarare än öppna dialogloopar. Agenter definieras med en roll, ett mål och en bakgrundshistoria. Körningen kretsar kring Task-objekt, vart och ett med en tydlig beskrivning och förväntad output.
Till skillnad från agentloopmodellen i LangGraph och ADK skapar CrewAI vanligtvis Task och Crew per begäran för att definiera arbetsenheten för den turen i konversationen. Vi tar med konversationskontext genom att injicera tidigare turer i nästa uppgift via en platshållare. Variabeln {crew_chat_messages} fylls för varje begäran med den löpande konversationshistoriken och interpoleras sedan i uppgiftsbeskrivningen vid körning. Vi vill också skapa ren text som är klar för tal, genom att uttryckligen filtrera bort mellanliggande spårningsmönster (Thought, Action, Action Input, Observation) och endast skicka ut den slutliga svarstexten.
Hanterningen nedan kombinerar skapande av uppgifter per begäran, interpolering av historik, strömning på Crew-nivå, filtrering av spårning och formatering av output.
Härnäst tittar vi på LlamaIndex, som väljer en annan väg med fokus på en inbyggd händelsestyrd strömningsmodell.
LlamaIndex
Till skillnad från de andra ramverken i det här inlägget utformades LlamaIndex för att koppla LLM:er till externa datakällor (dokumentlager, index, hämtningspipelines). Dess agentlager, FunctionAgent, bygger på den grunden för att hämta och resonera över strukturerad kontext, snarare än för öppna dialoger eller uppgiftskörning.
För att bevara kontinuiteten i konversationen omvandlar proxyn inkommande meddelanden till LlamaIndex-chattmeddelanden och delar sedan upp dem i den senaste användarturen (user_msg) och tidigare turer (chat_history). Fältet event.delta i varje AgentStream-händelse innehåller nästa textfragment, vilket direkt motsvarar en delta.content-del i OpenAI-stil. Icke-tomma deltan kan vidarebefordras som de är, vilket gör detta till guidens mest direkta strömningsbrygga. Strömmen innehåller både orkestreringshändelser (verktygsanrop, resultat) och talhändelser (assistentens textdeltan). För att hålla röstoutputen ren behåller proxyn endast AgentStream-händelser och hoppar över tomma deltan.
[1] AgentStream (delta='') ← ignoreras[2] ToolCall ← ignoreras[3] ToolCallResult ← ignoreras[4] AgentStream (delta='Det') ← vidarebefordras ✓[5] AgentStream (delta=' kostar') ← vidarebefordras ✓[6] AgentStream (delta=' $49.99')← vidarebefordras ✓
Den här separationen håller mellanliggande verktygsmekanik borta från talad output samtidigt som inkrementellt tal med låg latens bevaras. Drop-in-hanteringen nedan samlar dessa steg.
LlamaIndex är mindre styrande kring heltäckande mönster för konversationsruntime än ramverken med mer omfattande inbyggda orkestreringslager. I produktionsdriftsättningar behöver kunder därför vanligtvis implementera sessionshantering, skyddsräcken för svar, verktygsorkestrering och spårning.
Slutsats
Varje ramverk i den här guiden ansluter till ElevenLabs genom samma kontrakt: ta emot en Completions- eller Responses-begäran i OpenAI-stil och strömma tillbaka SSE-delar. Det gör att team kan lägga röstorkestrering ovanpå en befintlig agentimplementation med minimala ändringar och därmed bevara det de redan har byggt, samtidigt som de får tillgång till konversations-AI i realtid konversations-AI. Denna modularitet är en grundprincip för ElevenAgents-plattformen. Oavsett om organisationer utökar en befintlig agent eller bygger röstbaserat från början är ElevenAgents röstorkestrering byggd för att möta dem där de är.
Om du redan kör en agent med ett ramverk med öppen källkod och vill aktivera röst kan du prova det här tillvägagångssättet och berätta vad du tycker.