Vad är röstaktivitetsdetektering och hur fungerar det?
- Skriven av
- Jack Limebear
- Publicerad
LyssnaLyssna på den här artikeln
Röstaktivitetsdetektering avgör om korta ljudramar på millisekunder innehåller mänskligt tal. Den används i många tillämpningar för digital ljudbearbetning, bland annat transkribering, telefoni och röstassistenter.
I den här artikeln går vi igenom vad röstaktivitetsdetektering gör, vad den inte gör och hur den passar in i viktiga företagsapplikationer.
Sammanfattning
- Röstaktivitetsdetektering (VAD) är en grundläggande del av moderna ljudflöden. Den analyserar kontinuerligt en ljudström och ger ett ja- eller nejbesked om mänskligt tal finns i varje ljudram på millisekundnivå.
- VAD talar om för efterföljande ljudverktyg när de ska köras och när de ska vänta. Det används av LLM:er, transkriberingstjänster och som del av andra ljudflöden för företag.
- Algoritmer för röstaktivitetsdetektering körs i en kontinuerlig loop med fem steg: fånga upp ljud, dela in det i ramar, extrahera röstegenskaper, bedöma sannolikheten för tal och skicka ett beslut till efterföljande tjänster.
- VAD byggde ursprungligen på rent matematisk signalbehandling för att avgöra om tal fanns eller inte. Moderna AI-baserade system använder neurala nätverk för samma funktion, men med bättre kontextuell förståelse av bakgrundsbrus och semantiska signaler.
- VAD-system klassificerar bara om en ljudram innehåller tal. De talar inte om när någon har pratat klart. Endpointing-system använder VAD och andra heuristiska analysverktyg för att avgöra om en talare har avslutat sin tanke.
- I företagsmiljöer hjälper VAD röstassistenter att prata naturligt med kunder utan att avbryta dem, optimerar användningen av VoIP-bandbredd, håller kostnaderna för AI-transkribering från tal till text (STT) nere och har andra användningsområden.
- Testa VAD-system under verkliga förhållanden. Perfekta studioupptagningar är inte ett effektivt sätt att avgöra vad systemen klarar av.
Vad är röstaktivitetsdetektering (VAD)?
Röstaktivitetsdetektering (VAD) är en mjukvaruprocess som avgör om små ljudsegment, så kallade ramar, innehåller tal. VAD-algoritmer körs från dussintals till hundratals gånger per sekund på en ljudström och returnerar ett binärt ”ja” eller ”nej” beroende på om de upptäcker tal.
De används i bredare digitala ljudflöden, till exempel telekommunikation eller taltranskribering. De talar om för andra efterföljande system, som ASR/STT, LLM:er och turplanerare, om de aktivt ska lyssna på ljudströmmen eller vänta.
VAD är inte samma sak som automatisk taligenkänning (ASR). Allt ett VAD-system gör är att ge ett sannolikhetsbaserat ja- eller nejbesked om huruvida det upptäcker tal. Det ger inte ut faktiska ord. Dess huvudsakliga funktion är att tala om för efterföljande system om de ska bearbeta en viss ljudram.
Hur fungerar algoritmer för röstaktivitetsdetektering?
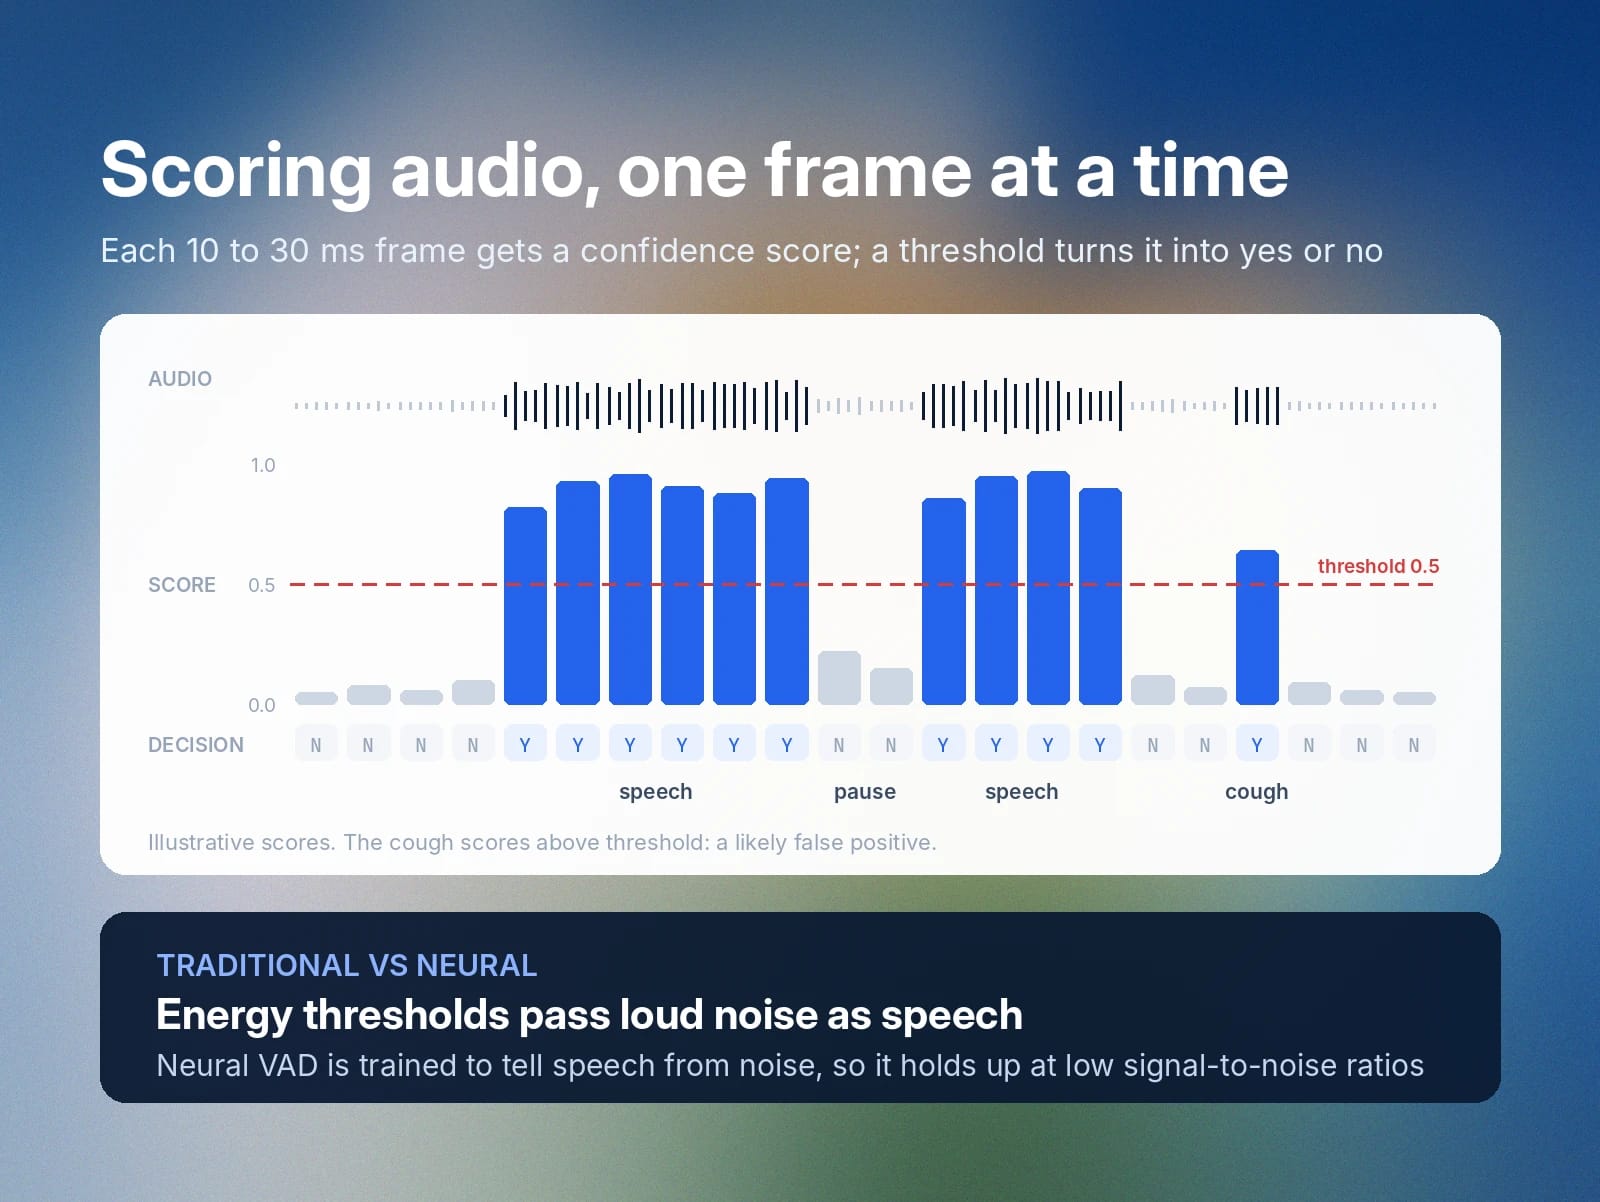
En VAD-algoritm körs på en ljudström och fattar ett ja- eller nejbeslut om huruvida en viss ljudram, vanligtvis 10–30 millisekunder lång, innehåller tal.
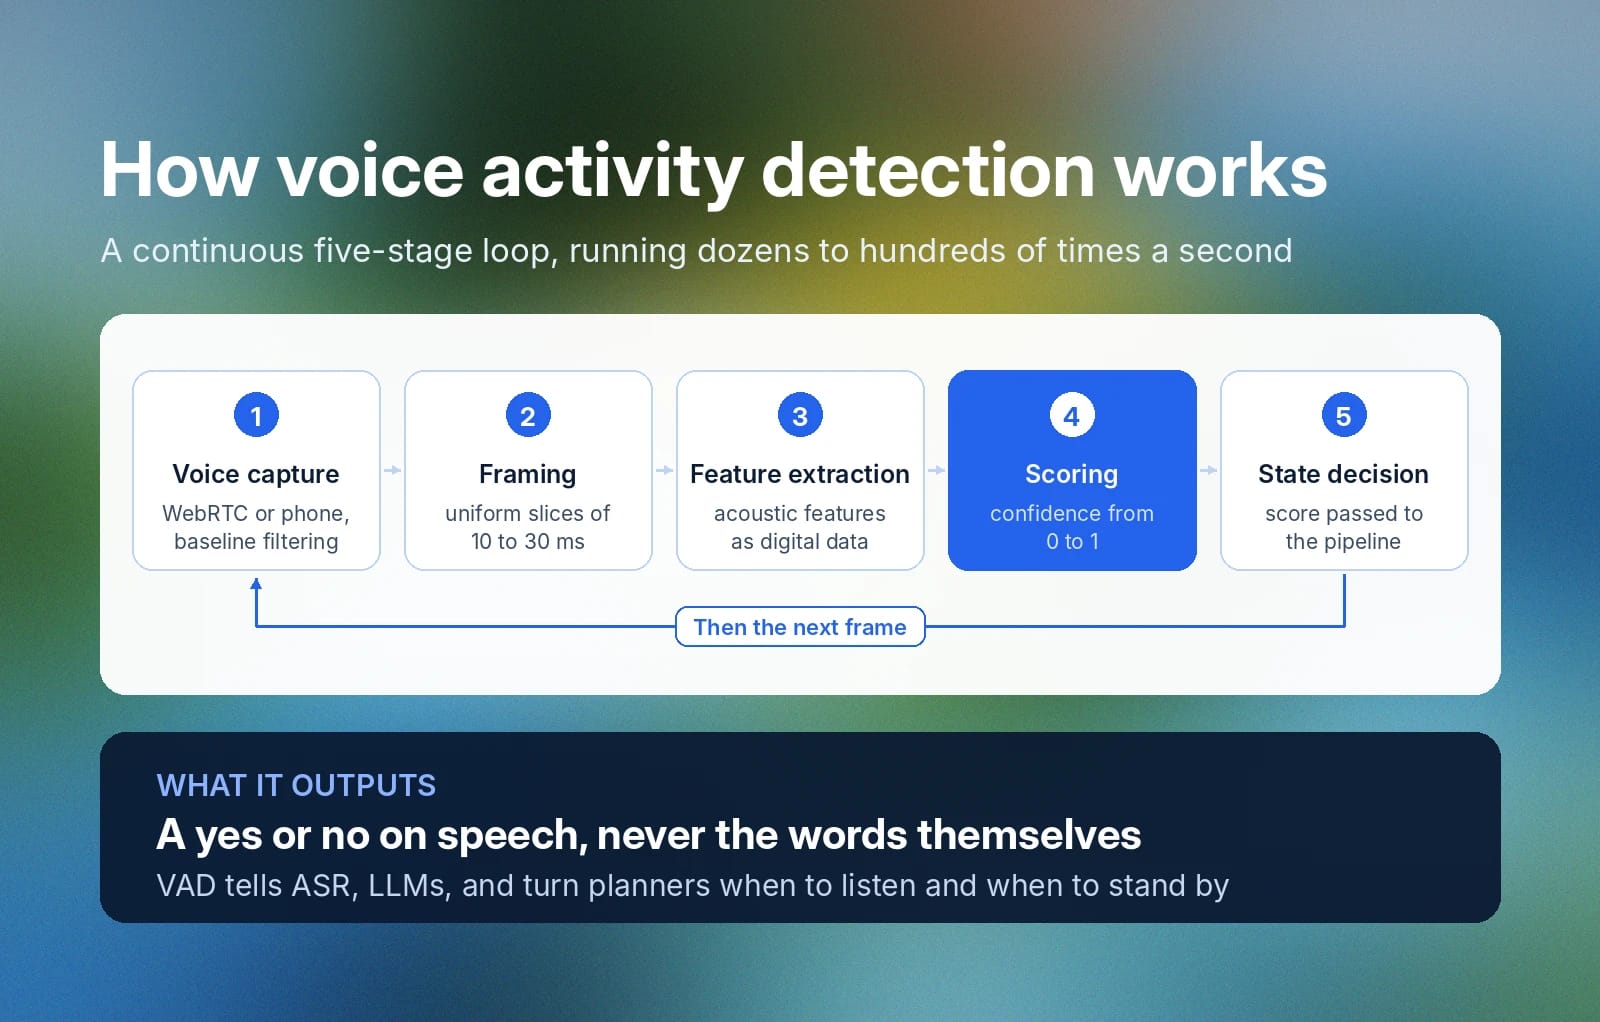
De arbetar kontinuerligt i en loop med fem steg:
- Ljudinsamling: Systemet som kör VAD tar emot en ljudström via WebRTC eller telefoni och tillämpar grundläggande brusfiltrering på datan.
- Inramning: Algoritmen delar upp den råa ljudströmmen i enhetliga ramar.
- Funktionsutvinning: Algoritmen extraherar akustiska egenskaper från strömmen som kan representeras matematiskt som digital data.
- Poängsättning: Systemet kör de extraherade egenskaperna i en ram genom VAD-algoritmen för att generera ett konfidensvärde mellan 0 och 1 (0 = ”inget tal” och 1 = ”tal”) för om den innehåller tal.
- Tillståndsbeslut: VAD-systemet skickar konfidensvärdet till ljudflödet där det körs, så att flödet kan avgöra hur det ska hanteras.
Traditionell respektive AI-baserad röstaktivitetsdetektering
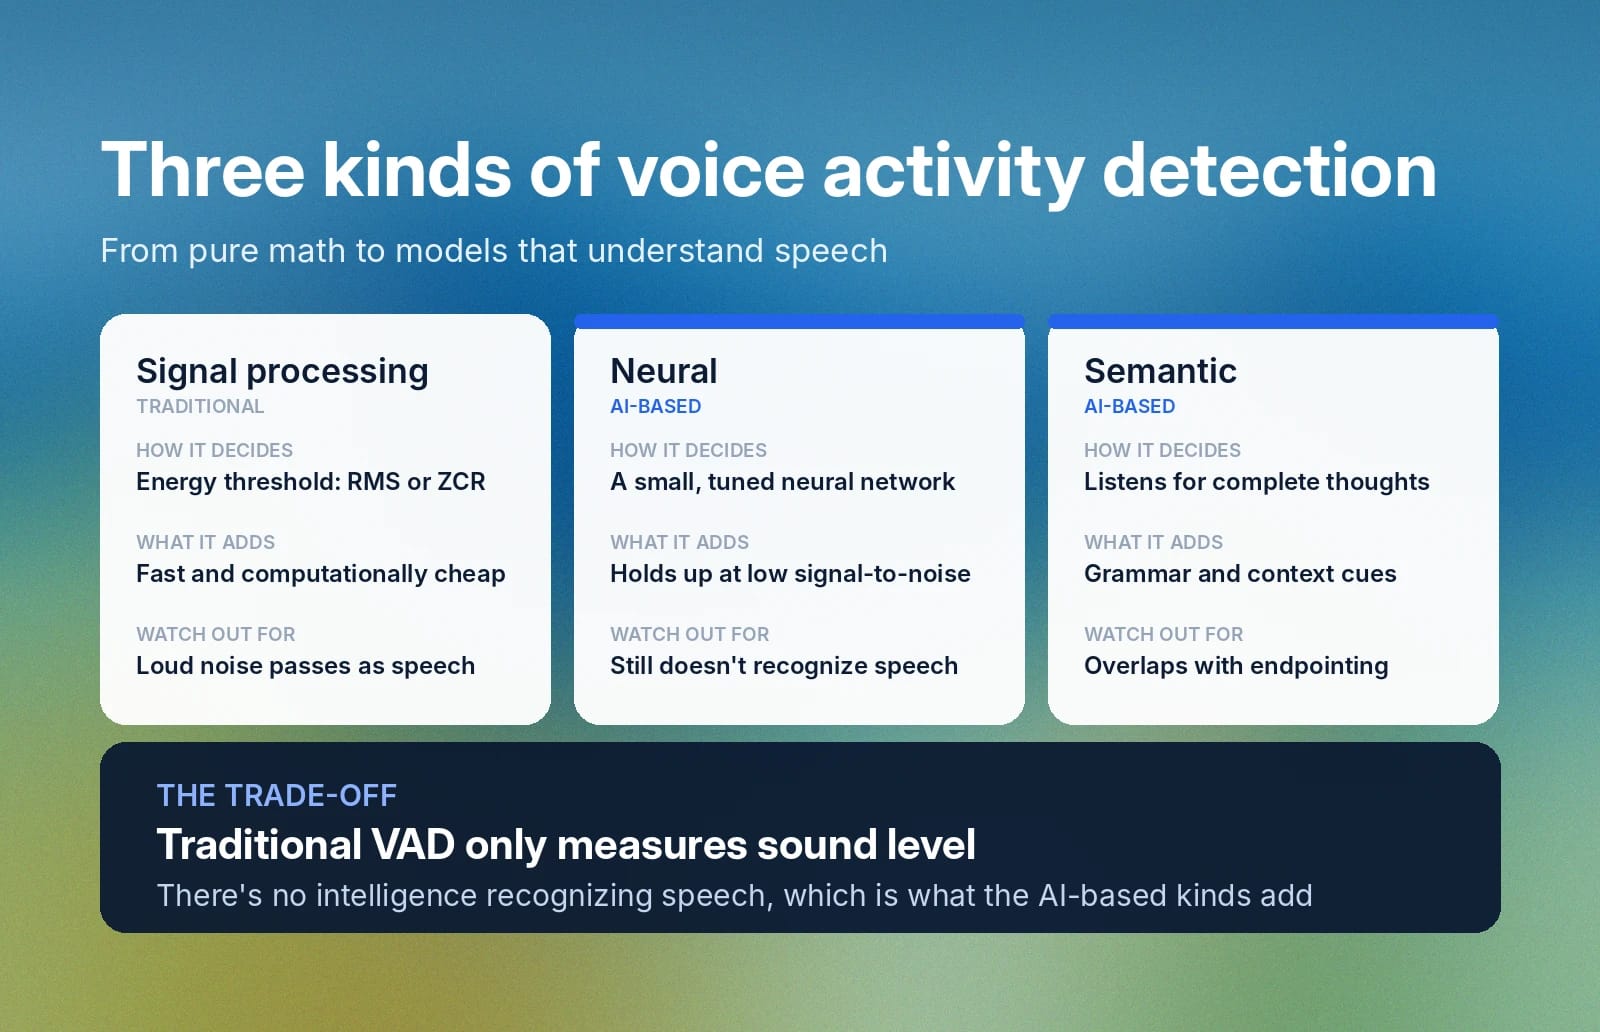
VAD delas in i två övergripande kategorier: signalbehandling och AI.
Inom AI-baserad VAD finns två separata metoder, vilket ger totalt tre typer av röstaktivitetsdetektering.
Låt oss titta närmare på dem.
Traditionell VAD (signalbehandling)
Traditionell VAD-teknik mäter energinivån i en ljudström och bekräftar att tal finns om den passerar ett visst tröskelvärde. Den är helt matematisk och använder ofta beräkning av root mean square (RMS) eller nollgenomgångsfrekvens (ZCR). Om en ram ligger över tröskelvärdet behandlas den som tal. Ligger den under gör den inte det.
Traditionell VAD är snabb och beräkningsmässigt billig, men mäter bara ljudnivån i ljudet. Högt bakgrundsbrus kan ge falska positiva resultat. Den känner inte faktiskt igen tal.
AI-baserad VAD
Det finns två nyare typer av AI-baserad VAD: neural och semantisk. I stället för ett rent matematiskt tröskelvärde använder neural VAD ett litet, noggrant optimerat neuralt nätverk för att avgöra om en ljudram innehåller tal eller tystnad. Träningen gör att systemen förstår skillnaden mellan tal och brus, så de fungerar bättre än traditionell VAD när en ljudström har ett lågt signal-brus-förhållande (SNR), det vill säga mycket bakgrundsbrus.
Nackdelen med neural VAD är att systemen fortfarande inte känner igen själva talet. Semantisk AI-VAD är en annan variant som gör det. Den överlappar med endpointing eftersom den lyssnar efter om uttalade tankar är fullständiga. Den kan grammatiskt och kontextuellt förstå om mer tal kan vara på väg.
VAD jämfört med endpointing
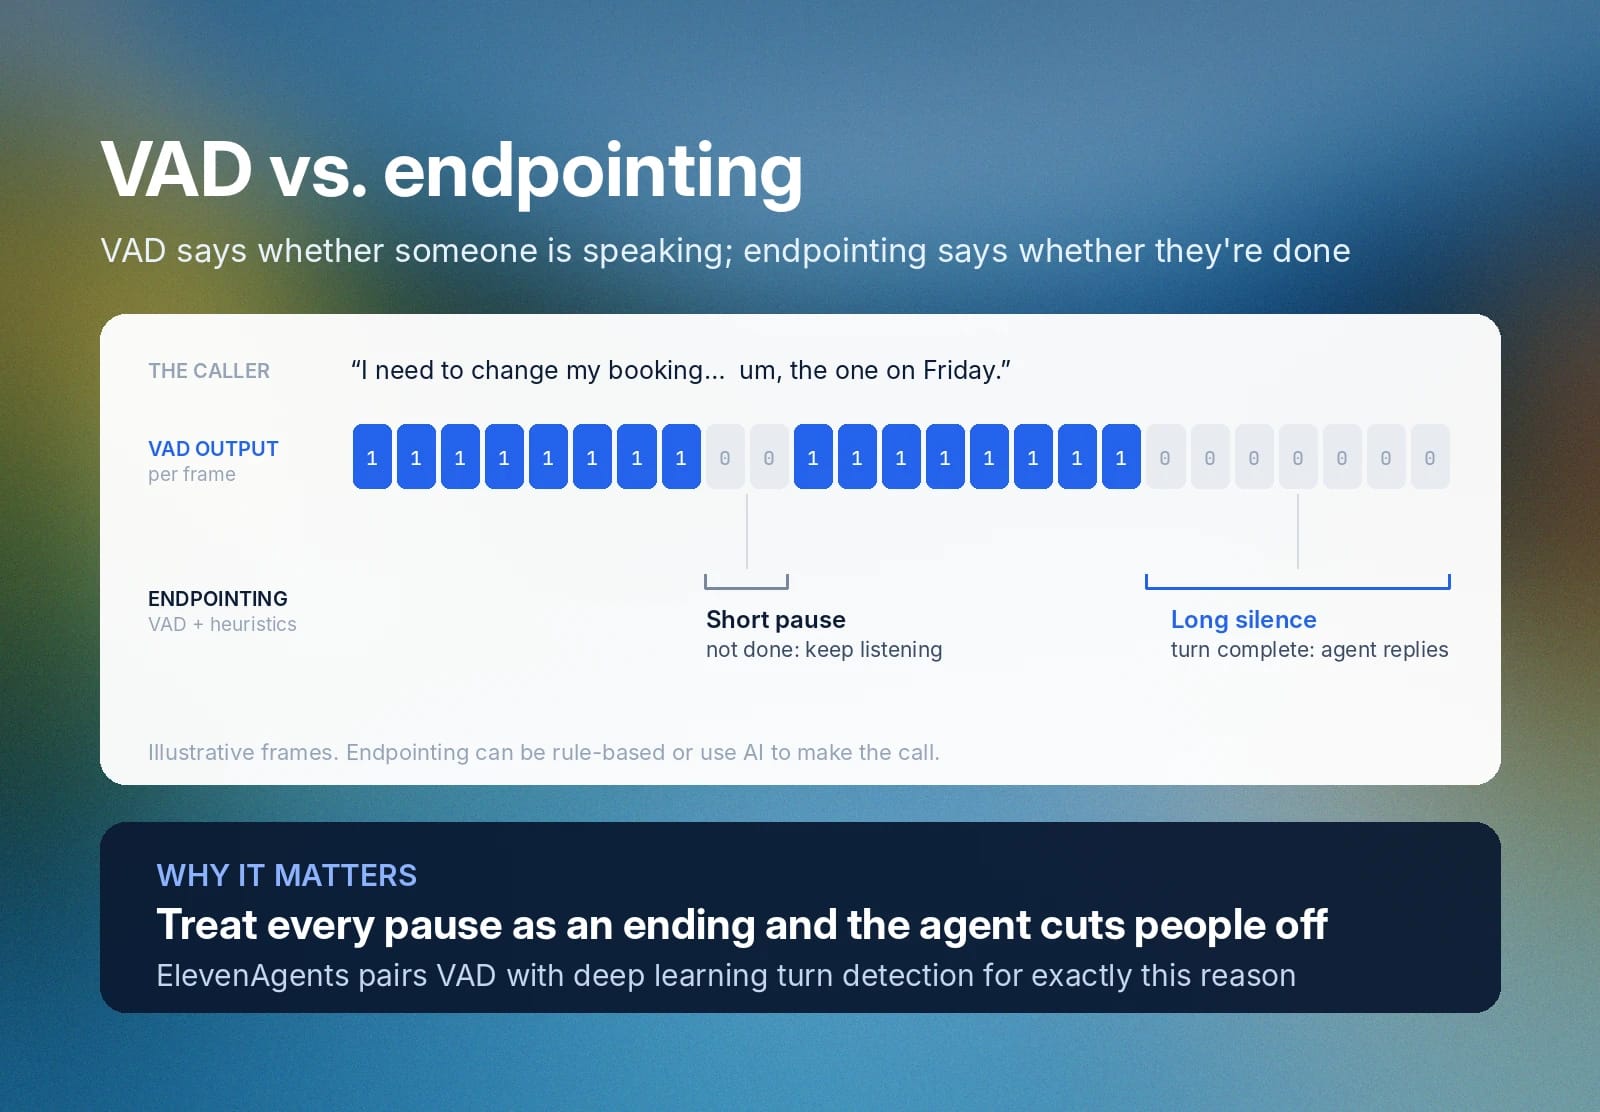
VAD och endpointing är kompletterande tekniker. Ett system för röstaktivitetsdetektering avgör helt enkelt om någon talar i varje ljudram som det bearbetar. Det fattar ett binärt ja- eller nejbeslut och skickar det vidare till resten av ljudbearbetningsflödet.
Ett endpointing-system använder VAD-resultat tillsammans med heuristisk analys för att avgöra om en talare har avslutat sin tanke. Det kan använda regelbaserad signalbehandling eller AI för att fatta beslutet.
Tillämpningar för röstaktivitetsdetektering i AI i realtid
Röstaktivitetsdetektering är viktigt i många användningsfall.
Autonoma röstassistenter och kontaktcenter
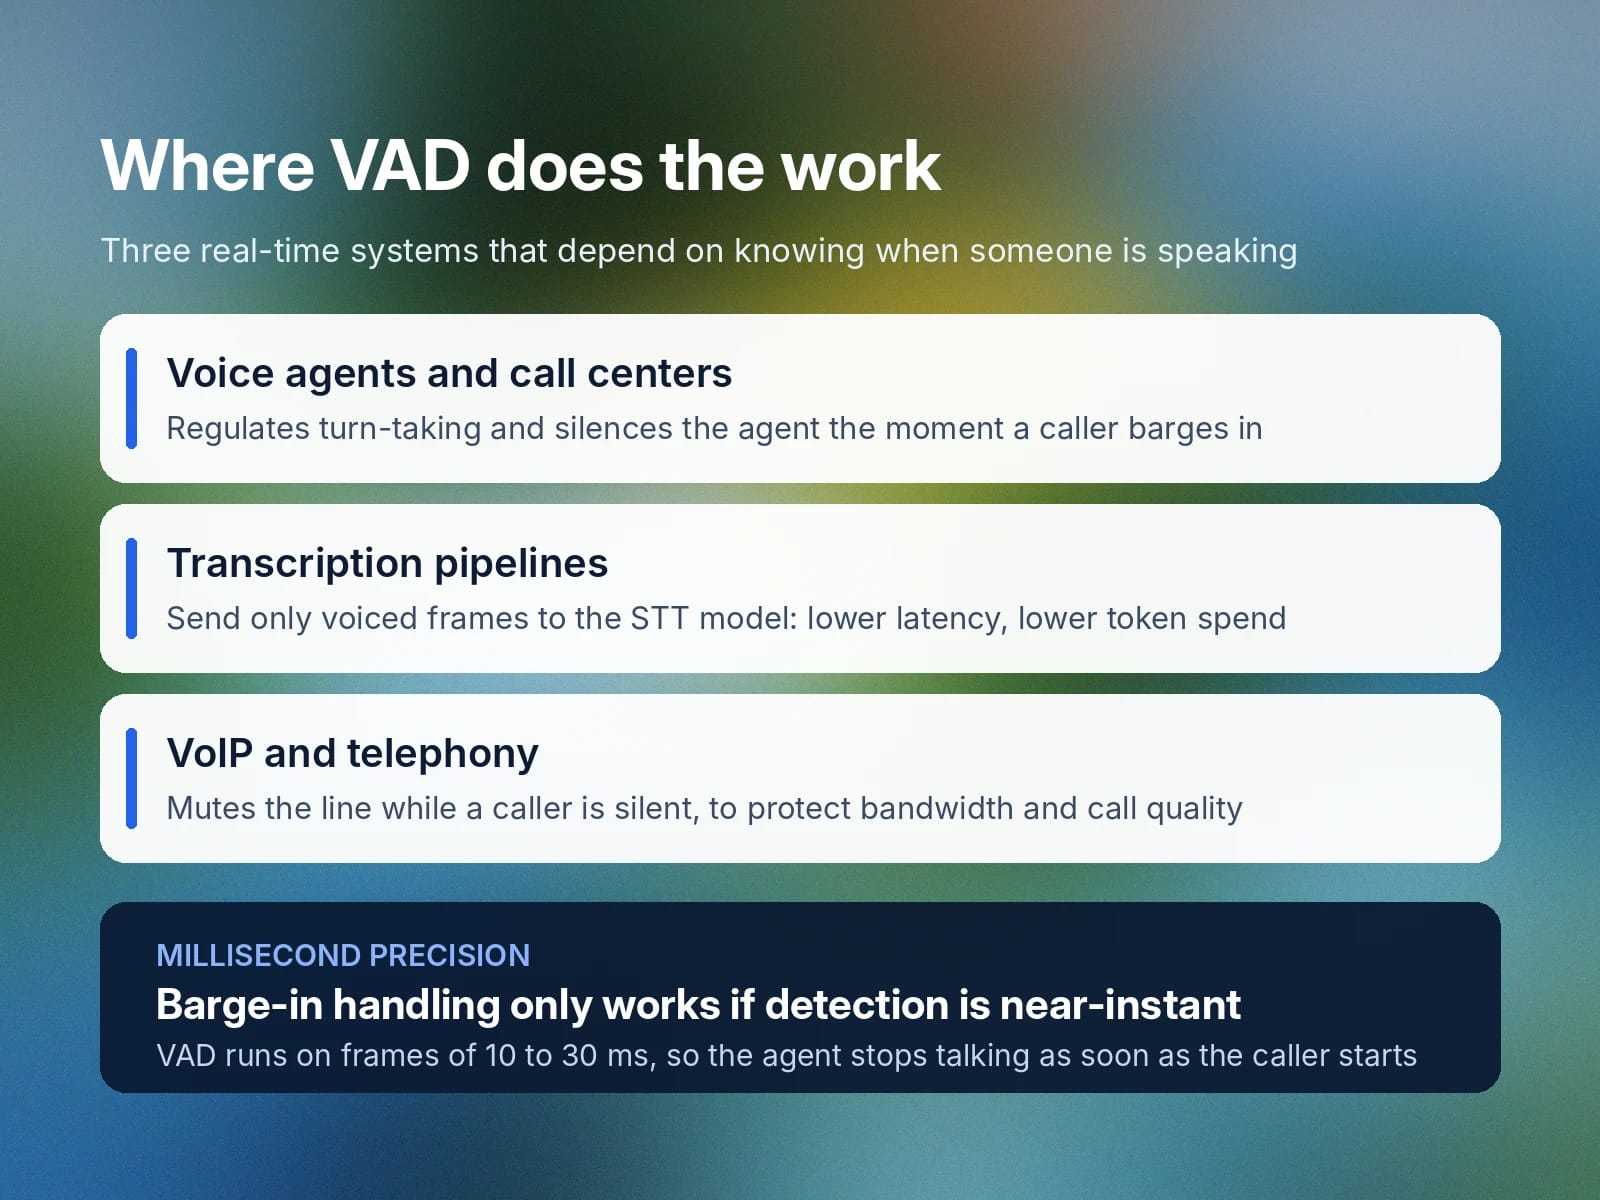
En autonom agent som hanterar kundsamtal behöver veta när det är lämpligt att svara. Du vill inte att agenten avbryter en kund mitt i en mening eller fortsätter tala över kunden när kunden svarar tidigt. VAD hjälper till att reglera turtagning i samtal och upprätthålla ett naturligt flöde i interaktionen. Eftersom det fungerar på millisekundnivå är det också mycket effektivt för att hantera när kunden avbryter, genom att tysta agenten när kunden avbryter den.
Transkriberingsflöden
Om du använder en Speech to Text-API-tjänst för transkribering, som ElevenAPI, kan du filtrera ljudet du skickar med röstaktivitetsdetektering så att modellen bara bearbetar ramar med tal. Det minskar nätverksfördröjningen och, ännu viktigare, sänker din tokenanvändning för transkriberingsmodellen. Du lägger inte AI-kostnader på bakgrundsbrus.
Optimering av VoIP och telefoni
Fördröjning kan också påverka samtalskvaliteten i företagsnätverk för VoIP. För att optimera prestandan tystar dessa digitala ljudsystem tillfälligt en linje med VAD när en uppringare inte talar.
Vad gör röstaktivitetsdetektering utmanande?
Traditionell röstaktivitetsdetektering förlitar sig på matematiska algoritmer för att avgöra om tal finns. Men mänskliga talmönster är röriga. Samtal är ofta ryckiga, med avbrott och återupptaganden, och sker i verkliga miljöer med bakgrundsbrus och till och med sidokonversationer. VAD:s kärnutmaning är att identifiera meningsfull tystnad i brusigt ljud.
Detta visar sig i några specifika utmaningar.
Pauser mitt i en mening
Människor talar inte i jämn takt genom ett helt samtal. De pausar, samlar tankarna, ändrar sig medan de talar och tappar tråden. Ingen av dessa pauser betyder att talaren har pratat klart. Det är oftast lätt för mänskliga lyssnare att förstå, men kan vara svårt för mjukvara, även nyare AI-modeller.
När VAD-system misstar sådana pauser för avslutat tal kan det leda till att tal klipps av mitt i en mening i en transaktion eller till att en röstassistent avbryter en mänsklig talare.
Röstljud
Tyst tal, avtagande slutkonsonanter (vanligt i slutet av en mening) och egenskaper som knarrig röst kan få VAD-system att missa legitimt tal.
Oförutsägbar akustik
Kontinuerligt vitt bakgrundsbrus, som från en fläkt eller rinnande vatten, är relativt enkelt för VAD-system att filtrera bort. Sporadiskt ljud, som en skällande hund, kan däremot felaktigt markeras som tal.
Kraftig ljudkomprimering tar bort dynamiskt omfång och kan göra det svårare för VAD att skilja mellan tysta ramar och ramar med tal.
Så utvärderar du VAD-prestanda
Mänskligt tal är rörigt, särskilt när det spelas in i dynamiska verkliga miljöer. Perfekta ljudinspelningar är inte ett bra sätt att testa VAD-prestanda. Enbart noggrannhet för tal till text mäter inte heller direkt hur effektivt ett VAD-system är, eftersom det ligger efter det som VAD upptäcker.
Falska positiva jämfört med falska negativa resultat
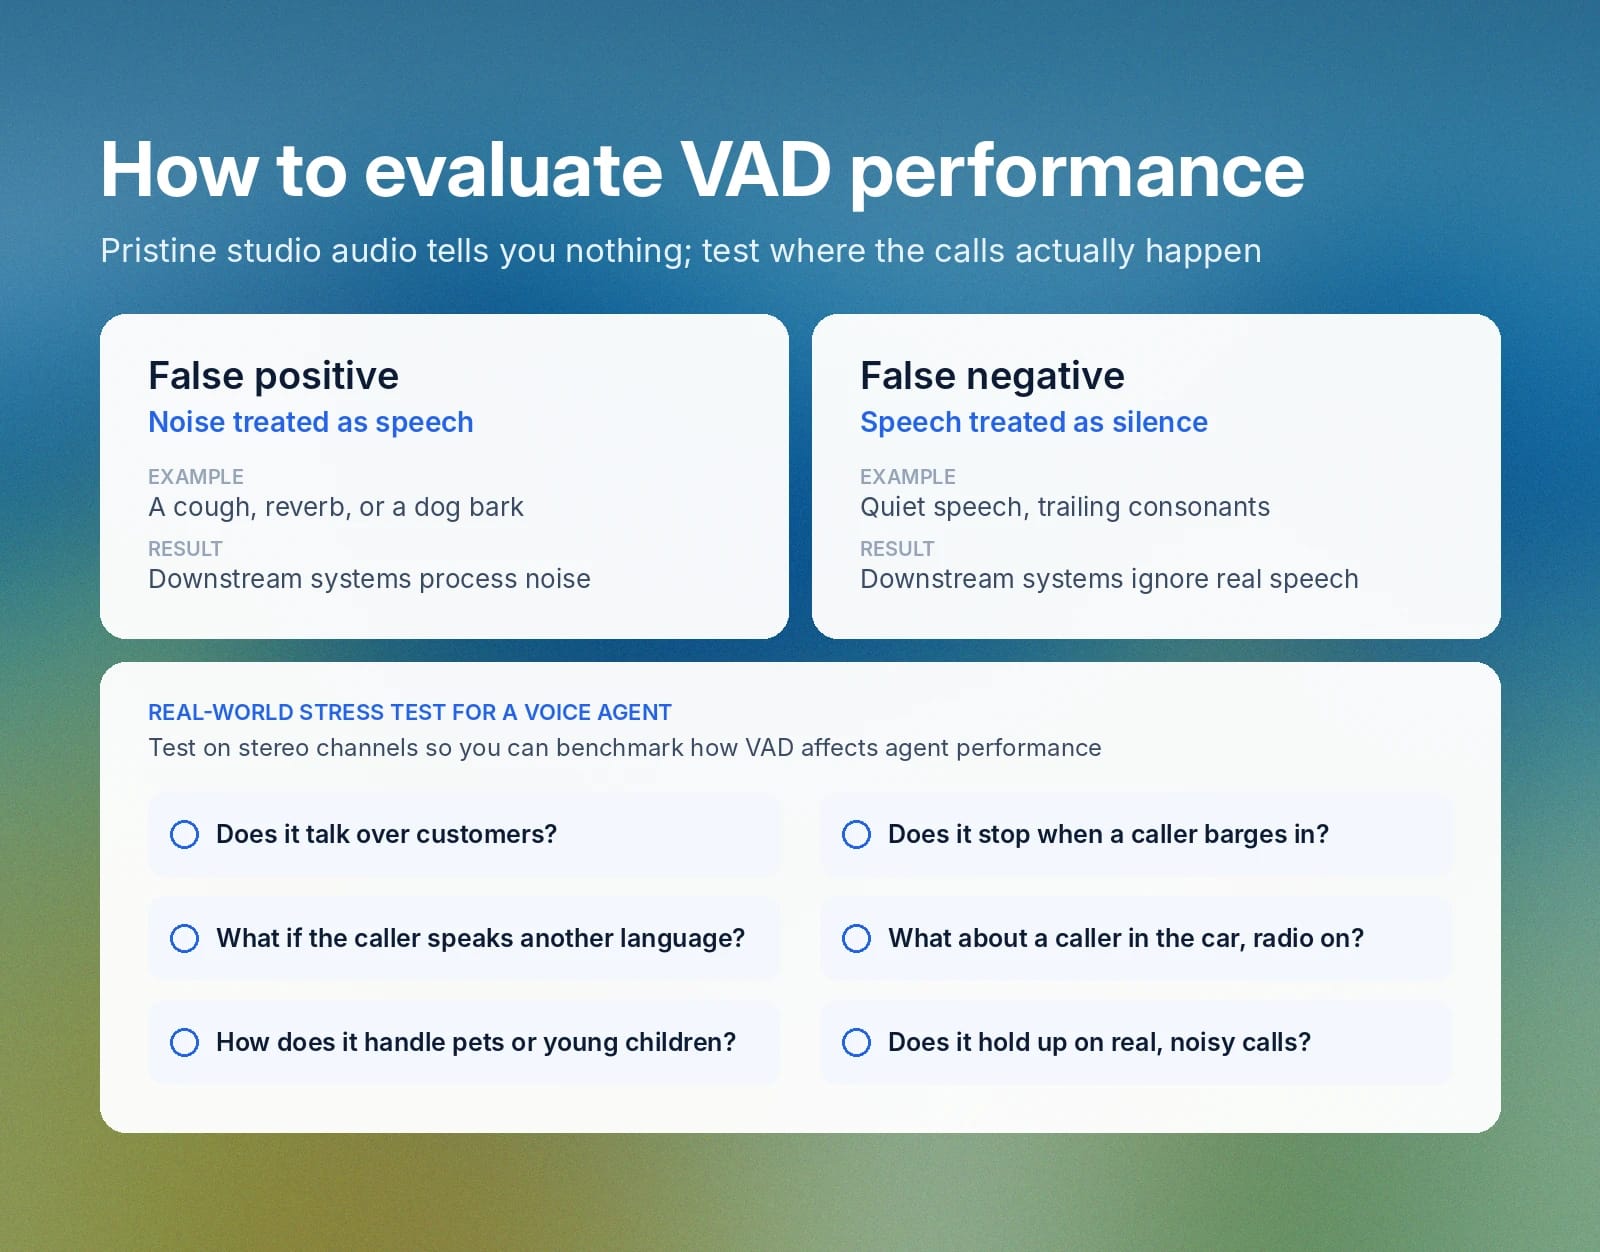
Falska positiva VAD-resultat är brus som behandlas som tal. En hostning, efterklang, ett hundskall eller annat plötsligt bakgrundsljud kan utlösa ett sådant resultat och oavsiktligt skickas vidare som talramar.
Falska negativa resultat är tal som behandlas som tystnad. VAD säger av misstag åt efterföljande tjänster att ignorera ljudramar.
Stresstest i verkliga miljöer
För att utvärdera en VAD-tjänst måste du se hur den fungerar i miljöerna där ljudet ska spelas in och under verkliga förhållanden.
Om du till exempel ska använda VAD för en röstassistent kan du testa med stereokanaler för att mäta hur det påverkar agentens prestanda. Frågor som följande kan uppstå:
- Finns det falska negativa resultat som gör att den pratar över kunder?
- Hindrar den agenten från att tala när en användare avbryter?
- Vad händer om den som ringer talar ett främmande språk?
- Hur fungerar den när den lyssnar på personer som ringer från verkliga miljöer?
- Vad händer när en kund ringer från bilen men inte sänker radion?
- Hur fungerar den med bakgrundsljud från husdjur eller små barn?
Alla dessa situationer kan uppstå i kundsamtal. VAD måste fungera väl även under belastning.
Kom igång med ElevenAgents för kundtjänst
ElevenAgents använder ett hybridbaserat system för VAD och turdetektering med djupinlärning för att hålla agentstyrda samtal flytande och naturliga.
Börja bygga en ny kundtjänstagent med ElevenAgents i dag. Registrera dig för att komma igång.
Vanliga frågor

Jack Limebear jobbar i Growth-teamet och skriver innehåll samt planerar strategier för bloggen och insiktssidorna. Innan ElevenLabs ledde han innehållsstrategi i över tio år för allt från snabbt växande SaaS-startups till Fortune 500-företag. Han har en masterexamen i engelsk litteratur från University of Cambridge.