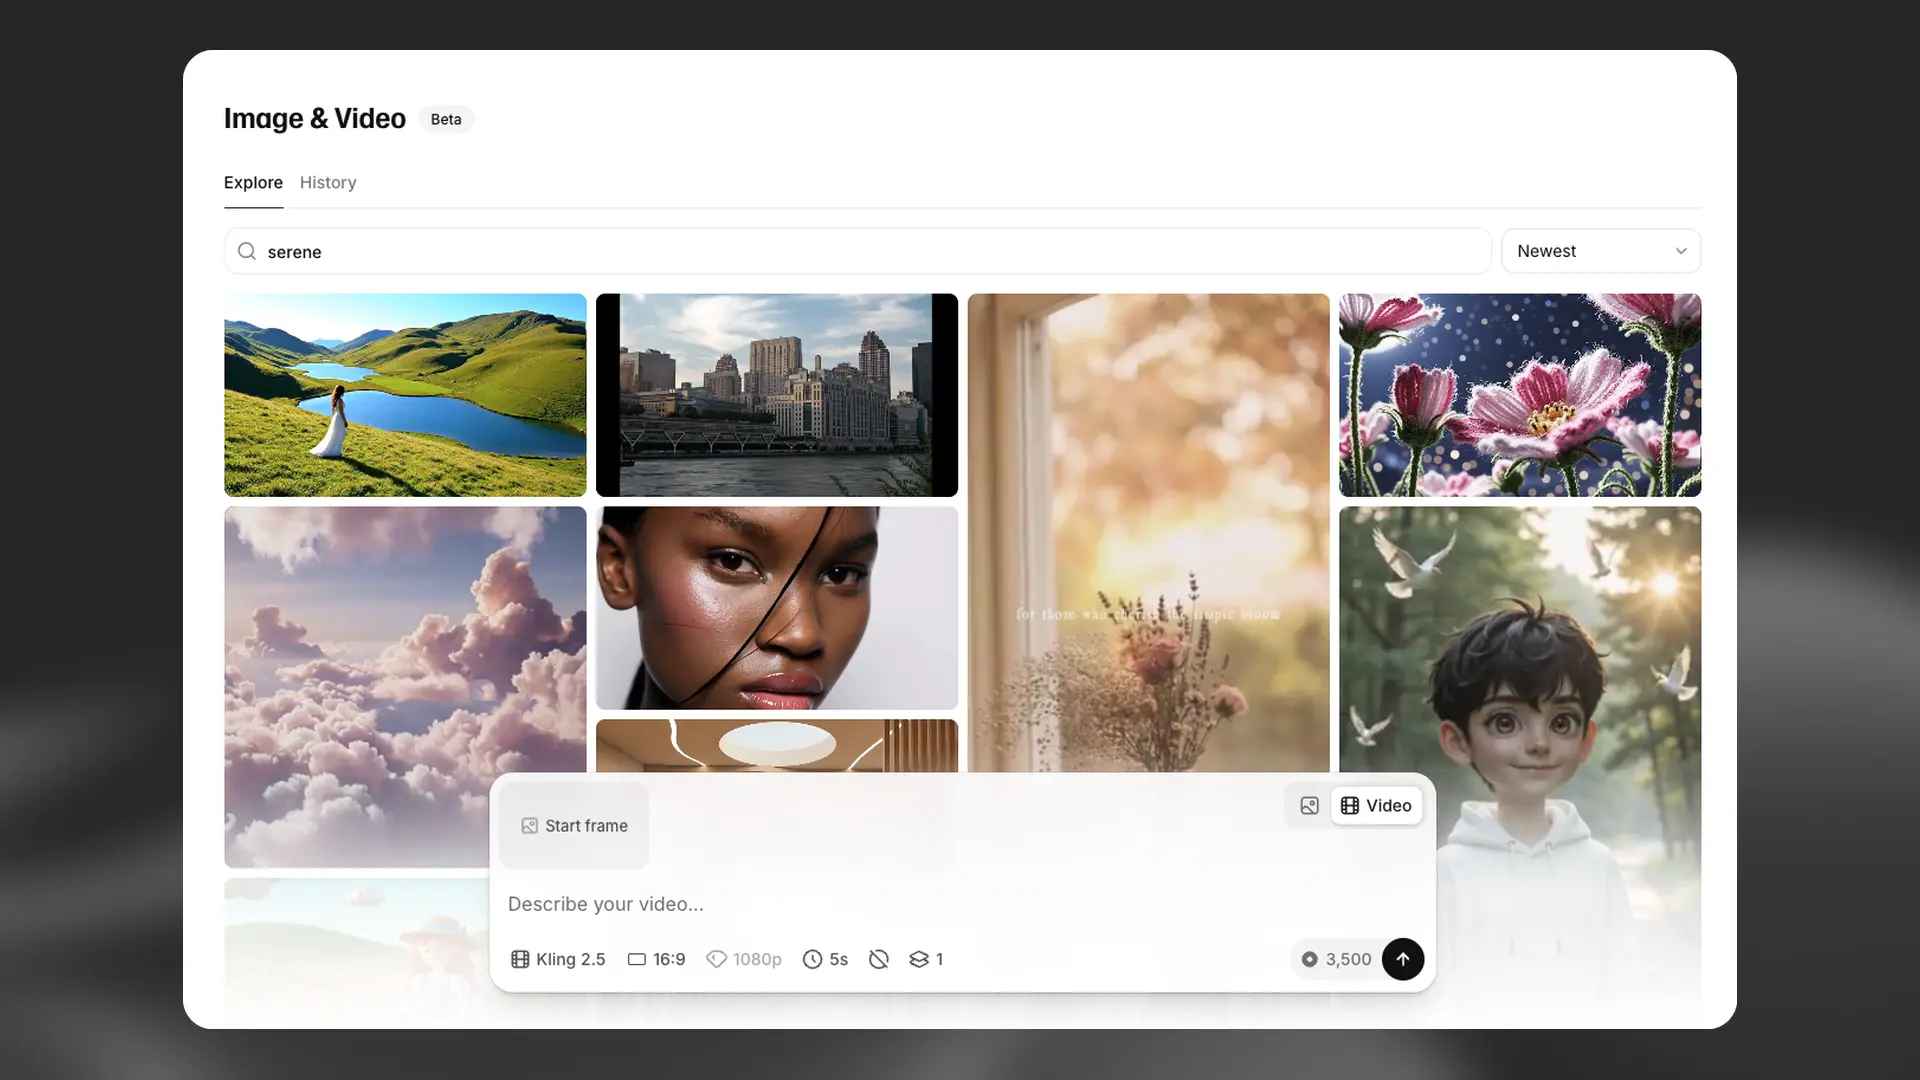
이미지 & 비디오
ElevenLabs에서 이미지와 비디오를 만들고 편집하는 완벽 가이드입니다.
개요
이미지 & 비디오를 사용하면 간단한 텍스트 설명이나 참조 이미지로 고품질 시각 콘텐츠를 만들 수 있습니다. 어떤 스타일로든 정적 이미지나 동적 비디오를 생성한 다음, 추가 프롬프트로 반복해서 다듬고, 고해상도 출력으로 업스케일하며, 오디오로 립싱크까지 추가할 수 있습니다. 완성된 에셋은 독립 파일로 내보내거나 ElevenCreative Studio 프로젝트로 바로 가져올 수 있습니다.
일부 이미지 & 비디오 모델 및 입력 업로드 기능은 규제 또는 제공업체 요구사항으로 인해 미국에서 제한됩니다. 구체적인 이용 가능 여부는 각 모델 설명을 확인하세요.
무료 플랜 사용자는 이미지만 생성할 수 있으며 하루에 이미지 요청 3회로 제한됩니다. 비디오 생성에는 유료 플랜이 필요합니다.
가이드
다음 단계에 따라 첫 시각 에셋을 만들어 보세요.
프롬프트 또는 참조 제공
프롬프트 상자에 자연어로 원하는 결과를 설명하세요. 더 세밀하게 제어하려면 탐색 또는 기록 탭의 기존 이미지나 비디오를 참조 슬롯으로 드래그하거나, JPG, PNG, WEBP 등을 포함한 다양한 파일 형식의 참조 이미지를 직접 업로드하세요.
모델 및 설정 선택
목표에 가장 적합한 생성 모델을 선택하세요(예: Google Veo 3.1, Kling 2.5, Flux 1 Kontext Pro). 각 모델에 대한 자세한 내용은 모델 섹션을 참조하세요. 화면 비율, 해상도, 길이(비디오용), 생성할 변형 수 등의 설정을 조정하세요.
워크플로
제작 과정은 영감에서 완성된 에셋까지 네 단계로 진행됩니다.
탐색
커뮤니티 작업물을 둘러보며 영감을 얻고, 효과적인 프롬프트를 살펴보거나, 참조 자료를 내 작업으로 바로 가져오세요.
생성
프롬프트 상자에 만들고 싶은 내용을 설명하고, 모델을 선택하고, 설정을 세부 조정해 아이디어를 실현하세요.
기록
기록 탭에서 생성 결과를 검토하고 반복 개선하세요. 변형을 다시 만들고, 프롬프트를 재사용하며, 업스케일 및 립싱크 같은 개선 기능을 적용할 수 있습니다.
내보내기
완성된 에셋을 다양한 형식으로 다운로드하거나 프로젝트에서 사용할 수 있도록 ElevenCreative Studio로 바로 전송하세요.
탐색
탐색 탭에는 영감을 얻거나 참조용 비주얼을 찾을 수 있는 커뮤니티 작업물 갤러리가 표시됩니다.
검색: 검색창을 사용해 키워드 기반으로 이미지와 비디오를 찾으세요.
정렬: 인기순과 최신순을 전환해 인기 있는 콘텐츠 또는 최근 추가된 콘텐츠를 확인하세요.
드래그 앤 드롭: 그리드의 결과를 프롬프트 상자로 바로 끌어와 시작 프레임, 종료 프레임 또는 스타일 참조로 사용하세요.
세부 정보 미리보기: 타일을 클릭하면 생성에 사용된 전체 프롬프트와 설정을 확인할 수 있습니다.
생성
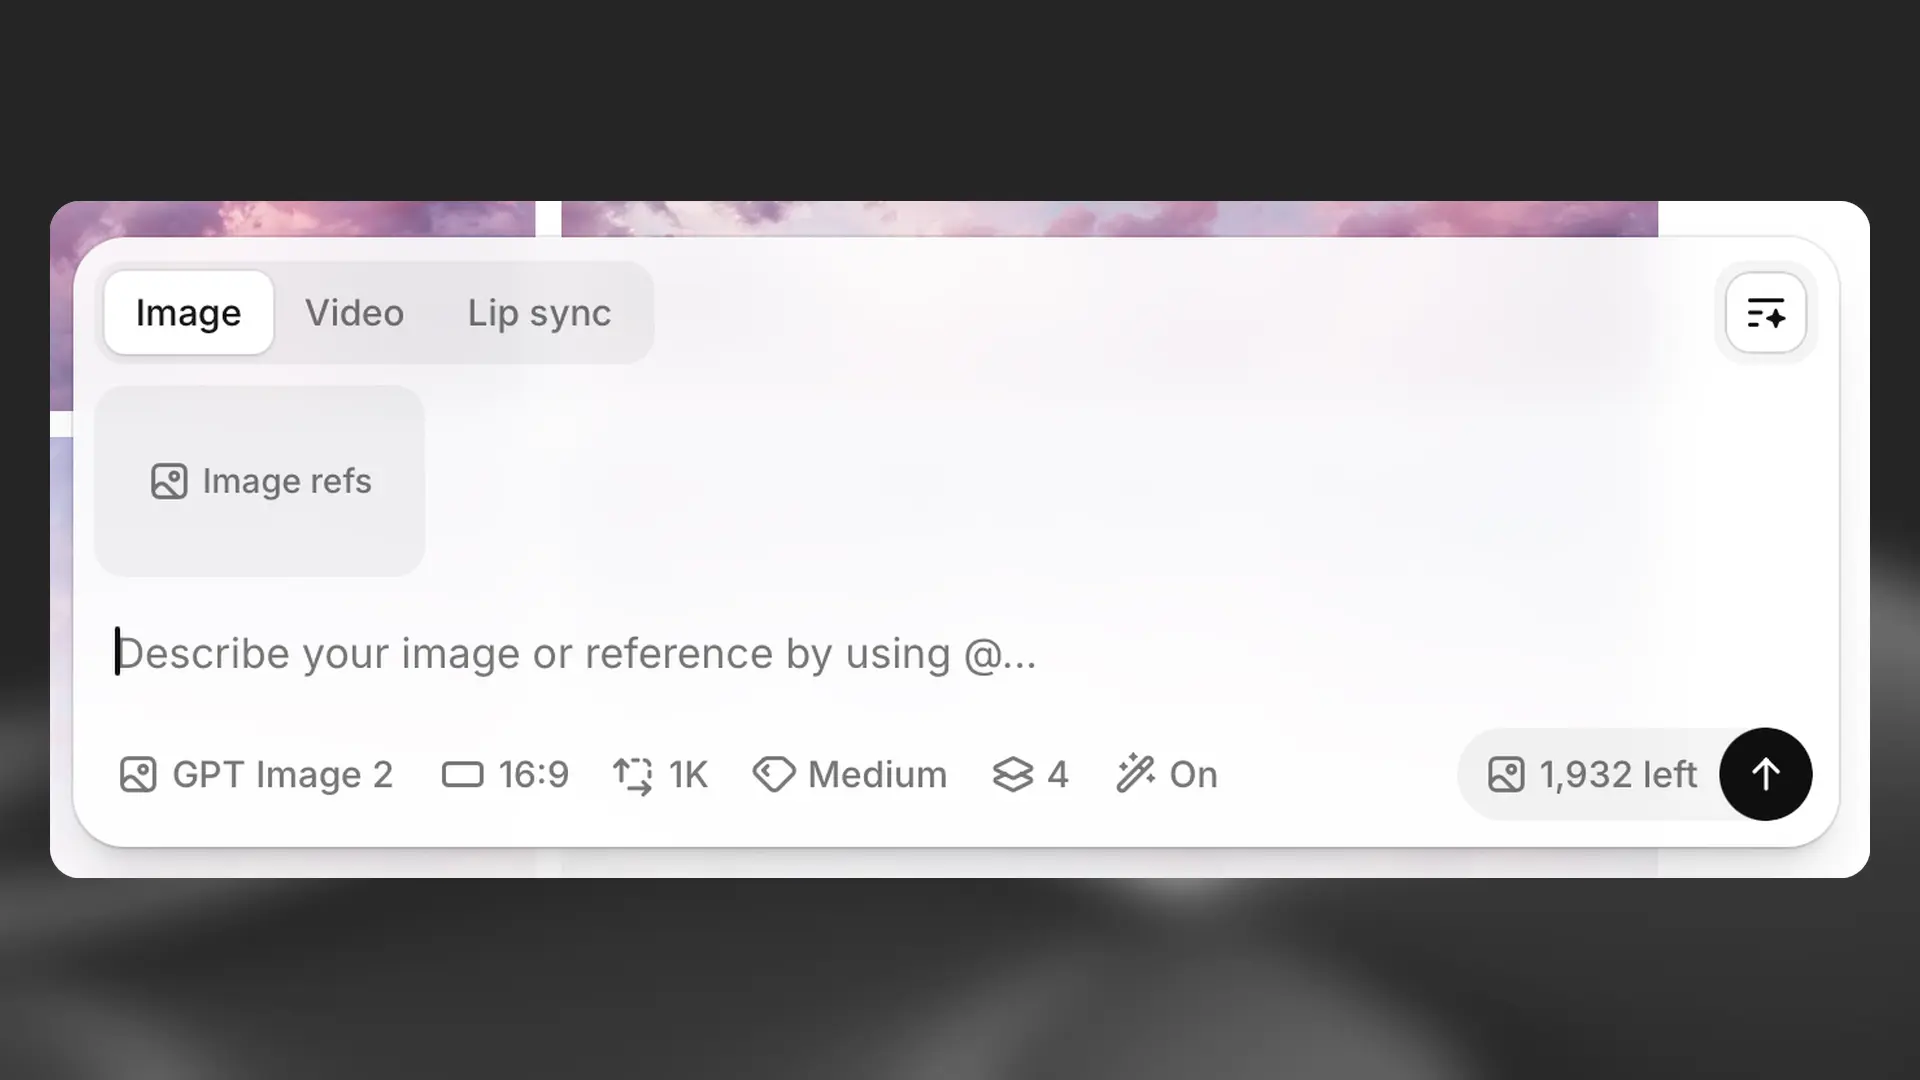
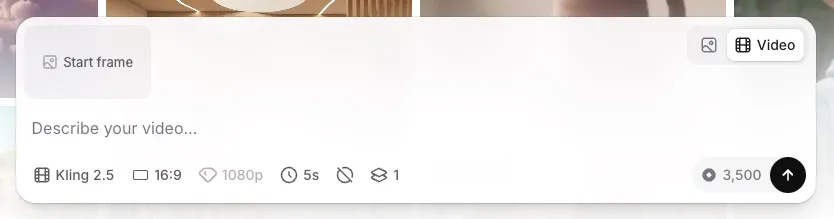
프롬프트 상자는 페이지 하단에 고정되어 있으며 시각 콘텐츠 제작에 필요한 모든 컨트롤을 제공합니다.
모드 및 프롬프트 설정
모드 선택: 오른쪽 상단의 토글을 사용해 이미지와 비디오 생성 간에 전환하세요.
프롬프트 작성: 기본 입력란에 자연어로 생성하려는 내용을 설명하세요. 최상의 결과를 위해 명확하고 구체적으로 작성하세요.
모델 및 설정 선택
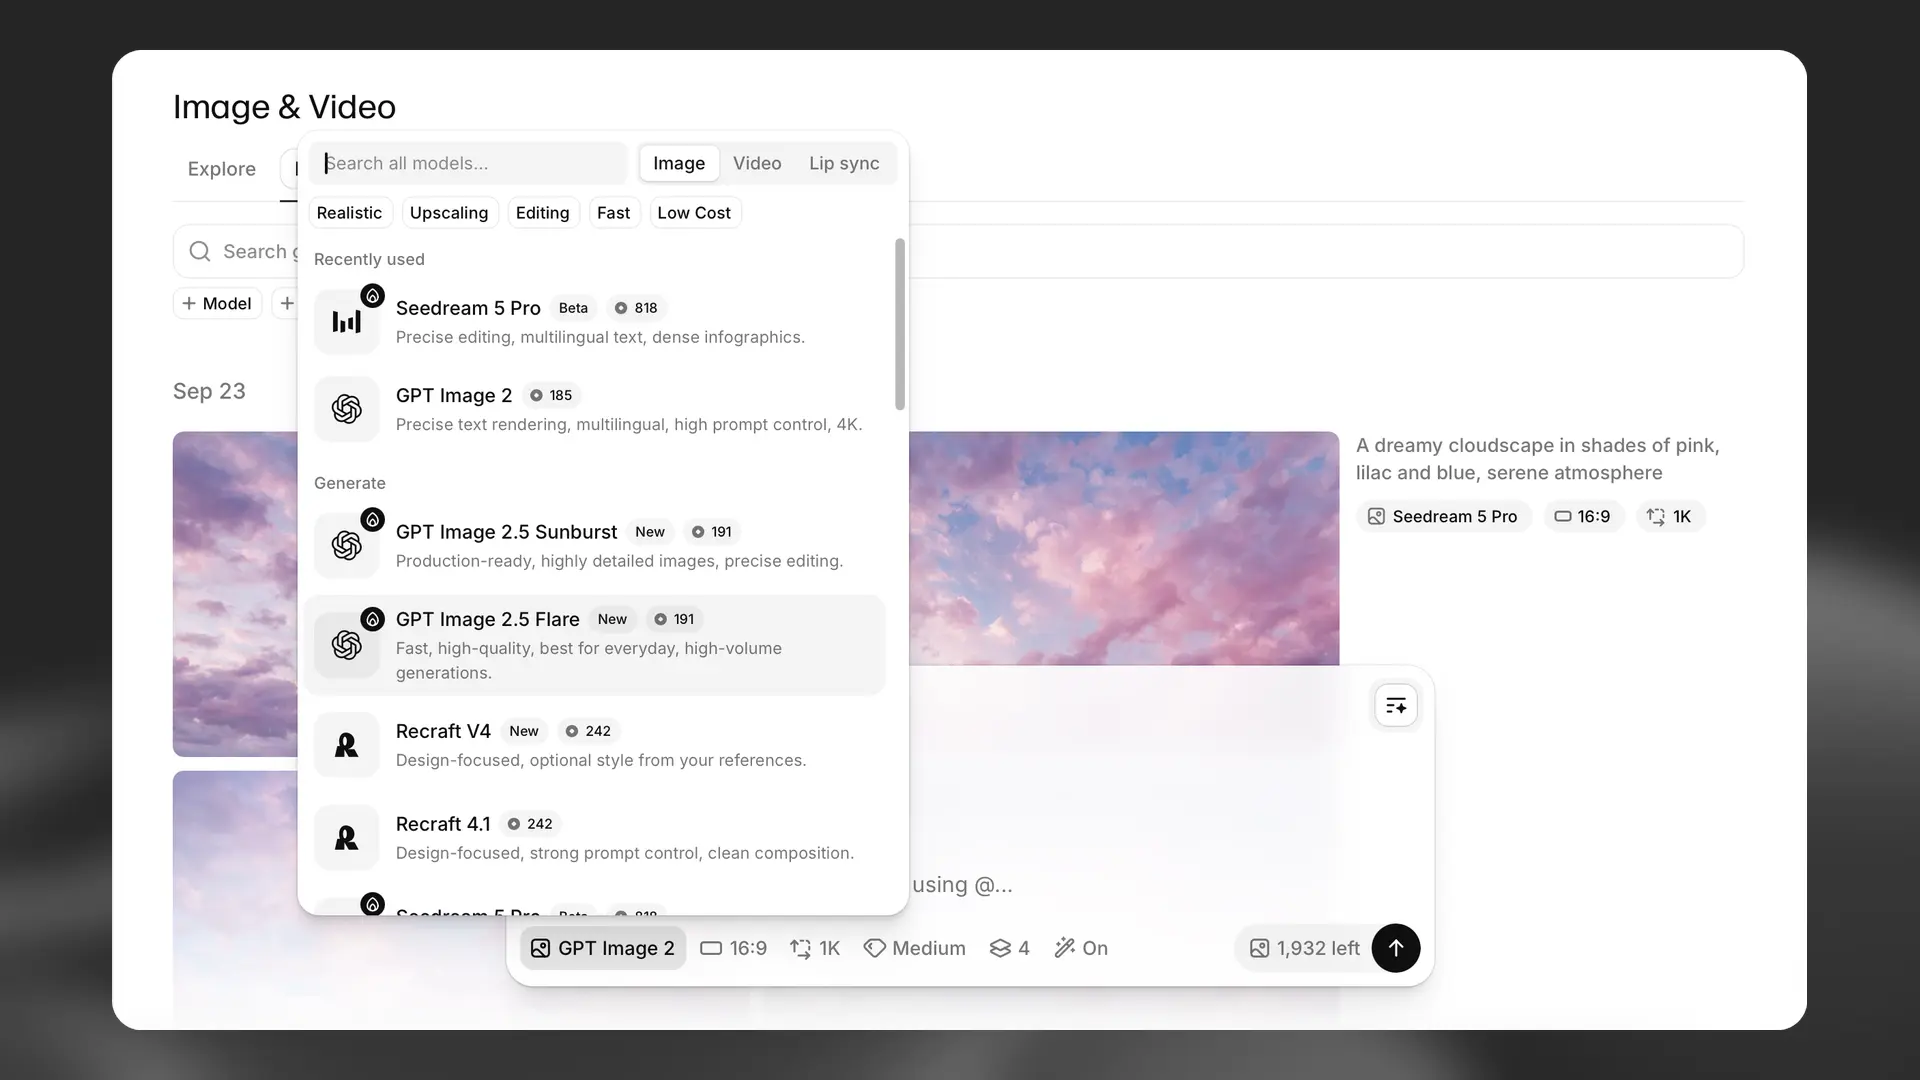
모델 선택: 모델 메뉴를 열어 Google Veo 3.1, Kling 2.5 또는 Flux 1 Kontext Pro 등의 옵션을 살펴보세요. 각 모델에는 쉽게 비교할 수 있도록 고유한 강점과 기능이 표시됩니다. 자세한 내용은 모델 섹션을 참조하세요.
설정 조정: 프롬프트 아래에 표시되는 설정으로 생성을 세부 조정하세요. 설정은 모델마다 다르지만 일반적으로 다음을 포함합니다.
- 화면 비율: 출력 크기 제어
- 해상도: 품질 수준 설정
- 길이: 비디오 길이 지정(비디오 모드)
- 생성 횟수: 한 번에 최대 4개의 변형 생성
컨트롤 사용: 지원되는 모델에서는 오디오를 활성화하고, 원치 않는 요소를 제외하기 위한 네거티브 프롬프트를 추가하거나, 사운드 컨트롤을 조정할 수 있습니다.
참조 추가
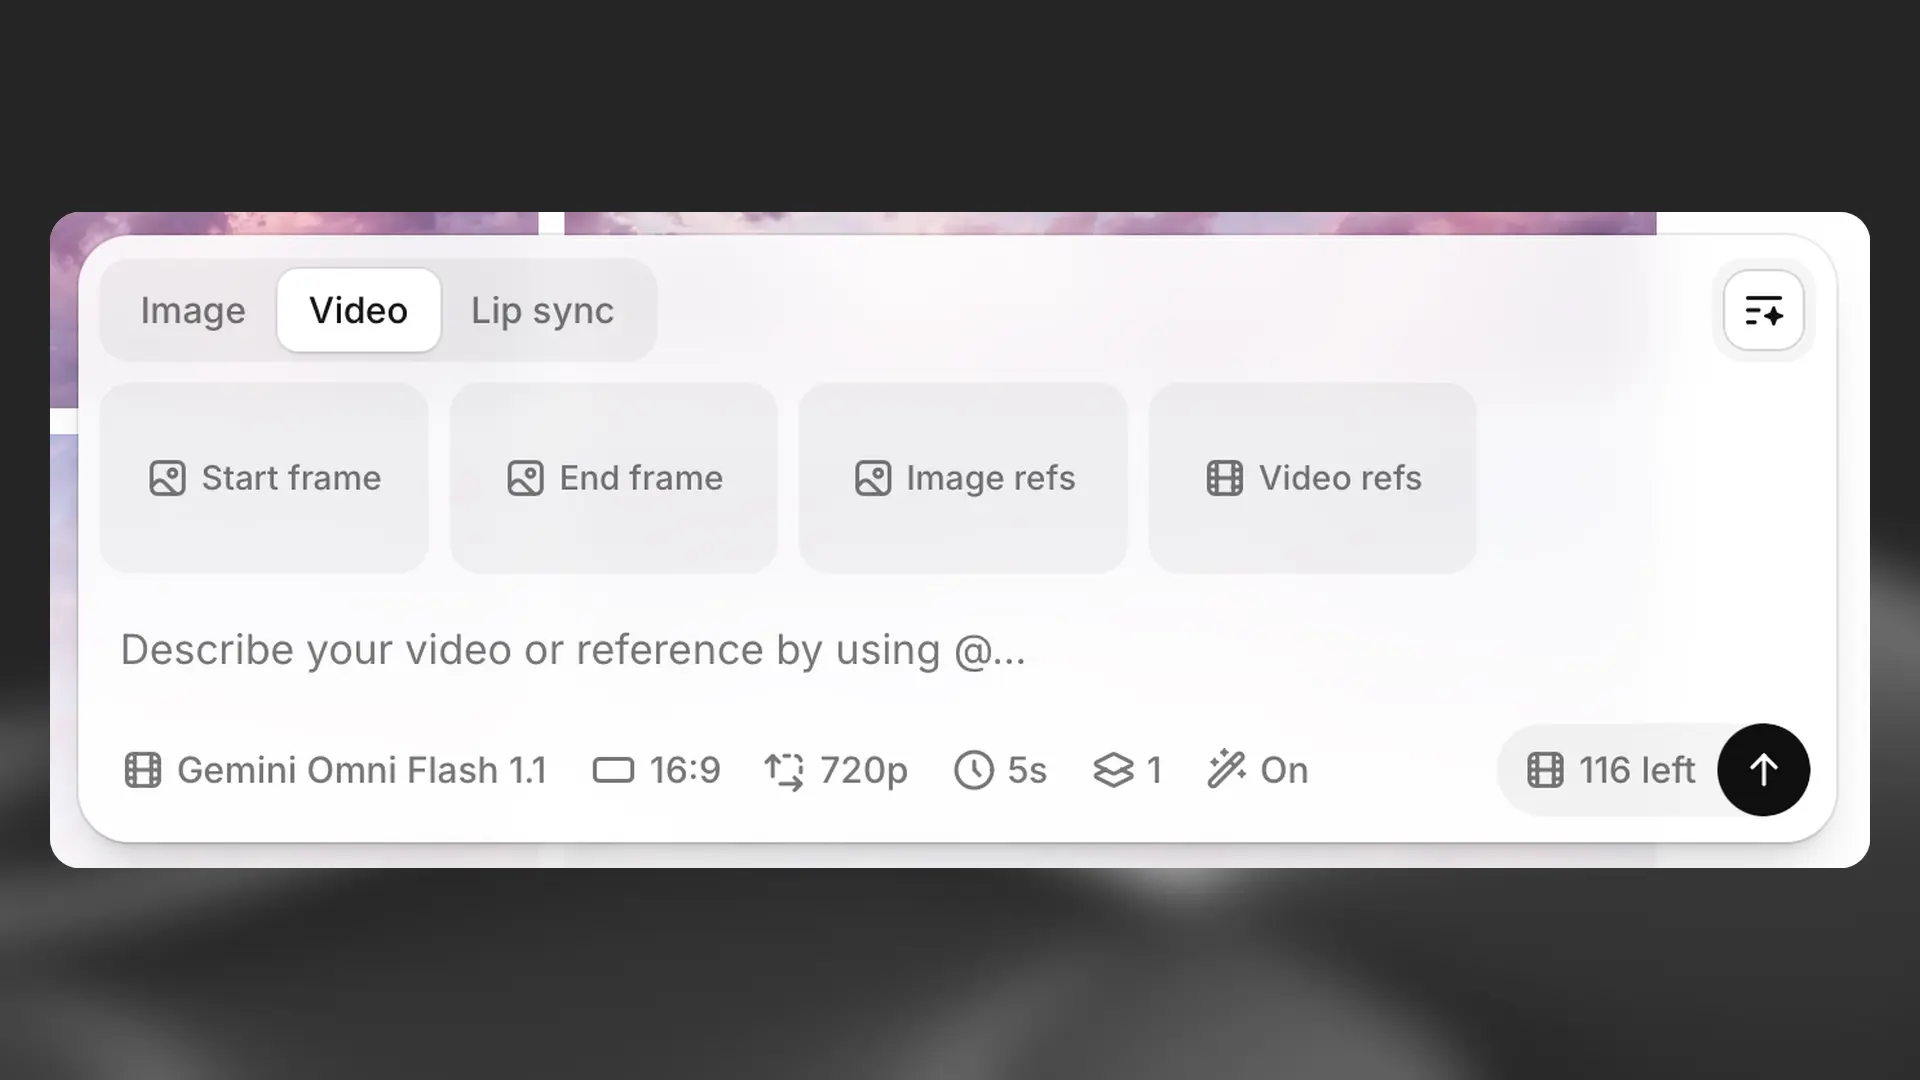
출력을 더 세밀하게 제어하려면 생성을 안내할 시각 참조를 추가하세요. 사용 가능 여부는 선택한 모델에 따라 다릅니다. JPG, PNG, WEBP 등을 포함한 다양한 이미지 파일 형식을 지원합니다.
시작 프레임(비디오): 비디오의 첫 이미지를 설정합니다.
종료 프레임(비디오): 전환에 영향을 주는 마지막 이미지를 설정합니다.
이미지 참조(이미지 또는 비디오): 전체적인 스타일과 분위기를 안내할 이미지 하나 이상을 제공합니다.
더 빠른 워크플로를 위해 탐색 또는 기록 탭의 항목을 참조 슬롯으로 바로 드래그 앤 드롭하세요.
생성
생성하기 전에 비용 표시기에 선택한 에셋 생성 개수의 총비용이 표시됩니다. 준비가 되면 생성을 클릭하세요. 새 작업물이 기록 탭에 나타납니다.
기록
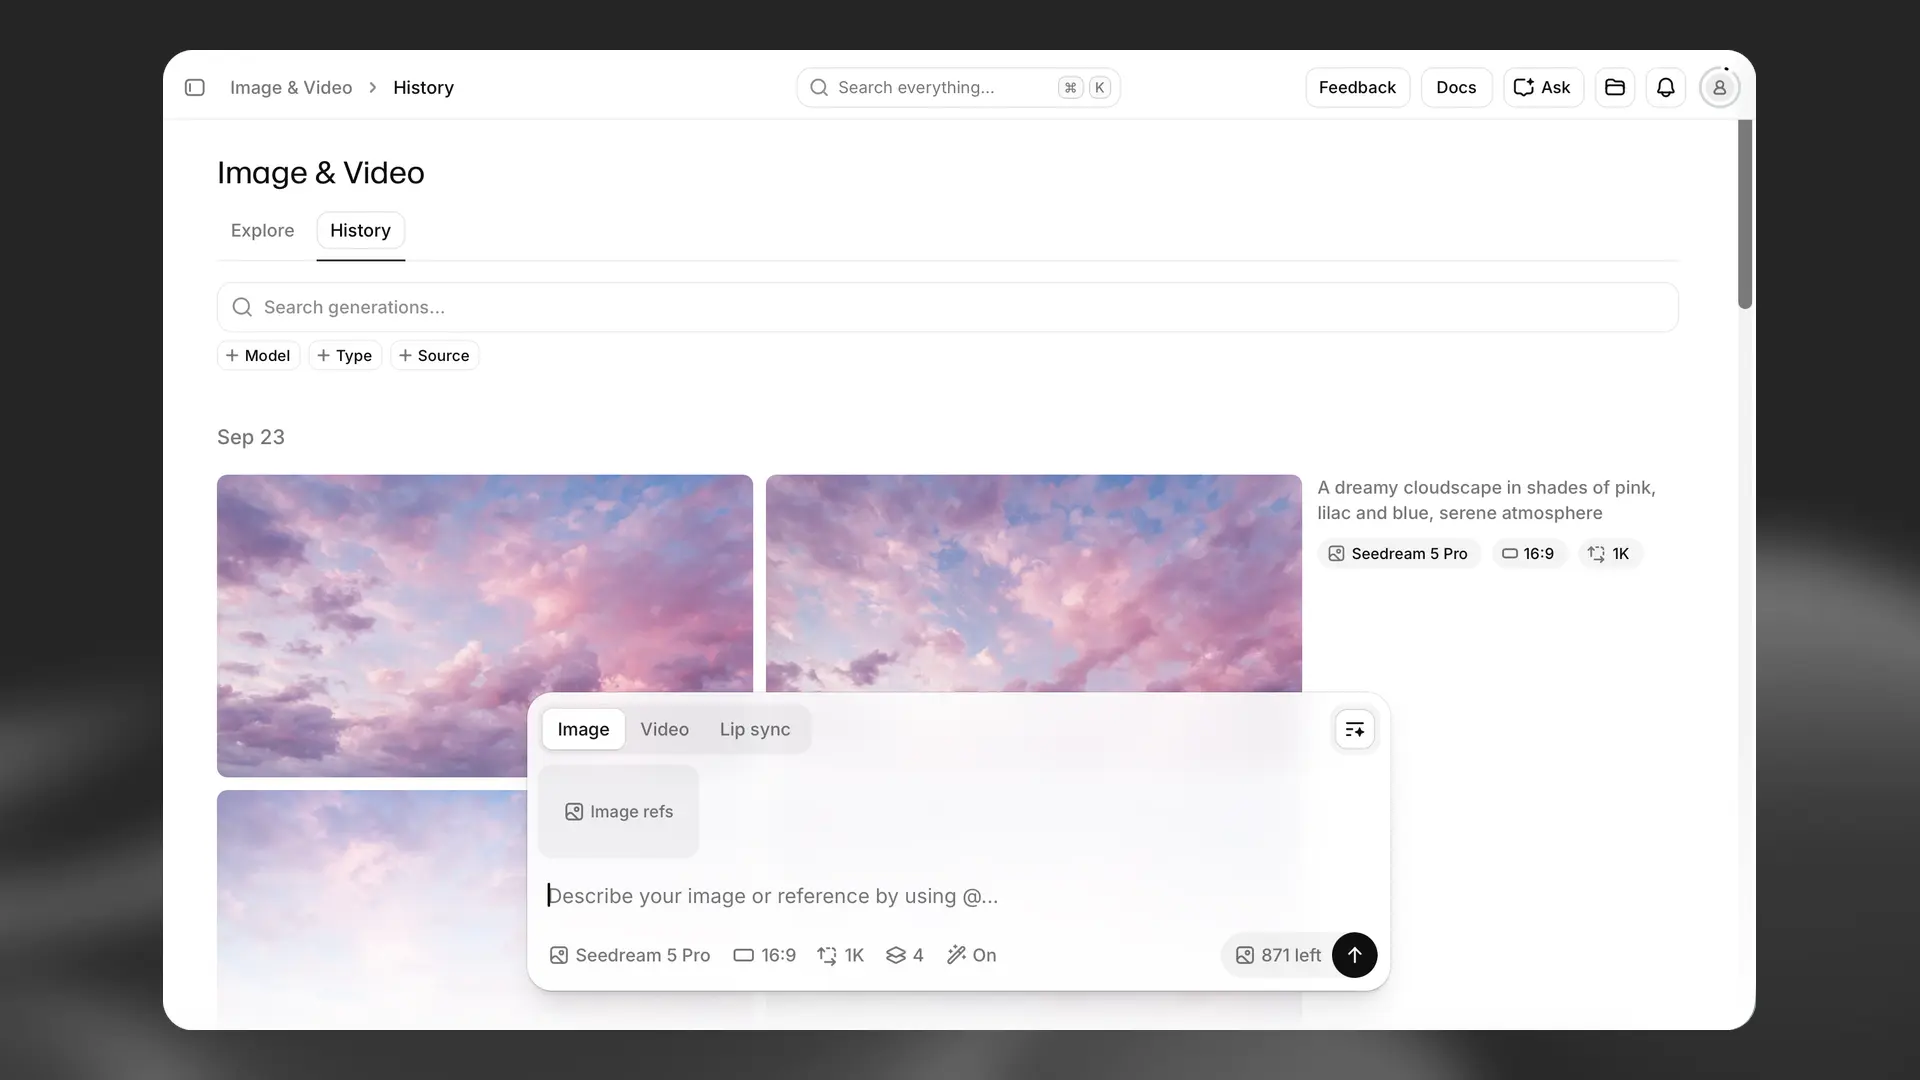
기록 탭은 생성한 모든 항목을 시간순으로 보여 주며 이전 작업을 다듬을 수 있는 작업 공간 역할을 합니다.
둘러보기: 이전에 생성한 모든 이미지와 비디오를 확인하세요.
검토: 에셋을 클릭하면 생성에 사용된 원본 프롬프트, 모델 및 설정을 확인할 수 있습니다.
재사용: 기록의 항목을 프롬프트 상자로 다시 드래그해 새 생성의 참조로 사용하세요.
반복: 다시 만들기를 클릭해 동일한 프롬프트와 설정으로 새 변형을 생성하거나, 설정을 조정해 새로운 방향으로 생성을 유도하세요.
공유: 공유를 클릭해 에셋의 고유 링크를 생성하세요. 피드백을 위해 팀원 및 협업자에게 보내세요.
내보내기: 에셋을 독립 파일로 다운로드하거나 Studio에서 편집을 클릭해 ElevenCreative Studio로 바로 가져오세요.
내보내기
만족스러운 생성 결과를 얻었다면 내보내기 전에 기본 제공 개선 도구를 사용하세요.
작업물 개선
업스케일: Topaz Upscale을 사용해 선명한 디테일을 유지하면서 해상도를 최대 4배까지 높이세요.
립싱크: 비주얼에 사실적인 립싱크를 적용하세요.
- Omnihuman 1.5: 오디오 트랙으로 정적 이미지에 움직임 추가
- Veed LipSync: 기존 비디오에 새 오디오 더빙
에셋 내보내기
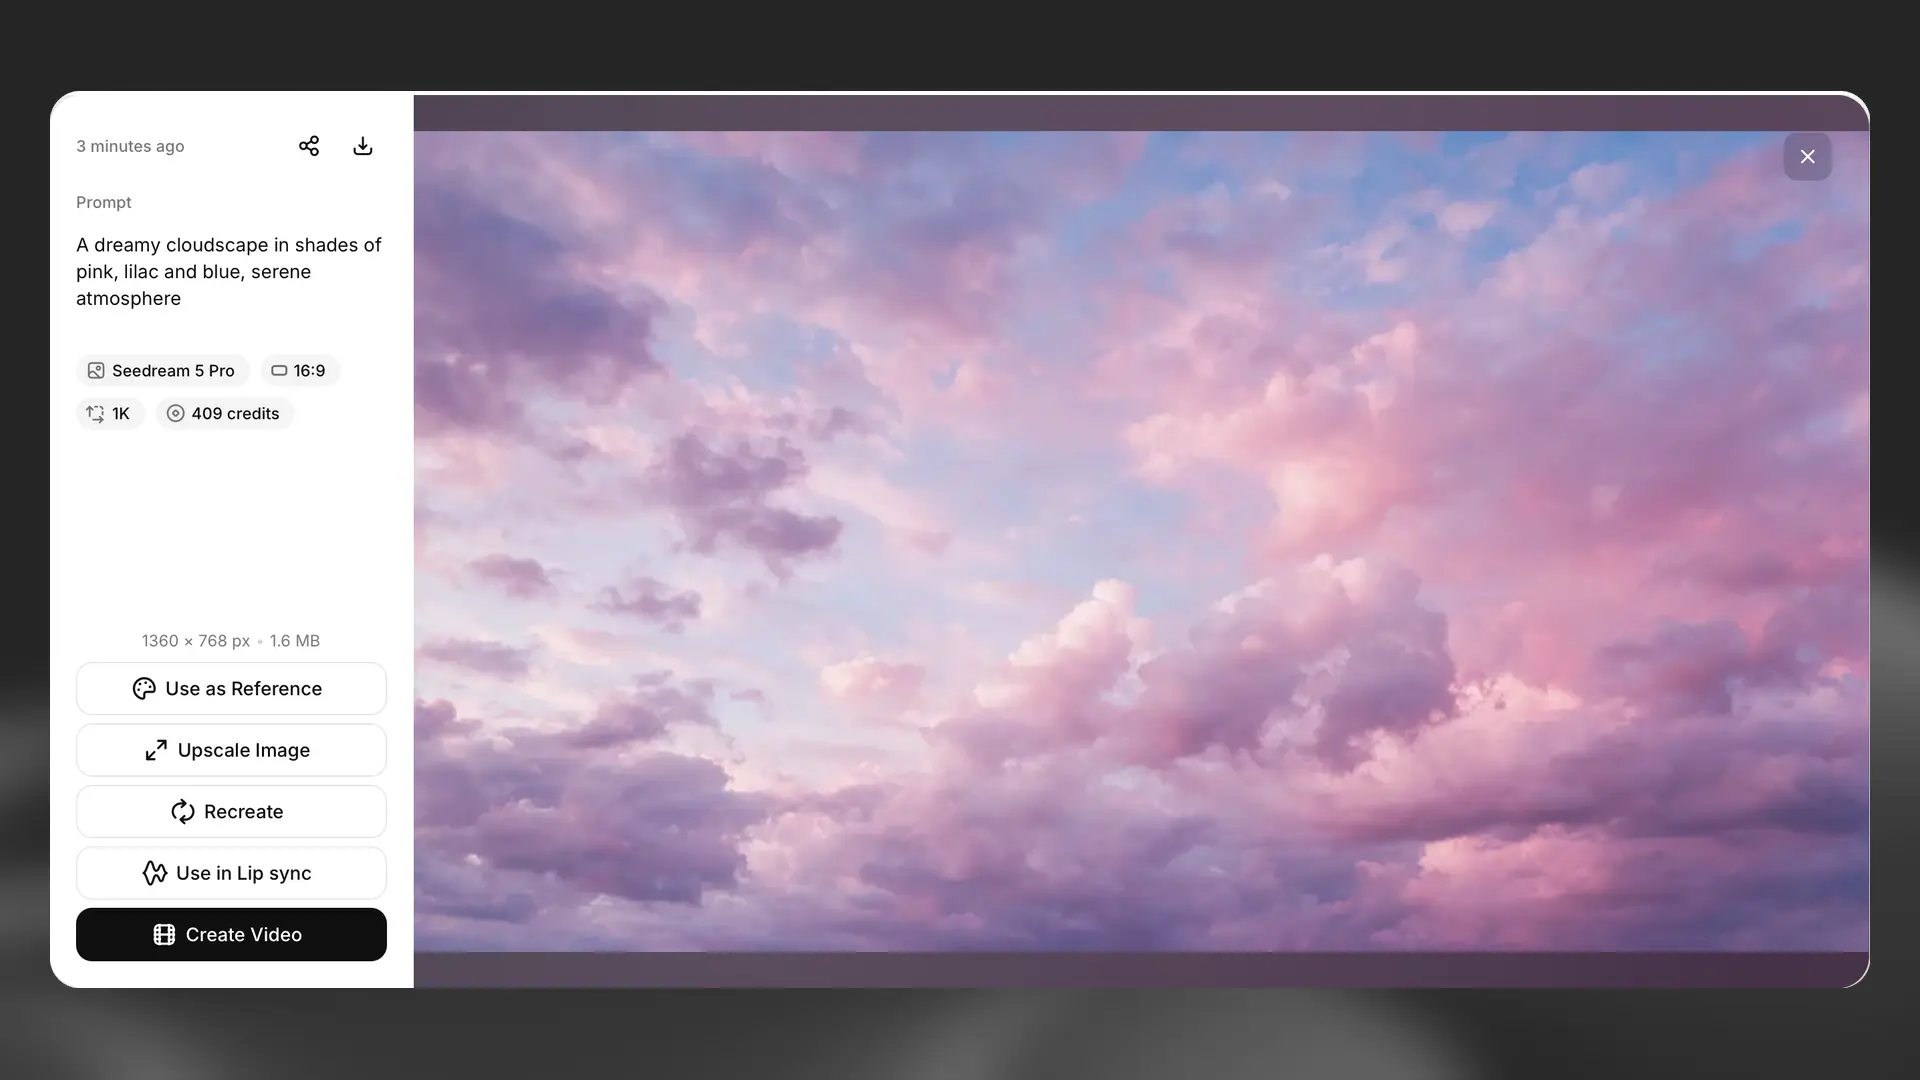
완성된 에셋을 로컬에 다운로드하거나 ElevenCreative Studio로 바로 전송해 내보내세요.
Studio에서 편집: 에셋을 ElevenCreative Studio 프로젝트로 바로 가져옵니다.
다운로드: 에셋을 로컬 기기에 저장합니다.
지원되는 다운로드 형식
비디오:
- MP4: 코덱 H.264, H.265. 최대 4K 품질(업스케일링 사용 시)
이미지:
- PNG: 고해상도 무손실 출력
모델
이미지 & 비디오는 다양한 사용 사례에 맞게 최적화된 전문 모델을 제공합니다. 각 모델은 빠른 반복 작업부터 프로덕션 수준의 품질까지 고유한 기능을 제공합니다.
후처리 모델은 기존에 생성된 결과물이 필요하지만, 자체 이미지 또는 비디오 파일을 업로드할 수도 있습니다.
엔터프라이즈 워크스페이스 관리자는 워크스페이스 구성원이 사용할 수 있는 이미지 및 비디오 생성 모델을 제어할 수 있습니다. 기본적으로 엔터프라이즈 워크스페이스에서는 모든 모델이 비활성화되어 있으며, 관리자가 명시적으로 활성화해야 합니다. 자세한 내용은 모델 승인을 참조하세요.
API 요청의 경우 ByteDance 모델은 기본적으로 비활성화되어 있으며, 사용 전에 명시적인 승인이 필요합니다. 엔터프라이즈 고객은 지원팀에 문의하여 액세스를 요청할 수 있습니다.
아래의 모든 모델은 이미지 & 비디오 앱에서 사용할 수 있습니다. 이미지 & 비디오 API에서도 호출할 수 있는 모델은
API 아래에 model_id가 표시되며, 나머지는 앱 전용입니다.
비디오 생성 모델
Seedance 2.0
오디오와 비디오를 함께 생성하는 통합 멀티모달 비디오 모델로, 초현실적이고 영화 같은 결과물을 위해 연기, 조명, 그림자, 카메라 움직임을 감독 수준으로 제어할 수 있습니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조
- 비디오 참조
- 오디오 참조
기능:
- 동기화된 오디오와 비디오를 한 번에 함께 생성하는 통합 멀티모달 아키텍처
- 텍스트, 이미지, 오디오, 비디오 입력을 동시에 수용하는 업계 최고 수준의 멀티모달 참조 및 편집 기능
- 업계 표준에 부합하는 영화급 사실감과 탁월한 모션 안정성
- 연기, 조명, 그림자, 카메라 움직임을 감독 수준으로 창의적으로 제어
- 4초부터 최대 15초까지 유연한 생성 길이
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 480p, 720p, 1080p
- 화면비: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 동기화된 오디오와 영상을 요구하는 영화적 스토리텔링
- 원본 이미지, 비디오 또는 오디오를 엄격히 따르는 참조 기반 콘텐츠
- 조명과 카메라 작업을 세밀하게 제어해야 하는 전문 프로덕션
비용: 선택한 설정과 길이에 따라 달라집니다
설정을 전환하여 크레딧 사용량을 조정할 수 있습니다.
Seedance 2.0은 미국에서 사용할 수 없습니다.
Seedance 2.0 Fast
동일한 멀티모달 참조 입력을 제공하면서 출력을 720p로 제한한, 더 빠르고 저렴한 Seedance 2.0 변형 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조(최대 9개)
- 비디오 참조(최대 3개, 합산 15초)
- 오디오 참조(최대 3개, 합산 15초)
기능:
- Seedance 2.0과 동일한 참조 처리 방식이며, 생성당 참조는 합계 최대 12개
- 프레임과 참조는 함께 사용할 수 없습니다. 시작 또는 종료 프레임을 사용하거나 참조를 사용하세요.
- 4초부터 최대 15초까지 유연한 생성 길이
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 480p, 720p
- 화면비: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 전체 해상도 렌더링 전에 Seedance 2.0 프롬프트 반복 작업
- 720p 출력으로 충분한 참조 기반 클립
비용: 선택한 설정과 길이에 따라 달라집니다
API: bytedance-seedance-v2-fast
Seedance 2.0 Fast는 미국에서 사용할 수 없습니다.
Seedance 2.0 Mini
가장 작은 Seedance 2.0 변형 모델로, 동일한 입력과 720p 출력을 제공하면서 Seedance 2.0보다 약 2배 빠르고 비용은 약 절반입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조(최대 9개)
- 비디오 참조(최대 3개, 합산 15초)
- 오디오 참조(최대 3개, 합산 15초)
기능:
- Seedance 2.0과 동일한 참조 처리 방식이며, 생성당 참조는 합계 최대 12개
- 프레임과 참조는 함께 사용할 수 없습니다. 시작 또는 종료 프레임을 사용하거나 참조를 사용하세요.
- 4초부터 최대 15초까지 유연한 생성 길이
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 480p, 720p
- 화면비: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 대량 초안 및 미리보기
- 오디오와 참조 입력이 필요하지만 비용에 민감한 워크플로
비용: 선택한 설정과 길이에 따라 달라집니다
API: bytedance-seedance-v2-mini
Seedance 2.0 Mini는 미국에서 사용할 수 없습니다.
Seedance 2.5
Seedance 2.0의 후속 모델로, 더 선명한 사실감, 합산 최대 50개의 이미지·비디오·오디오 참조, 최대 30초의 생성을 제공합니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조(최대 30개)
- 비디오 참조(최대 10개, 합산 30초)
- 오디오 참조(최대 10개, 합산 30초)
기능:
- 참조 유형 전체에 적용되는 합산 제한이 없으며, 이미지나 비디오 없이 오디오 참조만 사용할 수 있음
- 프레임과 참조는 함께 사용할 수 없음
- 4초부터 최대 30초까지 유연한 생성 길이
- 시작 프레임 또는 참조 비디오가 제공되면 해당 항목의 화면비를 사용
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 480p, 720p
- 화면비: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 많은 참조와 일관성을 유지해야 하는 긴 형식의 클립
- 참조 오디오로 구동되는 대화 및 연기 장면
비용: 선택한 설정과 길이에 따라 달라집니다
Seedance 2.5는 시드 제어 기능을 제공하지 않습니다.
Seedance 2.5는 미국에서 사용할 수 없습니다.
Seedance 2.5 비디오 편집
변경 사항을 설명하여 기존 비디오를 편집합니다. 출력 길이와 화면비는 입력 비디오를 따릅니다.
생성 입력:
- 편집할 비디오(필수, 최대 30초)
- 편집 내용을 설명하는 텍스트 프롬프트
- 이미지 참조(최대 30개)
- 추가 비디오 참조(최대 10개, 합산 30초)
- 오디오 참조(최대 10개, 합산 30초)
기능:
- 길이 제어 없음: 출력은 입력 비디오 길이와 동일함
- 입력 비디오의 화면비를 사용
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 480p, 720p
적합한 용도:
- 기존 영상의 의상, 소품, 조명 또는 배경 변경
- 원래 움직임을 보존하는 스타일 전환
비용: 선택한 설정과 길이에 따라 달라집니다
Seedance 2.5 Video Edit은 미국에서 사용할 수 없습니다.
Seedance 2.5 비디오 확장
프롬프트와 선택적 참조를 바탕으로 기존 비디오가 끝나는 지점부터 이어서 생성합니다.
생성 입력:
- 확장할 비디오(필수, 최대 30초)
- 이어질 내용을 설명하는 텍스트 프롬프트
- 이미지 참조(최대 30개)
- 추가 비디오 참조(최대 10개, 합산 30초)
- 오디오 참조(최대 10개, 합산 30초)
기능:
- 4초부터 최대 30초까지 확장 길이
- 입력 비디오의 화면비를 사용
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 480p, 720p
적합한 용도:
- 너무 일찍 끝나는 샷 연장
- 여러 생성 결과를 연결해 더 긴 시퀀스 제작
비용: 선택한 설정과 길이에 따라 달라집니다
Seedance 2.5 Video Extend는 미국에서 사용할 수 없습니다.
Kling 3.0
AI 감독처럼 작동하며, 복잡한 카메라 움직임 전반에서 캐릭터, 사물, 장면의 높은 일관성을 유지하는 고급 비디오 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
기능:
- 다각도 이미지 또는 비디오 참조를 사용한 고충실도 캐릭터 및 장면 유지
- 다국어 립싱크와 환경음을 포함한 네이티브 오디오·비주얼 동시 생성
- 3초부터 최대 15초까지 유연한 생성 길이
- 최대 4개의 변형을 동시에 생성
- 텍스트, 유체 역학, 복잡한 물리적 상호작용 처리 향상
출력 옵션:
- 해상도: 1080p만 지원
- 화면비: 16:9, 1:1, 9:16
적합한 용도:
- 시각적 연속성이 필요한 캐릭터 중심 스토리텔링
- 특정 텍스트 렌더링이 필요한 광고 및 에셋
비용: 선택한 설정과 길이에 따라 달라집니다
세밀한 제어를 위해 네거티브 프롬프트를 지원합니다. 생성별로 사운드를 활성화하거나 비활성화할 수 있습니다.
Kling 3.0은 미국에서 사용할 수 없습니다.
Kling O3
AI 감독처럼 작동하며, 복잡한 카메라 움직임 전반에서 캐릭터, 사물, 장면의 정체성을 보존하는 높은 일관성의 비디오 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 비디오 참조
- 이미지 참조
기능:
- 다각도 참조를 사용해 주요 캐릭터와 사물의 시각적 정체성을 정밀하게 유지
- 3초부터 최대 15초까지 매끄러운 생성 길이 지원
- 한 번에 최대 4개의 변형 생성
- 요소 간 상호작용과 움직임의 일관성을 정확하게 모델링
- 생성별 오디오 활성화 또는 비활성화를 네이티브로 지원
출력 옵션:
- 해상도: 1080p만 지원
- 화면비: 16:9, 1:1, 9:16
적합한 용도:
- 엄격한 시각적 연속성이 필요한 캐릭터 중심 스토리텔링
- 일관된 사물 렌더링이 필요한 전문 마케팅 및 브랜드 에셋
비용: 선택한 설정과 길이에 따라 달라집니다
설정을 전환하여 크레딧 사용량을 조정할 수 있습니다.
Kling O3는 미국에서 사용할 수 없습니다.
Kling O3 편집
O3 아키텍처 기반의 자연어 구동 비디오-비디오 편집 모델로, 수동 마스킹이나 프레임별 조정 없이 캐릭터 교체 및 환경 전환 같은 복잡한 시각적 변환을 수행할 수 있습니다.
생성 입력:
- 소스 비디오
- 이미지 참조(최대 4개의 고유 요소/각도)
- 텍스트 설명(자연어 지침)
기능:
- 대화형 프롬프트를 해석하여 원래의 움직임 구조를 유지하면서 피사체 또는 배경을 교체
- 편집 전반에서 원래 카메라 각도, 움직임 패턴, 공간적 관계를 유지
- 높은 충실도의 캐릭터 일관성을 위해 정면 및 다각도 이미지를 포함해 최대 총 4개 요소를 결합
- 생성별로 원본 소스 오디오를 유지하거나 무음 출력 생성 선택 가능
- 한 번에 최대 4개의 편집된 변형 생성
출력 옵션:
- 해상도: 소스 비디오에 따라 다름
- 화면비: 소스 비디오와 일치
적합한 용도:
- 원래 움직임을 유지하면서 기존 영상의 캐릭터를 고충실도로 교체
- 장면 환경 전체 변환(예: 낮의 도시를 미래적인 야경으로 변경)
- 기존 카메라 역학을 엄격히 따라야 하는 스타일 전환 적용
비용: 비디오 길이와 선택한 설정에 따라 달라집니다
Kling O3 Edit은 미국에서 사용할 수 없습니다.
Google Veo 3.1
고품질의 영화 같은 비디오 생성을 위한 전문가급 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조
기능:
- 네거티브 프롬프트를 통한 뛰어난 품질과 창의적 제어
- 완전히 통합되고 동기화된 오디오
- 사실적인 대화, 립싱크 및 음향 효과
- 고정 길이: 4초, 6초, 8초
- 한 번에 최대 4개 생성으로 일괄 제작
- 전용 사운드 제어
출력 옵션:
- 해상도: 720p, 1080p
- 화면비: 16:9, 9:16
적합한 용도:
- 완전한 창의적 제어가 가능한 고품질 영화적 비디오 생성
비용: 선택한 설정과 길이에 따라 달라집니다
API: veo-3.1-generate-001
사운드 활성화 여부에 따라 생성 크레딧이 달라집니다.
Google Veo 3.1 Fast
빠른 미리보기 및 생성을 위해 최적화된 고속 모델로, 더 낮은 지연 시간으로 더 선명한 영상을 제공합니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
기능:
- 네거티브 프롬프트와 전용 사운드 제어를 통한 고급 창의적 제어
- 고정 길이: 4초, 6초, 8초
- 한 번에 최대 4개 생성으로 일괄 제작
- 사실적인 움직임과 상호작용을 위해 현실 세계의 물리 법칙을 정확하게 모델링
출력 옵션:
- 해상도: 720p, 1080p
- 화면비: 16:9, 9:16
적합한 용도:
- 빠른 반복 작업 및 A/B 테스트 비주얼
- 빠르게 제작하는 소셜 미디어 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Google Veo 3.1 Lite
줄어든 연산량으로 빠른 생성을 지원하도록 최적화된, 비용 효율적인 고속 Veo 3.1 변형 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
기능:
- 네거티브 프롬프트와 전용 사운드 제어를 통한 세밀한 창의적 제어
- 고정 길이: 4초, 6초, 8초
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 720p
- 화면비: 16:9, 9:16
적합한 용도:
- 속도와 비용 효율성을 우선하는 대량 콘텐츠 제작
- 빠른 콘셉트 탐색 및 미리보기
비용: 선택한 설정과 길이에 따라 달라집니다
Gemini Omni Flash 1.1
네이티브 오디오, 최대 4K 출력, 프레임 보간 및 참조 기반 생성을 모두 지원하는 Google의 물리 인식 비디오 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조(최대 10개)
- 비디오 참조(최대 3개, 각 최대 10초)
기능:
- 프레임과 참조는 함께 사용할 수 없습니다. 프레임 간 보간을 사용하거나 참조로 안내하세요.
- 3초부터 10초까지 고정 길이이며, 참조 비디오가 연결된 경우 해당 비디오의 길이를 따름
- 짧은 화면 내 텍스트와 레이블을 강력하게 렌더링
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 360p, 720p, 1080p, 4K
- 화면비: 16:9, 9:16
적합한 용도:
- 읽기 쉬운 텍스트가 포함된 설명 영상 및 키네틱 타이포그래피
- 참조 전반에서 피사체를 일관되게 유지하는 물리 기반 움직임
비용: 선택한 설정과 길이에 따라 달라집니다
Gemini Omni Flash 1.1 확장
Gemini Omni Flash 1.1을 사용해 기존 비디오가 끝나는 지점부터 이어서 생성하며, 총 길이는 최대 40초입니다.
생성 입력:
- 확장할 비디오(필수, 최대 30초)
- 이어질 내용을 설명하는 텍스트 프롬프트
기능:
- 3초부터 10초까지 확장 길이
- 입력 비디오의 화면비를 따름
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 360p, 720p, 1080p, 4K
적합한 용도:
- 눈에 띄는 컷 없이 Gemini Omni Flash 생성 결과 연장
- 단일 생성으로 가능한 길이보다 긴 시퀀스 제작
비용: 선택한 설정과 길이에 따라 달라집니다
Gemini Omni Flash
최초의 Gemini Omni 비디오 모델입니다. 720p에서 물리 인식 움직임, 네이티브 오디오, 사용 가능한 비디오 모델 중 가장 뛰어난 화면 내 텍스트 렌더링을 제공합니다.
생성 입력:
- 텍스트-비디오
- 이미지 참조(최대 8개)
- 비디오 참조(1개, 최대 10초)
기능:
- 3초부터 10초까지 고정 길이이며, 참조 비디오가 연결된 경우 해당 비디오의 길이를 따름
- 시작 또는 종료 프레임 없음. 대신 이미지 참조를 사용해 피사체를 고정하세요.
- 한 번에 최대 4개 생성으로 일괄 제작
출력 옵션:
- 해상도: 720p
- 화면비: 16:9, 9:16
적합한 용도:
- 짧은 캡션, 제목 및 레이블이 있는 설명 영상
- 720p에서의 다중 이미지 일관성
비용: 선택한 설정과 길이에 따라 달라집니다
Seedance 1.5 Pro
향상된 시간적 안정성과 키프레임 간 정밀한 전환 제어를 통해 역동적이고 고충실도인 시퀀스를 제작하는 업그레이드된 특화 모델입니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임
- 종료 프레임
기능:
- 시작 및 종료 프레임을 매끄럽게 연결하여 일관된 멀티샷 시퀀스 생성
- 복잡한 동작과 환경 일관성을 고충실도로 모델링
- 4초부터 12초까지 고정 생성 길이 지원
- 한 번에 최대 4개의 변형 생성
- 생성별 오디오 활성화 또는 비활성화 기본 지원
출력 옵션:
- 해상도: 420p, 720p
- 화면 비율: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 특정 시각적 기준점 사이에서 안정적인 물리 표현이 필요한 스토리텔링 및 액션 장면
- 엄격한 시작/종료 요구 사항이 있는 시네마틱 전환 및 전문 비디오 에셋
비용: 선택한 설정과 길이에 따라 달라집니다
Seedance 1.5 Pro는 더 이상 사용되지 않습니다. ByteDance는 2026년 11월 11일에 이 모델을 종료하며, 더 이상 새 생성에 제공되지 않습니다. 대신 Seedance 2.0 모델을 사용하세요. Seedance 1.5 Pro는 미국에서 사용할 수 없습니다.
FLUX 3
자연스러운 움직임, 멀티샷 장면, 생성 오디오 및 비디오 확장 기능을 제공하는 Black Forest Labs의 비디오 모델입니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임
- 종료 프레임
- 확장할 비디오(1개, 최대 15초)
기능:
- 비디오 확장 기능은 시작 및 종료 프레임과 함께 사용할 수 없습니다
- 5초부터 20초까지 유연한 생성 길이 제공
- 생성별 오디오 활성화 또는 비활성화가 가능한 기본 사운드 제어
- 한 번에 최대 4개 생성으로 배치 제작
출력 옵션:
- 해상도: 720p, 1080p
- 화면 비율: 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 단일 프롬프트로 멀티샷 장면 제작
- 일치하는 움직임과 오디오로 기존 클립 확장
비용: 선택한 설정과 길이에 따라 달라집니다
MiniMax H3
멀티모달 참조, 생성 오디오 및 최대 4K 출력 기능을 갖춘 MiniMax의 플래그십 비디오 모델입니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조(최대 9개)
- 비디오 참조(최대 3개, 각각 2초~15초, 합계 15초)
- 오디오 참조(최대 3개, 각각 2초~15초, 합계 15초)
기능:
- 생성당 참조는 총 12개까지 가능하며, 오디오 참조를 사용하려면 이미지 또는 비디오 참조가 최소 하나 필요합니다
- 프레임과 참조는 함께 사용할 수 없습니다
- 5초부터 15초까지 유연한 생성 길이 제공
- 동기화된 오디오 생성
- 한 번에 최대 4개 생성으로 배치 제작
출력 옵션:
- 해상도: 480p, 768p, 2K, 4K(2K 및 4K는 768p에서 업스케일됨)
- 화면 비율: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 고해상도 결과물이 필요한 참조 기반 장면
- 참조 오디오로 구동되는 대화 클립
비용: 선택한 설정과 길이에 따라 달라집니다
MiniMax H3는 미국에서 사용할 수 없습니다.
MiniMax H3 Max
MiniMax H3와 동일한 입력 및 뛰어난 미학을 제공하며, 최대 768p로 네이티브 렌더링되는 거의 즉각적인 변형 모델입니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임
- 종료 프레임
- 이미지 참조(최대 9개)
- 비디오 참조(최대 3개, 각각 2초~15초, 합계 15초)
- 오디오 참조(최대 3개, 각각 2초~15초, 합계 15초)
기능:
- 생성당 참조는 총 12개까지 가능하며, 오디오 참조를 사용하려면 이미지 또는 비디오 참조가 최소 하나 필요합니다
- 프레임과 참조는 함께 사용할 수 없습니다
- 5초부터 15초까지 유연한 생성 길이 제공
- 동기화된 오디오 생성
- 한 번에 최대 4개 생성으로 배치 제작
출력 옵션:
- 해상도: 480p, 768p
- 화면 비율: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 프롬프트와 참조의 빠른 반복 작업
- MiniMax H3로 렌더링하기 전 미리보기
비용: 선택한 설정과 길이에 따라 달라집니다
MiniMax H3 Max는 미국에서 사용할 수 없습니다.
Kling O1
고급 논리 처리를 활용해 복잡한 지침을 해석하고 실행하며, 뛰어난 프롬프트 준수와 복잡한 물리 세계 시뮬레이션을 위해 설계된 최첨단 추론 비디오 모델입니다.
생성 입력:
- 텍스트-투-비디오(설명)
- 시작 프레임 및 종료 프레임
- 비디오 참조
- 이미지 참조
기능:
- 다층적인 프롬프트를 해석하고 복잡한 시간 순서의 동작을 실행하는 탁월한 능력
- 이미지와 비디오를 모두 시각적 기준점으로 활용하여 높은 캐릭터 및 장면 일관성 유지
- 물리적 상호작용, 인과관계 및 유체 역학을 뛰어나게 모델링
- 5초 및 10초 클립의 고품질 생성 지원
- 한 번에 최대 4개의 변형 생성
출력 옵션:
- 해상도: 입력에 따라 다름
- 화면 비율: 16:9, 1:1, 9:16
적합한 용도:
- 길고 상세한 설명을 정확히 준수해야 하는 매우 구체적인 창작 콘셉트
- 물리적 사실감과 다중 참조 일관성이 중요한 전문 스토리텔링
비용: 선택한 설정과 길이에 따라 달라집니다
Kling O1은 미국에서 사용할 수 없습니다.
Kling O1 Edit
수동 마스킹이나 프레임별 조정 없이 캐릭터 교체 및 환경 전환과 같은 복잡한 시각적 변환을 수행할 수 있는 자연어 기반 비디오-투-비디오 편집 모델입니다.
생성 입력:
- 소스 비디오
- 이미지 참조(최대 4개의 개별 요소/각도)
- 텍스트 설명(자연어 지침)
기능:
- 원래의 움직임 구조를 유지하면서 대화형 프롬프트를 해석해 피사체 또는 설정 교체
- 편집 전반에 걸쳐 원래 카메라 각도, 움직임 패턴 및 공간 관계 유지
- 높은 캐릭터 일관성을 위해 정면 및 다각도 이미지를 포함한 총 최대 4개 요소 결합
- 생성별로 원본 소스 오디오를 유지하거나 무음 출력 생성 옵션 제공
- 한 번에 최대 4개의 편집 변형 생성
출력 옵션:
- 해상도: 소스 비디오에 따라 다름
- 화면 비율: 소스 비디오와 일치
적합한 용도:
- 원래 움직임을 유지하면서 기존 영상의 캐릭터를 고충실도로 교체
- 장면 환경을 완전히 변환(예: 낮의 도시를 미래적인 야경으로 변경)
- 기존 카메라 움직임을 엄격히 준수해야 하는 스타일 전환 적용
비용: 비디오 길이와 선택한 설정에 따라 달라집니다
Kling O1 Edit는 미국에서 사용할 수 없습니다.
Kling 2.6 Motion Control
참조 비디오로 캐릭터 이미지를 구동해 특정 움직임, 제스처 및 카메라 각도를 재현할 수 있는 정밀 모션 전송 특화 모델입니다.
생성 입력:
- 캐릭터 이미지(소스)
- 모션 비디오(참조)
- 텍스트 설명(선택 사항)
기능:
- 정확한 모션 재현에는 “Match Video”를, 캐릭터에 새로운 창의적 움직임을 추가하려면 “Match Image”를 선택
- Match Video 모드에서 최대 30초, Match Image 모드에서 최대 10초 지원
- 참조 영상의 사람 움직임을 정지된 캐릭터에 고충실도로 매핑
- 생성별 오디오 활성화 또는 비활성화 기본 지원
- 한 번에 최대 4개의 변형 생성
출력 옵션:
- 해상도: 소스에 따라 다름
- 화면 비율: 소스에 따라 다름
적합한 용도:
- 맞춤 캐릭터에 복잡한 안무 또는 특정 움직임 재현
- 높은 모션 충실도가 필요한 장편 캐릭터 애니메이션
- 인기 비디오 동작을 활용한 소셜 미디어 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Kling 2.6 Motion Control은 미국에서 사용할 수 없습니다.
Kling 3.0 Motion Control
Kling 3.0 아키텍처를 기반으로 구축된 정밀 모션 전송 특화 모델로, 참조 비디오로 캐릭터 이미지를 구동해 특정 움직임, 제스처 및 카메라 각도를 더욱 높은 충실도로 재현할 수 있습니다.
생성 입력:
- 캐릭터 이미지(소스)
- 모션 비디오(참조)
- 텍스트 설명(선택 사항)
기능:
- 정확한 모션 재현에는 “Match Video”를, 캐릭터에 새로운 창의적 움직임을 추가하려면 “Match Image”를 선택
- Match Video 모드에서 최대 30초, Match Image 모드에서 최대 10초 지원
- 참조 영상의 사람 움직임을 정지된 캐릭터에 고충실도로 매핑
- 생성별 오디오 활성화 또는 비활성화 기본 지원
- 한 번에 최대 4개의 변형 생성
출력 옵션:
- 해상도: 소스에 따라 다름
- 화면 비율: 소스에 따라 다름
적합한 용도:
- 맞춤 캐릭터에 복잡한 안무 또는 특정 움직임 재현
- 높은 모션 충실도가 필요한 장편 캐릭터 애니메이션
- 인기 비디오 동작을 활용한 소셜 미디어 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Kling 3.0 Motion Control은 미국에서 사용할 수 없습니다.
Kling 2.6
향상된 모션 충실도와 더욱 매끄러운 전환을 위해 설계된 최적화 생성 모델로, 고속 반복 작업과 프로덕션 품질의 시각적 출력 간 균형을 제공합니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임(이미지-투-비디오)
기능:
- 향상된 모션 역학: 움직임의 유동성과 사실적인 물리 상호작용이 크게 개선됨
- 유연한 사운드 제어: 생성별 오디오 활성화 또는 비활성화 기본 지원
- 배치 제작: 최대 4개의 변형을 동시에 생성
- 세밀한 개선: 네거티브 프롬프트 지원을 통한 고급 창작 제어
- 고정 길이: 5초 및 10초 생성 길이 지원
출력 옵션:
- 해상도: 입력에 따라 다름
- 화면 비율: 16:9, 1:1, 9:16
적합한 용도:
- 유동적인 캐릭터 움직임이 필요한 고동작 클립
- 프롬프트 준수도가 뛰어난 전문 수준의 소셜 미디어 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Kling 2.6은 미국에서 사용할 수 없습니다.
Kling 2.5
고품질 풀 HD 비디오 생성을 위한 균형 잡히고 다재다능한 모델입니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임
기능:
- 복잡한 움직임과 사실적인 물리 시뮬레이션에 탁월함
- 유체 역학과 표정을 정확하게 모델링
- 고정 길이: 5초 및 10초
- 한 번에 최대 4개 생성으로 배치 제작
출력 옵션:
- 해상도: 1080p
- 화면 비율: 16:9, 1:1, 9:16
적합한 용도:
- 사실적인 물리 시뮬레이션 및 복잡한 움직임
비용: 선택한 설정과 길이에 따라 달라집니다
현재 종료 프레임은 지원되지 않습니다. 이미지 참조를 제공할 수 없습니다. 사운드 제어는 사용할 수 없습니다.
Kling 2.5는 미국에서 사용할 수 없습니다.
Runway Gen-4.5
시네마틱하고 매우 사실적인 비디오를 위한 최첨단 모션 품질, 프롬프트 준수도 및 시각적 충실도를 제공합니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임(이미지-투-비디오)
기능:
- 업계 최고 수준의 사실감과 물리 시뮬레이션을 제공하는 탁월한 모션 품질
- 복잡한 장면을 정밀하게 창작 제어할 수 있는 뛰어난 프롬프트 준수도
- 시네마틱 등급의 출력을 제공하는 높은 시각적 충실도
- 최대 4개의 변형을 동시에 생성
출력 옵션:
- 해상도: 720p
- 화면 비율: 16:9, 9:16
적합한 용도:
- 최고 수준의 모션 품질과 사실감이 필요한 시네마틱 콘텐츠
- 정밀한 프롬프트 준수가 필요한 전문 제작물
- 고충실도 시각적 스토리텔링
비용: 선택한 설정과 길이에 따라 달라집니다
Runway Gen-4 Turbo
빠른 반복 작업과 비용 효율적인 제작을 위해 설계된 고급 비디오 모델로, 고품질 비디오를 제작할 수 있습니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임(이미지-투-비디오)
기능:
- 초고속 생성에 최적화되어 이전 버전보다 최대 4배 빠른 결과 제공
- 캐릭터 움직임, 카메라 각도 및 장면 구성을 정밀하게 지시 가능
- 역동적인 장면 전반에서 시각적 일관성과 안정성을 유지하는 데 탁월함
- 2초부터 10초까지의 생성 길이 지원
- 최대 4개의 변형을 동시에 생성
출력 옵션:
- 해상도: 720p
- 화면 비율: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 거의 즉각적인 피드백이 필요한 빠른 프로토타이핑 및 창의적 실험
- 고해상도 마케팅 에셋을 빠르게 제작해야 하는 전문 프로젝트
- 특정 카메라 움직임이 필요한 시네마틱 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Runway Gen-4 Aleph
소스 영상의 기본 구조를 유지하면서 복잡한 편집을 수행할 수 있도록 설계된 최첨단 인컨텍스트 비디오 모델로, 멀티태스크 시각적 생성을 지원합니다.
생성 입력:
- 소스 비디오
- 참조 이미지
- 텍스트 설명
기능:
- 자연스러운 조명, 그림자 및 원근감을 유지하며 장면 내 객체와 피사체를 매끄럽게 추가, 제거 또는 변환
- 사실적인 색온도 업데이트를 통해 장소, 계절 및 시간대 변경(예: 흐린 영상을 극적인 일몰로 변환)
- 간단한 자연어 프롬프트로 배우의 나이와 외모를 수정하거나 의상 및 피사체의 텍스처 변경
- 정밀한 애니메이션 제어를 위해 참조 비디오의 특정 움직임과 카메라 경로를 정지 이미지에 적용
- 단일 기존 비디오 시퀀스에서 리버스 샷이나 로우 앵글 같은 완전히 새로운 카메라 각도 생성
- 정밀한 그린 스크리닝(에지 감지를 통한 분리), 스토리 연속성을 위한 다음 샷 생성 및 미적 스타일 전환 포함
- 최대 4개의 변형을 동시에 생성
출력 옵션:
- 해상도: 720p
- 화면 비율: 자동
적합한 용도:
- 디지털 디에이징, 재조명 및 객체 제거와 같은 전문 시각 효과 작업
- 빠른 시네마틱 프로토타이핑 및 단일 샷에서 대체 카메라 커버리지 생성
- 과감한 환경 또는 스타일 변환이 필요한 창의적인 마케팅 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Runway Aleph 2.0
Runway의 비디오 편집 모델로, 움직임과 일관성을 유지하면서 기존 비디오를 목표 스타일로 변환합니다.
입력:
- 소스 비디오(필수, 2초~30초)
- 목표 스타일 이미지(필수)
- 편집 내용을 설명하는 텍스트 프롬프트
기능:
- 출력 길이와 프레이밍은 소스 비디오를 따름
- 목표 스타일 이미지로 유도되는 스타일 전환
- 한 번에 최대 4개 생성으로 배치 제작
적합한 용도:
- 기존 영상의 재조명, 스타일 변경 또는 배경 변경
- 참조 이미지의 스타일을 전체 클립에 적용
비용: 선택한 설정과 길이에 따라 달라집니다
Runway Act-Two
드라이빙 비디오의 움직임, 음성 및 표정을 캐릭터 이미지 또는 비디오 참조에 매핑하여 캐릭터를 애니메이션화하는 특화 퍼포먼스 전송 모델입니다.
생성 입력:
- 드라이빙 퍼포먼스(비디오)
- 캐릭터 입력(이미지 또는 비디오)
기능:
- 소스 배우의 섬세한 표정, 립싱크 및 동기화된 오디오를 모든 캐릭터에 직접 전송
- 더욱 자연스러운 표현을 위해 정지 캐릭터 이미지에 보조 움직임과 미세한 카메라 흔들림을 자동으로 추가
- 캐릭터 이미지를 사용할 때 몸과 손 움직임을 활성화하거나 비활성화하는 정밀 토글 제공
- 강렬한 감정 연기와 캐릭터 시각적 일관성 간의 균형을 조정할 수 있는 설정 제공
- 드라이빙 퍼포먼스와 완벽하게 정렬된 상태를 유지하며 생성 후 캐릭터 음성 변경 가능
출력 옵션:
- 해상도: 720p
- 화면 비율: 자동
적합한 용도:
- 사실적인 사람의 움직임과 음성으로 정지 캐릭터 초상화에 생동감 부여
- 비인간 캐릭터 또는 스타일화된 아바타를 고충실도 표정으로 애니메이션화
- 몸짓이 통합된 토킹헤드 콘텐츠를 빠르게 제작
비용: 선택한 설정과 길이에 따라 달라집니다
Seedance 1 Pro
큰 움직임과 액션이 있는 역동적인 멀티샷 시퀀스를 제작하기 위한 특화 모델입니다.
생성 입력:
- 텍스트-투-비디오
- 시작 프레임
- 종료 프레임
기능:
- 매우 안정적인 물리 표현과 샷 간 매끄러운 전환
- 고정 길이: 3초, 4초, 5초, 6초, 7초, 8초, 9초, 10초, 11초 및 12초
- 한 번에 최대 4개 생성으로 배치 제작
- 다양한 화면 비율 옵션으로 최대의 창작 유연성 제공
출력 옵션:
- 해상도: 480p, 720p, 1080p
- 화면 비율: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 안정적인 물리 표현이 필요한 스토리텔링 및 액션 장면
비용: 선택한 설정과 길이에 따라 달라집니다
화면 비율과 해상도는 생성 크레딧에 영향을 주지 않지만, 길이는 영향을 줍니다.
Seedance 1 Pro는 미국에서 사용할 수 없습니다.
LTX 오디오-비디오
동기화된 비디오와 오디오를 한 번에 생성하도록 설계된 DiT 기반 파운데이션 모델로, 일관된 음성과 사실적인 움직임을 보장합니다.
생성 입력:
- 텍스트-비디오
- 이미지-비디오
- 오디오-비디오
- 깊이-비디오
기능:
- 외부 도구 없이 대사, 입술 움직임, 주변 오디오를 동시에 생성해 완벽하게 동기화
- 안정적인 움직임, 일관된 정체성, 프레임 간 높은 일관성을 갖춘 역동적인 장면
- 최대 20초까지 고화질 동기화 생성 지원
- 세분화된 네거티브 프롬프트 지원을 통한 고급 크리에이티브 제어
- 한 번에 최대 4가지 변형 생성
출력 옵션:
- 해상도: 720p, 1080p
- 화면 비율: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 일관된 음성과 풍부한 표현력을 갖춘 캐릭터 연기
- 통합된 주변 오디오와 일관된 타이밍이 필요한 내러티브 콘텐츠
- 복잡한 카메라 인식 움직임 로직이 필요한 역동적인 장면
비용: 선택한 설정과 길이에 따라 달라집니다
LTX 2 Pro
유려한 움직임과 함께 프로덕션급 4K 출력을 제작할 수 있도록, 최대 수준의 시각적 디테일과 구조적 안정성에 최적화된 고화질 생성 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임(이미지-비디오)
기능:
- 속도보다 시각적 품질과 일관성을 우선시하여 긴 시퀀스에서도 안정적인 결과 제공
- 탁월하게 부드럽고 전문적인 움직임을 위한 25 FPS 및 50 FPS 지원
- 사운드 켜기 또는 끄기 토글을 제공하는 통합 오디오-비주얼 생성
- 디테일 손실 없이 네이티브 1080p, 2k, 4k 출력 처리
- 한 번에 최대 4가지 변형 생성
출력 옵션:
- 해상도: 1080p, 2k, 4k
- 프레임 레이트: 25 FPS, 50 FPS
- 화면 비율: 16:9(기본값)
- 길이: 6초, 8초, 10초
적합한 용도:
- 4K 선명도가 필요한 고해상도 시네마틱 제작
- 부드러운 50 FPS 움직임이 필요한 전문 콘텐츠
- 시각적 안정성과 구조적 완성도가 중요한 디테일한 시퀀스
비용: 선택한 설정과 길이에 따라 달라집니다
LTX 2 Retake
연속성을 해치거나 전체 시퀀스를 다시 생성하지 않고도 기존 샷 내의 대사, 감정, 동작을 정밀하게 수정할 수 있는 AI 디렉팅 도구입니다.
생성 입력:
- 소스 비디오
- 텍스트 설명
기능:
- 주변 프레임의 컨텍스트를 강력하게 보존하면서 특정 구간 수정
- 캐릭터의 목소리, 연기, 환경을 일관되게 유지하면서 대사 변경
- 다양한 편집 모드: “오디오 & 비디오”, “오디오만”, “비디오만” 중에서 선택해 샷의 특정 요소를 분리하고 다시 생성
- 새로운 콘텐츠가 원본의 움직임, 조명, 톤을 자연스럽게 이어받아 매끄럽게 전환
- 하나의 샷 안에서 대체 캐릭터 반응, 감정적 비트, 카메라 움직임을 즉시 실험
- 나란히 비교할 수 있도록 최대 4가지 변형을 동시에 생성
출력 옵션:
- 화면 비율: 16:9만 지원
적합한 용도:
- 재촬영이나 재녹음 없이 스크립트 조정 및 대사 다듬기
- 후반 작업에서 감정적 비트 또는 페이싱 문제 수정
- 하나의 마케팅 에셋에서 여러 브랜드 메시지와 CTA 테스트
비용: 선택한 설정과 길이에 따라 달라집니다
LTX 2 Fast
빠른 피드백 루프와 고속 콘텐츠 제작을 위해 설계된 속도 최적화 생성 모델로, 렌더링 시간을 크게 줄이면서 고해상도 비주얼을 제공합니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임(이미지-비디오)
기능:
- 속도와 빠른 반복에 맞춰 설계되어 신속한 비주얼 실험과 거의 즉각적인 미리보기 제공
- Pro 모델보다 낮은 컴퓨팅 오버헤드로 네이티브 1080p, 2k, 4k 출력 지원
- 고속에서도 부드러운 움직임을 위한 25 FPS 및 50 FPS 지원
- 최대 20초 길이의 동기화된 오디오-비주얼 콘텐츠를 빠르게 생성
- 생성별로 오디오 활성화 또는 비활성화를 기본 지원
- 최대 4가지 변형을 동시에 생성
출력 옵션:
- 해상도: 1080p, 2k, 4k
- 프레임 레이트: 25 FPS, 50 FPS
- 화면 비율: 16:9(기본값)
- 길이: 6초, 8초, 10초, 12초, 14초, 16초, 18초, 20초
적합한 용도:
- 최대 디테일보다는 속도를 우선하는 빠른 프로토타이핑 및 크리에이티브 탐색
- 빠른 제작 주기가 필요한 대량의 소셜 미디어 콘텐츠
- 다양한 비주얼 콘셉트와 움직임 스타일의 A/B 테스트
비용: 선택한 설정과 길이에 따라 달라집니다
Wan 3.0
이미지, 비디오, 오디오 레퍼런스와 생성된 오디오를 지원하며 최대 30초 길이로 생성할 수 있는 시네마틱 비디오 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 레퍼런스(최대 10개)
- 비디오 레퍼런스(최대 5개, 합산 15초)
- 오디오 레퍼런스(최대 5개, 합산 15초)
기능:
- 프레임과 레퍼런스는 함께 사용할 수 없음
- 고정 길이: 5초, 10초, 15초, 20초, 30초
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 선택적 프롬프트 개선
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 480p, 720p, 1080p
- 화면 비율: 자동, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 프롬프트를 잘 따르는 긴 시네마틱 샷
- 오디오가 포함된 레퍼런스 기반 장면
비용: 선택한 설정과 길이에 따라 달라집니다
Wan 3.0은 미국에서 사용할 수 없습니다.
Wan 3.0 Prime
Wan 3.0과 동일한 입력 및 출력 옵션을 제공하며, 아이디어 구상에 적합한 더 빠른 버전입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임
- 종료 프레임
- 이미지 레퍼런스(최대 10개)
- 비디오 레퍼런스(최대 5개, 합산 15초)
- 오디오 레퍼런스(최대 5개, 합산 15초)
기능:
- Wan 3.0 대비 약 절반의 생성 시간
- 고정 길이: 5초, 10초, 15초, 20초, 30초
- 생성별로 오디오를 활성화하거나 비활성화할 수 있는 네이티브 사운드 제어
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 480p, 720p, 1080p
- 화면 비율: 자동, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 최종 Wan 3.0 렌더링 전 아이디어 탐색
- 빠른 완료가 중요한 workflow
비용: 선택한 설정과 길이에 따라 달라집니다
Wan 3.0 Prime은 미국에서 사용할 수 없습니다.
Wan 2.6
통합 멀티모달 아키텍처를 활용해 네이티브 오디오 동기화 및 지능형 멀티샷 시퀀싱을 지원하는 프로덕션용 1080p 콘텐츠를 제공하는 차세대 시네마틱 비디오 플랫폼입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임(이미지-비디오)
- 비디오 레퍼런스(비디오-비디오)
- 오디오 레퍼런스(선택 사항: 배경 오디오 또는 대사)
기능:
- 통합 멀티모달 시스템: 텍스트, 이미지, 비디오, 오디오를 하나의 통합 프레임워크로 처리하여 일관된 출력 품질 제공
- 네이티브 오디오 동기화: 대사, 내레이션, 환경 음향 효과를 화면 속 움직임에 맞춰 자동으로 생성 및 정렬
- 지능형 멀티샷 시퀀싱: 연결된 비디오 시퀀스를 캐릭터 일관성을 유지하면서 자연스러운 스토리 아크로 자동 구성
- 확장된 길이: 5초, 10초, 15초의 고정 길이에서 안정적이고 고품질의 생성 지원
- 고급 크리에이티브 제어: 세분화된 디테일 관리를 위한 네거티브 프롬프트 및 최대 4가지 변형의 배치 제작 지원
출력 옵션:
- 해상도: 720p, 1080p
- 화면 비율: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 전문적인 내러티브 스토리텔링 및 복잡한 멀티샷 시네마틱 시퀀스
- 통합된 고화질 오디오가 필요한 소셜 미디어 광고 및 마케팅 콘텐츠
- 비디오 레퍼런스를 통해 엄격한 시각적·움직임 일관성이 필요한 캐릭터 중심 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
Wan 2.6은 미국에서 사용할 수 없습니다.
Wan 2.5 Video
텍스트 또는 시작 이미지로부터 시네마틱한 움직임과 높은 프롬프트 충실도를 제공하는 다목적 모델입니다.
생성 입력:
- 텍스트-비디오
- 시작 프레임(이미지-비디오)
기능:
- 네거티브 프롬프트와 전용 사운드 제어를 통한 세분화된 크리에이티브 제어
- 고정 길이: 5초 및 10초
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 480p, 720p, 1080p
- 화면 비율: 16:9, 1:1, 9:16
적합한 용도:
- 프롬프트를 잘 따르는 시네마틱 콘텐츠
비용: 선택한 설정과 길이에 따라 달라집니다
생성 비용은 선택한 설정에 따라 달라집니다.
Wan 2.5 Video는 미국에서 사용할 수 없습니다.
이미지 생성 모델
GPT Image 2.5 Sunburst
매우 세밀한 출력과 정밀한 편집을 위한 OpenAI의 프로덕션급 이미지 모델입니다.
생성 입력:
- 텍스트-이미지
- 이미지 레퍼런스(최대 10개)
기능:
- 낮음부터 최대까지 5가지 품질 수준
- 최대 3:1 화면 비율에서 변 길이당 최대 3840px의 맞춤 해상도
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 1K, 2K, 4K 또는 맞춤 설정
- 화면 비율: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
적합한 용도:
- 디테일과 충실도가 가장 중요한 최종 에셋
- 기존 이미지의 정밀한 편집
비용: 선택한 설정과 변형 수에 따라 달라집니다
GPT Image 2.5 Flare
Sunburst와 동일한 제어 기능을 제공하며, 일상적인 대량 생성에 맞춰 조정된 빠른 GPT Image 2.5 버전입니다.
생성 입력:
- 텍스트-이미지
- 이미지 레퍼런스(최대 10개)
기능:
- 낮음부터 최대까지 5가지 품질 수준
- 최대 3:1 화면 비율에서 변 길이당 최대 3840px의 맞춤 해상도
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 1K, 2K, 4K 또는 맞춤 설정
- 화면 비율: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
적합한 용도:
- 대량 이미지 생성
- 4K와 맞춤 크기가 여전히 필요한 빠른 반복 작업
비용: 선택한 설정과 변형 수에 따라 달라집니다
API: gpt-image-2.5-flare
GPT Image 2
향상된 텍스트 렌더링과 고해상도 출력 기능을 갖춘 정밀 이미지 생성을 위해 설계된 고급 AI 모델입니다.
기능:
- 정확한 타이포그래피와 선명도를 갖춘 이미지를 만들기 위한 정밀한 텍스트 제어
- 전문 및 상업적 용도에 적합한 고해상도 PNG 출력
- 스타일과 구성을 안내할 수 있도록 여러 이미지 레퍼런스 지원
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면 비율: 3:2, 1:1, 2:3
- 품질 옵션: 낮음, 중간, 높음
적합한 용도:
- 정밀한 텍스트 배치가 필요한 마케팅 비주얼 및 디자인 에셋
- 고해상도 요구 사항이 있는 전문 콘텐츠
- 정확한 텍스트 기반 이미지 제어가 필요한 크리에이티브 프로젝트
비용: 선택한 설정과 변형 수에 따라 달라집니다
API: gpt-image-2
Nano Banana 2
향상된 세계 지식과 피사체 일관성을 갖추고, 프로덕션용 품질과 초고속 처리를 결합한 고급 AI 이미지 생성 모델입니다.
기능:
- 업스케일링 없이 네이티브 4K 해상도로 선명한 디테일 제공
- 최소 1~2초 만에 이루어지는 초고속 이미지 생성
- 고급 추론 및 지시 이행을 통한 뛰어난 프롬프트 충실도
- 목업, 표지판, 인포그래픽을 위한 여러 언어의 선명하고 정확한 텍스트 렌더링
- 여러 캐릭터와 객체에서 정체성을 보존하는 일관된 다중 피사체 스타일링
- 더욱 정확한 장면 생성을 위한 향상된 세계 지식
- 생성을 안내할 수 있도록 여러 이미지 레퍼런스 지원
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면 비율: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- 해상도: 최대 4K
적합한 용도:
- 실시간 반복 작업이 필요한 빠른 크리에이티브 workflow
- 일관된 캐릭터 정체성을 갖춘 브랜드 콘텐츠와 스토리텔링
- 정확한 텍스트와 타이포그래피를 갖춘 전문 비주얼
비용: 선택한 설정과 변형 수에 따라 달라집니다
Nano Banana 2 Lite
1K에서 빠른 생성 및 편집을 위한 Nano Banana 2의 빠르고 저비용인 버전입니다.
생성 입력:
- 텍스트-이미지
- 이미지 레퍼런스(최대 14개)
기능:
- 일관된 속도와 비용을 위한 고정 1K 출력
- Nano Banana 2와 동일한 14개 이미지 레퍼런스 지원
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 1K
- 화면 비율: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
적합한 용도:
- 빠른 반복 작업 및 초안
- 1K로 충분한 대량 편집
비용: 선택한 설정과 변형 수에 따라 달라집니다
Krea 2 Medium
다양한 크리에이티브 workflow에서 품질과 속도의 균형을 제공하는 Krea AI의 다목적 프로덕션용 이미지 생성 모델입니다.
기능:
- 높은 프롬프트 충실도의 고화질 이미지 생성
- 생성을 안내할 수 있도록 여러 이미지 레퍼런스 지원
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면 비율: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 일관된 품질이 필요한 전문 콘텐츠 제작
- 다양한 크리에이티브 콘셉트에 대한 빠른 반복 작업
비용: 선택한 설정과 변형 수에 따라 달라집니다
Krea 2 Large
전문 제작 workflow를 위해 최고의 시각적 충실도와 고급 크리에이티브 제어를 제공하는 Krea AI의 플래그십 이미지 생성 모델입니다.
기능:
- 전문가급 출력에 적합한 탁월한 디테일과 사실감
- 여러 이미지 레퍼런스를 지원하는 고급 스타일 제어
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면 비율: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 고급 상업 및 에디토리얼 이미지 제작
- 최대 수준의 충실도가 필요한 복잡한 크리에이티브 구성
비용: 선택한 설정과 변형 수에 따라 달라집니다
Recraft V4.1
뛰어난 프롬프트 제어와 깔끔한 구성을 제공하는 디자인 중심의 텍스트-이미지 모델입니다.
생성 입력:
- 텍스트-이미지
기능:
- 2K 출력에는 Pro 모델 버전 사용
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 1K, 2K
- 화면 비율: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
적합한 용도:
- 레이아웃 중심의 그래픽, 아이콘, 포스터
- 텍스트만으로 만드는 깔끔한 구성
비용: 선택한 설정과 변형 수에 따라 달라집니다
Recraft V4
레퍼런스 이미지의 스타일을 맞출 수 있는 디자인 중심 이미지 모델입니다.
생성 입력:
- 텍스트-이미지
- 스타일 레퍼런스(최대 10개)
기능:
- 스타일 일치 제어: Precise는 레퍼런스 스타일을 정확히 따르고, Flexible은 전반적인 느낌을 맞춤
- 2K 출력에는 Pro 모델 버전 사용
- 한 번에 최대 4개 생성하는 배치 제작
출력 옵션:
- 해상도: 1K, 2K
- 화면 비율: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
적합한 용도:
- 여러 스타일 레퍼런스를 활용한 브랜드 일관성 있는 그래픽
- 일러스트레이션 및 디자인 작업
비용: 선택한 설정과 변형 수에 따라 달라집니다
Seedream 5 Lite
낮은 컴퓨팅 요구 사항으로 고품질 결과를 제공하는 ByteDance의 경량 고속 이미지 생성 모델입니다.
기능:
- 빠른 크리에이티브 반복 작업을 위한 신속한 생성
- 생성을 안내할 수 있도록 여러 이미지 레퍼런스 지원
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면 비율: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 속도가 필요한 대량 이미지 제작 workflow
- 빠른 콘셉트 탐색 및 미리보기
비용: 선택한 설정과 변형 수에 따라 달라집니다
API: bytedance-seedream-5-lite
Seedream 5 Lite는 미국에서 사용할 수 없습니다.
Seedream 5 Pro
정밀 편집, 다국어 텍스트, 고밀도 인포그래픽에 적합한 고충실도 Seedream 5 버전입니다.
생성 입력:
- 텍스트-이미지
- 이미지 참조(최대 10개)
기능:
- 정확한 다국어 텍스트 렌더링
- 인포그래픽 및 포스터와 같은 고밀도 레이아웃 처리
- 한 번에 최대 4개 생성으로 배치 생성
출력 옵션:
- 해상도: 1K, 2K
- 화면비: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 여러 언어의 텍스트 중심 디자인
- 참조 이미지 충실도가 엄격하게 요구되는 다중 이미지 편집
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Seedream 5 Pro는 미국에서 이용할 수 없습니다.
GPT Image 1.5
정밀한 텍스트 기반 이미지 생성과 원본 세부 정보를 보존하는 복잡한 비파괴 사진 편집을 위해 설계된 고속 플래그십 모델입니다.
기능:
- 원본 이미지 내 조명, 구도, 피사체 외형의 무결성을 유지하면서 요청한 변경 사항을 안정적으로 수행
- 요소 추가, 제거, 결합, 블렌딩을 포함한 복잡한 편집 작업 지원
- 이전 버전보다 최대 4배 빠른 결과물 제공
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 3:2, 1:1, 2:3
- 품질 옵션: 낮음, 중간, 높음
적합한 용도:
- 실용적인 사진 보정 및 의류 또는 헤어스타일의 사실적인 가상 착용
- 입력 이미지의 본질을 유지하는 개념적 변환과 스타일 필터
- 텍스트-이미지 콘셉트의 빠른 반복 작업
비용: 선택한 설정 및 변형 수에 따라 달라집니다
API: gpt-image-1.5
GPT Image 1
우수한 프롬프트 준수, 읽기 쉬운 텍스트, 세밀한 편집 기능을 갖춘 OpenAI의 1세대 이미지 모델입니다.
생성 입력:
- 텍스트-이미지
- 이미지 참조(최대 5개)
기능:
- 세 가지 품질 수준: 낮음, 중간, 높음
- 한 번에 최대 4개 생성으로 배치 생성
출력 옵션:
- 화면비: 3:2, 1:1, 2:3
적합한 용도:
- 이미 GPT Image 1 출력 중심으로 구축된 워크플로
- 표준 해상도에서의 간단한 편집 및 이미지 내 텍스트 작업
비용: 선택한 설정 및 변형 수에 따라 달라집니다
API: gpt-image-1
Seedream 4.5
텍스트-이미지 합성, 정밀 이미지 편집, 복잡한 다중 이미지 구성을 하나의 효율적인 프레임워크로 통합한 고성능 멀티모달 기반 모델입니다.
기능:
- 최대 4K 해상도의 고충실도 이미지를 빠르게 생성하도록 기본 지원
- 참조 입력 기반 편집 작업 중 얼굴 특징, 조명, 색조, 미세한 디테일을 탁월하게 보존
- 여러 입력 이미지에서 대상 요소를 정확하게 식별하고 혼합하여 제어 가능하고 일관된 결과 제공
- 포스터 및 브랜드 비주얼의 작은 텍스트를 선명하고 정확하게 렌더링하는 디자이너 수준의 구도 기능 제공
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 16:9, 4:3, 1:1, 3:4, 9:16
- 해상도: 2K, 4K
적합한 용도:
- 정밀한 레이아웃과 타이포그래피가 필요한 전문 그래픽 디자인 워크플로
- 참조 인물의 정체성과 조명을 엄격하게 준수해야 하는 복잡한 사진 편집
- 여러 시각 소스를 활용한 고해상도 창의적 합성
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Seedream 4.5는 미국에서 이용할 수 없습니다.
Kling O1 Image
복잡한 구성에서도 뛰어난 프롬프트 준수와 정밀한 시각적 일관성을 제공하도록 설계된 고급 추론 기능의 고충실도 이미지 생성 모델입니다.
기능:
- 복잡하고 다층적인 텍스트 설명을 높은 정확도로 해석하고 실행하는 탁월한 능력
- 이미지 참조를 활용해 생성 결과 전반에서 피사체 정체성, 조명, 미적 스타일 유지
- 사실적인 질감, 복잡한 공간 관계, 전문 수준의 조명 효과에 최적화
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 자동, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- 해상도: 1K, 2K
적합한 용도:
- 세부적이고 기술적인 텍스트 프롬프트를 엄격하게 준수해야 하는 전문 크리에이티브 에셋
- 시각 참조를 활용한 고일관성 이미지 편집 및 캐릭터 디자인
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Kling O1 Image는 미국에서 이용할 수 없습니다.
FLUX.2 [Pro]
속도, 정밀도, 일관성에 중점을 두고 최첨단 시각 품질을 제공하도록 설계된 전문 워크플로용 프로덕션급 이미지 생성 및 편집 모델입니다.
기능:
- 여러 이미지를 동시에 참조하여 수백 개 에셋 전반에서 업계 최고 수준의 캐릭터 및 정체성 일관성 달성
- 직물 질감부터 건축 요소까지 실제 사진과의 격차를 좁히는 전례 없는 수준의 디테일 품질 제공
- 복잡한 타이포그래피, UI 목업, 인포그래픽을 위한 프로덕션 준비 수준의 텍스트 렌더링 제공
- 근사 없이 16진수 코드를 통해 정밀한 브랜드 색상 지정 지원
- 복잡한 장면 전반에서 정확한 객체 배치, 사실적인 물리, 일관된 조명, 올바른 원근감 보장
- 구조화되고 복잡한 지시에 대한 정확도와 반응성을 높이도록 최적화
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 16:9, 4:3, 1:1, 3:4, 9:16
- 해상도: 720p, 1080p, 2K
적합한 용도:
- 캐릭터 일관성을 유지하는 캠페인 운영 및 어떤 맥락에서도 정확한 제품 배치
- 읽기 쉬운 텍스트와 일관된 시각 디자인 시스템을 갖춘 인터페이스 목업 제작
- 대규모 제품 사진 및 맥락에 맞는 라이프스타일 이미지 생성
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Nano Banana Pro
고충실도 에셋 제작, 고급 크리에이티브 제어, 정밀한 지시 준수를 위해 설계된 전문급 추론 기반 이미지 생성 및 편집 모델입니다.
입력:
- 이미지 참조
- 텍스트 설명(복잡하고 다층적인 프롬프트 지원)
기능:
- 렌더링 전 장면을 계획하여 물리적으로 정확한 조명, 정확한 객체 관계, 뛰어난 프롬프트 준수 제공
- 강렬한 포스터와 제품 목업을 위해 다양한 글꼴 스타일과 손글씨로 선명하고 읽기 쉬운 다국어 텍스트 생성
- 다양한 크리에이티브 결과물 전반에서 최대 5명의 인물과 여러 객체의 높은 충실도 및 유사성 유지
- Google Search를 통합하여 실제 데이터, 현실 세계 지식, 날씨나 스포츠 같은 실시간 정보로 비주얼 강화
- 고급 로컬 편집 도구로 카메라 앵글, 초점, 장면 조명(예: 낮을 밤으로 변환) 조정
- 뛰어난 공간 이해를 통해 정확한 인포그래픽, 기술 다이어그램, 프레젠테이션 슬라이드 생성
- 한 번에 최대 4개 변형 생성
출력 옵션:
- 해상도: 1K, 2K, 4K
- 화면비: 자동, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
적합한 용도:
- 전문 광고, 브랜드 에셋, 고급 이커머스 제품 사진
- 교육용 설명 자료, 데이터 기반 인포그래픽, 복잡한 기술 문서
- 일관된 캐릭터 또는 브랜드 정체성을 갖춘 고해상도 시각 디자인의 빠른 프로토타이핑
비용: 선택한 설정 및 변형 수에 따라 달라집니다
API: gemini-3-pro-image
Nano Banana
텍스트 프롬프트로 바로 빠르고 고품질의 이미지 생성 및 편집을 지원하는 고속 모델입니다.
기능:
- 생성을 안내하는 여러 이미지 참조 지원
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
적합한 용도:
- 빠른 이미지 제작 및 반복 작업
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Runway Gen-4 Image
장면 전반의 일관성을 유지할 수 있는 전례 없는 스타일 제어와 시각적 메모리를 제공하도록 설계된 고충실도 이미지 생성용 고급 기반 모델입니다.
기능:
- 입력 이미지를 사용해 캐릭터, 스타일, 특정 객체를 고정하여 여러 결과물에서 전문 수준의 일관성 유지
- 시각적 세부 사항, 조명, 감정을 정밀하게 제어할 수 있도록 복잡한 자연어 설명 해석에 최적화
- 영화적 스토리보드부터 전문 제품 사진까지 다양한 용도의 고품질 비주얼 생성 가능
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 16:9, 4:3, 1:1, 3:4, 9:16
- 해상도: 720p, 1080p
적합한 용도:
- 다양한 환경과 조명 처리에서도 주인공의 외형 유지
- 고해상도 브랜드 에셋, 가상 착용 이미지, 확장 가능한 제품 시각화의 신속한 제작
- 이미지 참조를 통해 핵심 시각 정체성을 고정하면서 다양한 예술적 방향 탐색
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Runway Gen-4 Image Turbo
표준 Gen-4 Image와 동일한 출력 품질을 유지하면서 2.5배 빠른 결과를 제공하도록 속도에 맞춰 설계된 최적화 이미지 생성 모델입니다.
기능:
- 최적화된 처리로 짧은 시간 안에 고충실도 이미지를 생성하여 빠른 크리에이티브 탐색 지원
- 특정 캐릭터, 환경, 예술 스타일에 대한 모델의 이해를 안내하기 위해 최대 3개의 참조 이미지 업로드
- 참조 이미지의 특정 시각 특성을 인코딩하여 여러 생성 결과에서 정체성을 유지함으로써 시각적 드리프트 문제 해결
- 참조 이미지의 미학, 조명, 질감을 완전히 새로운 피사체와 장면에 손쉽게 적용
- 시드 파라미터를 사용해 변형을 체계적으로 탐색하거나 특정 결과물을 정밀하게 재현
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 16:9, 4:3, 1:1, 3:4, 9:16
- 해상도: 720p, 1080p
적합한 용도:
- Instagram 스토리(9:16) 또는 표준 게시물(1:1)에 최적화된 비주얼의 대규모 신속 제작
- 브랜드 스타일 가이드를 참조 이미지로 사용해 캠페인 전반에서 엄격한 시각 정체성 유지
- 주인공의 인지 가능성을 유지하면서 일관된 캐릭터 포즈와 설정 개발
- 참조 기반 가이드를 통해 다양한 라이프스타일 및 계절별 제품 사진을 정확하게 제작
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Seedream 4
큰 움직임과 액션이 있는 멀티샷 시퀀스 또는 장면을 생성하기 위한 특화 이미지 모델입니다.
기능:
- 안정적인 물리와 일관된 전환을 갖춘 이미지 제작에 탁월
- 생성을 안내하는 여러 이미지 참조 지원
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 자동, 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- 액션 장면 및 역동적인 구성
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Seedream 4는 미국에서 이용할 수 없습니다.
Wan 2.5 Image
뛰어난 프롬프트 충실도와 참조 이미지 지원을 갖춘 Wan 2.5의 이미지 변형입니다.
생성 입력:
- 텍스트-이미지
- 이미지 참조(최대 2개)
기능:
- 네거티브 프롬프트 및 시드 제어
- 한 번에 최대 4개 생성으로 배치 생성
출력 옵션:
- 화면비: 16:9, 4:3, 1:1, 3:4, 9:16
적합한 용도:
- Wan 비디오 생성 결과의 스타일과 일치하는 스틸 이미지
- 프롬프트에 충실한 콘셉트 이미지
비용: 선택한 설정 및 변형 수에 따라 달라집니다
Wan 2.5 Image는 미국에서 이용할 수 없습니다.
FLUX.1 Kontext [Pro]
뛰어난 장면 일관성과 스타일 제어를 제공하는 고급 이미지 생성 및 편집용 전문 모델입니다.
기능:
- 시각적 미학을 안내하기 위해 참조 이미지가 필요한 이미지 기반 스타일 제어
- 한 번에 최대 4개 이미지 생성
출력 옵션:
- 화면비: 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
적합한 용도:
- 정밀한 스타일 요구 사항이 있는 전문 콘텐츠
비용: 선택한 설정 및 변형 수에 따라 달라집니다
립싱크 모델
Creatify Aurora
오디오와 텍스트 지시를 기반으로 반응하는 초현실적 아바타를 렌더링하도록 설계된 최첨단 확산 트랜스포머(DiT) 모델입니다.
생성 입력:
- 아바타(소스 이미지)
- 음성(오디오 파일)
- 텍스트 설명(지시)
기능:
- 기본 립싱크를 넘어 문맥을 인식하는 눈 깜빡임, 호흡, 자연스러운 표정까지 구현
- 음성 톤과 억양을 기반으로 손과 전신 움직임을 자동으로 동기화하여 스튜디오급 퍼포먼스 구현
- 음성의 강도와 음높이를 정확히 해석하여 퍼포먼스에 충실한 감정 표현 제공
- 긴 대화나 음악 퍼포먼스에서도 높은 캐릭터 충실도와 행동 일관성 유지
- 측면 앵글 프레젠테이션, 팟캐스트 스타일 대화, 스타일화된 애니메이션 등 다양한 설정에 최적화
- 한 번에 최대 4가지 변형 생성
출력 옵션:
- 해상도: 480p, 720p
적합한 용도:
- 전문 아바타 기반 비디오 광고 및 마케팅 콘텐츠
- 고충실도 가상 스토리텔링 및 표현력 있는 음악 퍼포먼스
- 일관된 캐릭터 등장이 필요한 장편 교육 또는 트레이닝 비디오
비용: 입력, 설정 및 길이에 따라 달라집니다
API: creatify-aurora
Veed Fabric
정지 이미지를 제공된 오디오에 맞춰 애니메이션화하는 빠르고 정밀한 이미지-투-비디오 립싱크 모델입니다.
입력:
- 소스 이미지
- 음성 오디오 파일
기능:
- 소스 이미지의 입과 표정을 제공된 오디오에 맞춰 애니메이션화
- 정지 이미지에서 고충실도 “말하는” 비디오 생성
- 전체 비디오 생성 모델이 아닌 립싱크 전용 도구
적합한 용도:
- 정지 이미지로 말하는 아바타 만들기
- 캐릭터 초상화에 대화 추가
- 전문 아바타 기반 콘텐츠 워크플로
비용: 입력, 설정 및 길이에 따라 달라집니다
최상의 결과를 위해 이미지에 감지 가능한 인물이 포함되어야 합니다.
HeyGen Avatar 4
단일 이미지와 오디오 입력으로 매우 사실적이고 표현력 있는 토킹헤드 비디오를 생성하는 HeyGen의 최신 아바타 모델입니다.
입력:
- 소스 이미지
- 음성 오디오 파일
기능:
- 제공된 오디오에 맞춰 표정과 입 움직임을 고충실도로 애니메이션화
- 자연스러운 머리 움직임과 미세한 표정을 생성해 생생한 결과 제공
- 전체 비디오 생성 모델이 아닌 립싱크 전용 도구
적합한 용도:
- 전문 대변인 및 발표자 비디오
- 개인화된 아바타 콘텐츠 대규모 제작
- 일관된 캐릭터 등장이 필요한 마케팅 및 트레이닝 비디오
비용: 입력, 설정 및 길이에 따라 달라집니다
최상의 결과를 위해 이미지에 얼굴이 선명하게 보여야 합니다.
Sync 3
다양한 콘텐츠 유형에서 스튜디오 품질의 동기화를 제공하는 Sync의 최신 세대 비디오 립싱크 모델입니다.
생성 입력:
- 소스 비디오
- 음성 오디오
기능:
- 고유한 얼굴 디테일, 자연스러운 치아, 피부 질감을 보존하는 고정확도 립싱크
- 실사, 3D 애니메이션, AI 생성 비디오를 포함한 모든 콘텐츠 유형에 최적화
- 전체 비디오 생성기가 아닌 비디오-투-비디오 립싱크 도구
적합한 용도:
- 영화 및 광고용 전문 더빙과 현지화
- 모든 비디오 형식에서 대화 개선 또는 수정
- 대량 콘텐츠 번역 워크플로
비용: 입력, 설정 및 길이에 따라 달라집니다
최상의 결과를 위해 비디오에 감지 가능한 인물이 포함되어야 합니다.
Sync Lipsync 2 Pro
고해상도 출력까지 확장하면서 고유한 얼굴 디테일을 보존하도록 설계된 스튜디오급 립싱크용 최첨단 비디오 편집 모델입니다.
생성 입력:
- 소스 비디오
- 음성 오디오
기능:
- 선명하고 자연스러운 질감을 유지하면서 4K 출력을 지원하는 고급 업스케일링 적용
- 자연스러운 치아, 주근깨, 메이크업, 복잡한 수염과 같은 고유한 얼굴 특징을 선명도 손실 없이 보호
- 실사, 3D 애니메이션, AI 생성 비디오를 포함한 모든 콘텐츠 유형에서 작동하도록 최적화
- 화자별 학습이나 모델 미세 조정 없이 즉시 표현력 있고 동기화된 결과 제공
- 최대 4가지 변형 동시 생성
적합한 용도:
- 영화 및 고급 광고용 전문 수준 더빙 및 현지화 콘텐츠
- 3D 애니메이션 및 AI 생성 캐릭터의 대화 개선 또는 수정
- 픽셀 단위로 정확한 얼굴 일관성과 디테일이 필요한 고해상도 프로젝트
비용: 입력, 설정 및 길이에 따라 달라집니다
OmniHuman 1.5
매우 사실적이고 인간 같은 립싱크 생성을 위한 전용 유틸리티 모델입니다.
입력:
- 정적 소스 이미지
- 음성 오디오 파일
기능:
- 소스 이미지의 입을 제공된 오디오에 맞춰 애니메이션화
- 정지 이미지에서 고충실도 “말하는” 비디오 생성
- 전체 비디오 생성 모델이 아닌 립싱크 전용 도구
적합한 용도:
- 말하는 아바타 만들기
- 정지 이미지에 대화 추가
- 전문 더빙 워크플로
비용: 입력, 설정 및 길이에 따라 달라집니다
최상의 결과를 위해 이미지에 감지 가능한 인물이 포함되어야 합니다.
OmniHuman 1.5는 미국에서 사용할 수 없습니다.
Veed Lipsync
비디오에 사실적인 립싱크를 적용하는 빠르고 경제적이며 정밀한 유틸리티 모델입니다.
입력:
- 소스 비디오
- 새 음성 오디오 파일
기능:
- 소스 비디오의 입 움직임을 새 오디오에 맞춰 다시 애니메이션화
- 전체 비디오 생성기가 아닌 비디오-투-비디오 립싱크 도구
적합한 용도:
- 대량의 비용 효율적인 더빙
- 콘텐츠 번역
- 비디오 클립의 오디오를 사실적으로 수정
비용: 입력, 설정 및 길이에 따라 달라집니다
최상의 결과를 위해 비디오에 감지 가능한 인물이 포함되어야 합니다.
Veed Lipsync 2.0
기존 비디오에 사실적인 립싱크를 적용하기 위한 Veed Lipsync의 고품질 후속 모델입니다.
입력:
- 소스 비디오
- 새 음성 오디오 파일
기능:
- 소스 비디오의 입 움직임을 새 오디오에 맞춰 다시 애니메이션화
- 전체 비디오 생성기가 아닌 비디오-투-비디오 립싱크 도구
- 한 번에 최대 4개 생성으로 일괄 제작
적합한 용도:
- 비용보다 출력 품질이 중요한 더빙 및 번역
- 완성된 클립의 대화 수정
비용: 입력, 설정 및 길이에 따라 달라집니다
최상의 결과를 위해 비디오에 감지 가능한 인물이 포함되어야 합니다.
유틸리티 모델
Topaz Upscale
해상도와 디테일을 최대 4배까지 향상하도록 설계된 이미지 및 비디오 업스케일링 전용 유틸리티 모델입니다.
기능:
- 기존 미디어를 처리하는 향상 도구
- 자연스러운 질감을 보존하고 아티팩트를 최소화하면서 미디어 크기 확대
- 매우 세분화된 업스케일 배율: 1x, 1.25x, 1.5x, 1.75x, 2x, 3x, 4x
- 비디오 전용: 유연한 프레임 레이트 제어(소스 유지 또는 24, 25, 30, 48, 50, 60fps로 변환)
적합한 용도:
- 생성된 미디어의 품질 향상
- 이전 영상 또는 사진 복원
- 고해상도 디스플레이용 에셋 준비
비용: 입력에 따라 달라집니다
배경 제거
이미지에서 배경을 제거하고 알파 투명도가 적용된 상태로 반환합니다.
입력:
- 소스 이미지
기능:
- 프롬프트 불필요
- 실행당 단일 출력
적합한 용도:
- 제품 누끼 및 합성
- 다른 생성 작업에서 참조로 사용할 피사체 준비
비용: 입력에 따라 달라집니다
Runway Ruby
표준 다이내믹 레인지 비디오를 HDR로 변환합니다.
입력:
- 소스 비디오(최대 30초)
기능:
- 프롬프트 불필요
- 실행당 단일 출력, 길이와 프레이밍은 소스를 따름
적합한 용도:
- HDR 디스플레이용 영상 준비
- 납품을 위해 생성된 비디오 색보정 재작업
비용: 비디오 길이에 따라 달라집니다
자주 묻는 질문
|
|