流式文本转语音

本指南介绍如何流式传输文本转语音,以及如何选择性地将音频上传至 AWS S3。

本指南介绍 3 种方法:将语音生成为文件、直接流式传输音频响应,以及可选地将生成的音频上传到 AWS S3 存储桶,通过签名 URL 分享。

本指南假设你已设置 API 密钥和 SDK。如果尚未完成,请先完成快速入门。可选的 S3 上传部分还需要拥有可访问 S3 的 AWS 账户。

想了解流式传输为何如此运作?了解音频流式传输深入讲解了协议、缓冲和延迟之间的权衡。

将文本转换为语音(文件)

要将文本转换为语音并保存为文件,我们将使用 ElevenLabs SDK 的 convert 方法,然后在本地将其保存为 .mp3 文件。

import os
import uuid
from dotenv import load_dotenv
from elevenlabs import VoiceSettings
from elevenlabs.client import ElevenLabs
load_dotenv()
ELEVENLABS_API_KEY = os.getenv("ELEVENLABS_API_KEY")
elevenlabs = ElevenLabs(
api_key=ELEVENLABS_API_KEY,
)
def text_to_speech_file(text: str) -> str:
# Calling the text_to_speech conversion API with detailed parameters
response = elevenlabs.text_to_speech.convert(
voice_id="pNInz6obpgDQGcFmaJgB", # Adam pre-made voice
output_format="mp3_22050_32",
text=text,
model_id="eleven_flash_v2_5", # use the flash model for low latency
# Optional voice settings that allow you to customize the output
voice_settings=VoiceSettings(
stability=0.0,
similarity_boost=1.0,
style=0.0,
use_speaker_boost=True,
speed=1.0,
),
)
# uncomment the line below to play the audio back
# play(response)
# Generating a unique file name for the output MP3 file
save_file_path = f"{uuid.uuid4()}.mp3"
# Writing the audio to a file
with open(save_file_path, "wb") as f:
for chunk in response:
if chunk:
f.write(chunk)
print(f"{save_file_path}: A new audio file was saved successfully!")
# Return the path of the saved audio file
return save_file_path

然后可以通过以下方式运行此函数:

text_to_speech_file("Hello World")

将文本转换为语音(流式传输)

如果希望直接流式传输音频而不保存为文件,可以使用流式传输功能。

import os
from typing import IO
from io import BytesIO
from dotenv import load_dotenv
from elevenlabs import VoiceSettings
from elevenlabs.client import ElevenLabs
load_dotenv()
ELEVENLABS_API_KEY = os.getenv("ELEVENLABS_API_KEY")
elevenlabs = ElevenLabs(
api_key=ELEVENLABS_API_KEY,
)
def text_to_speech_stream(text: str) -> IO[bytes]:
# Perform the text-to-speech conversion
response = elevenlabs.text_to_speech.stream(
voice_id="pNInz6obpgDQGcFmaJgB", # Adam pre-made voice
output_format="mp3_22050_32",
text=text,
model_id="eleven_multilingual_v2",
# Optional voice settings that allow you to customize the output
voice_settings=VoiceSettings(
stability=0.0,
similarity_boost=1.0,
style=0.0,
use_speaker_boost=True,
speed=1.0,
),
)
# Create a BytesIO object to hold the audio data in memory
audio_stream = BytesIO()
# Write each chunk of audio data to the stream
for chunk in response:
if chunk:
audio_stream.write(chunk)
# Reset stream position to the beginning
audio_stream.seek(0)
# Return the stream for further use
return audio_stream

然后可以通过以下方式运行此函数:

text_to_speech_stream("This is James")

进阶:上传至 AWS S3 并获取安全分享链接

音频数据生成后,无论是文件还是流,你可能都希望与用户分享。一种方法是将其上传到 AWS S3 存储桶并生成安全分享链接。

要将数据上传至 S3,需要将 AWS 访问密钥 ID、私密访问密钥和 AWS 区域名称添加到 .env 文件。按以下步骤查找凭证:

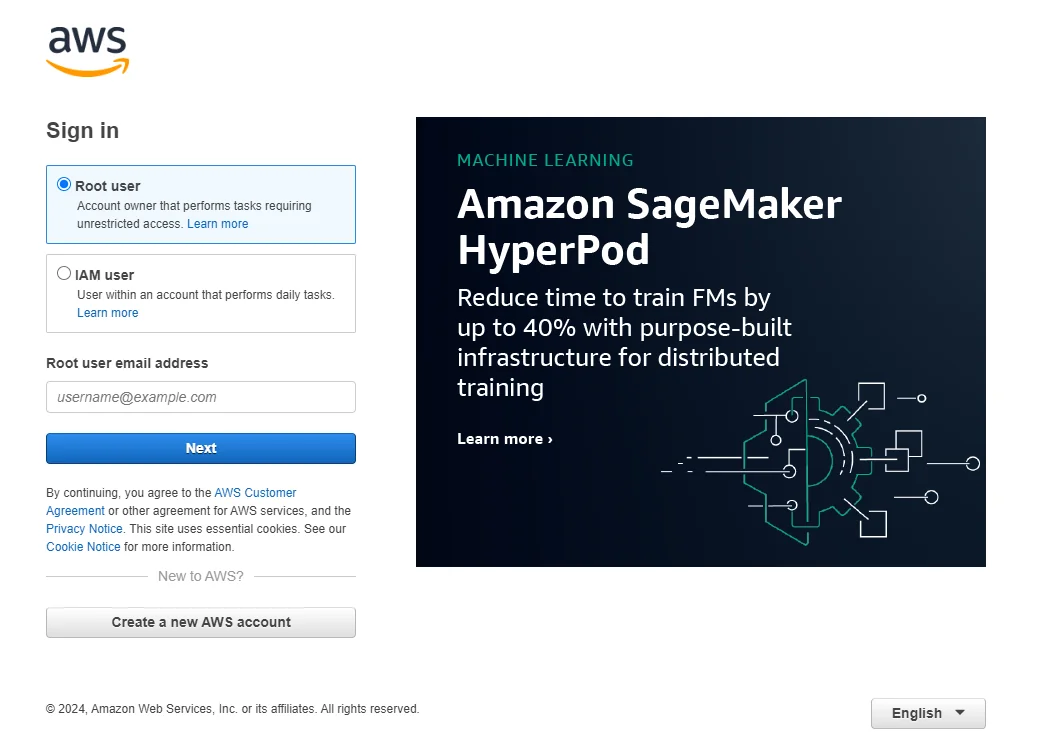
  1. 登录 AWS 管理控制台:前往 AWS 首页并使用账户登录。
AWS 控制台登录
  1. 打开 IAM(身份与访问管理)控制面板:可在服务菜单的“安全、身份与合规性”下找到 IAM。IAM 控制面板可安全管理对 AWS 服务的访问权限。
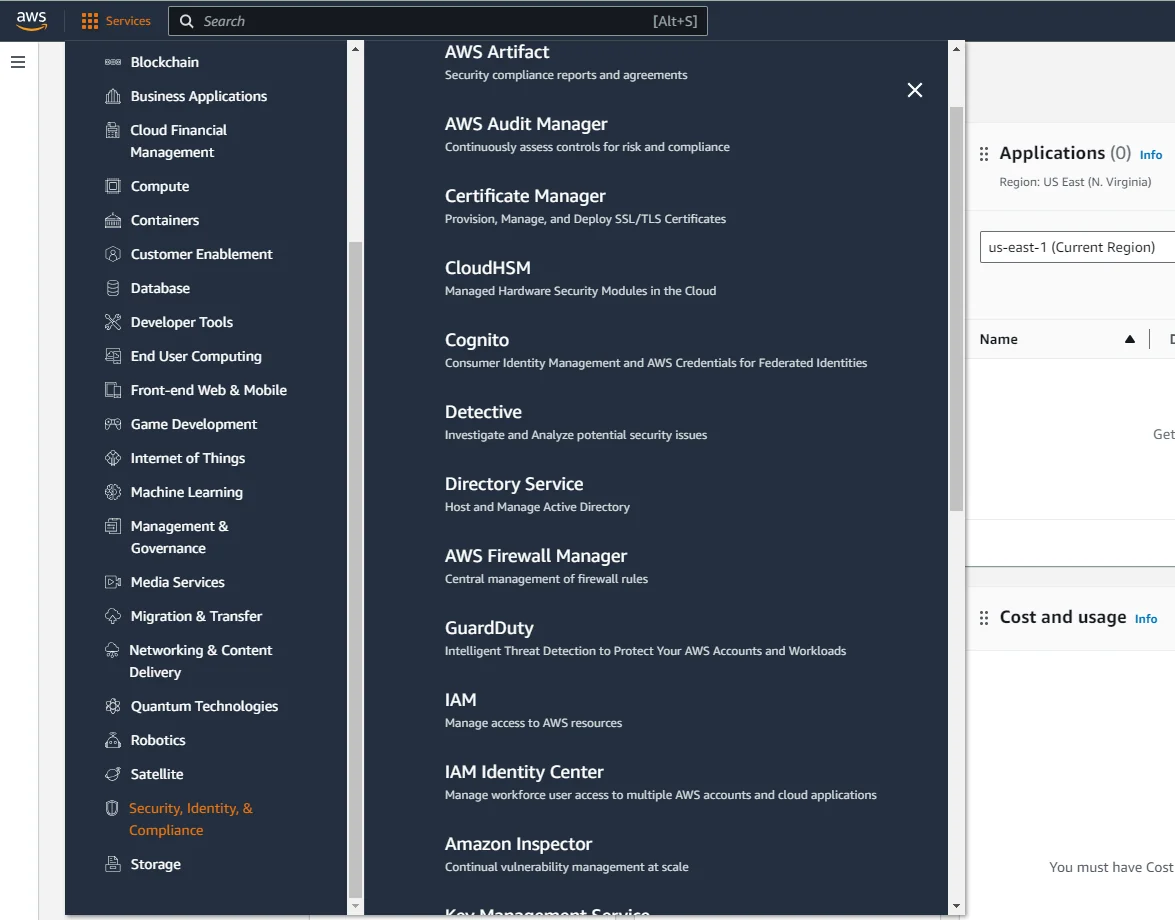
AWS IAM 控制面板
  1. 创建新用户(如有需要):在 IAM 控制面板中,选择“用户”,然后选择“添加用户”。输入用户名。
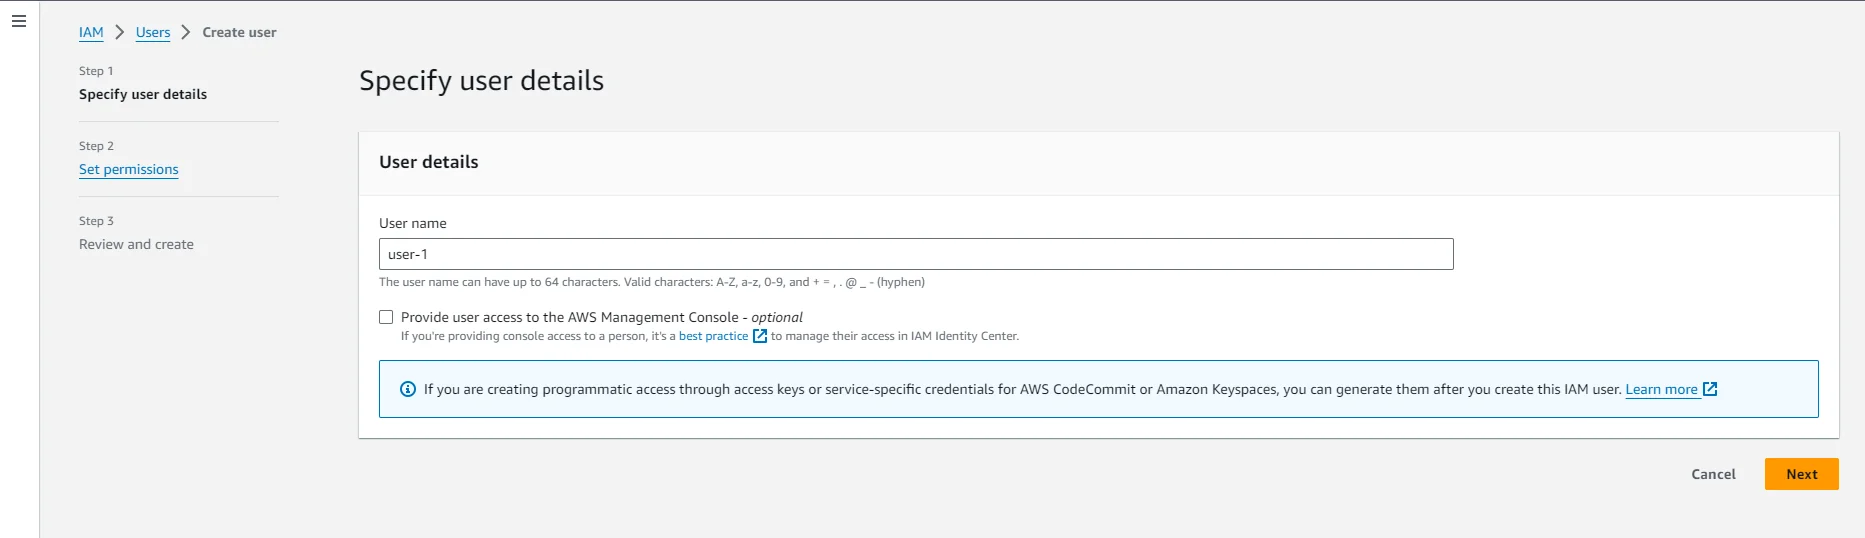
添加 AWS IAM 用户
  1. 设置权限:根据希望授予的访问级别,直接为用户附加策略。对于 S3 上传,可以使用 AmazonS3FullAccess 策略。不过,最佳实践是遵循最小权限原则,只授予完成任务所需的最低权限。你可能需要创建自定义策略,仅允许对 S3 存储桶执行必要操作。
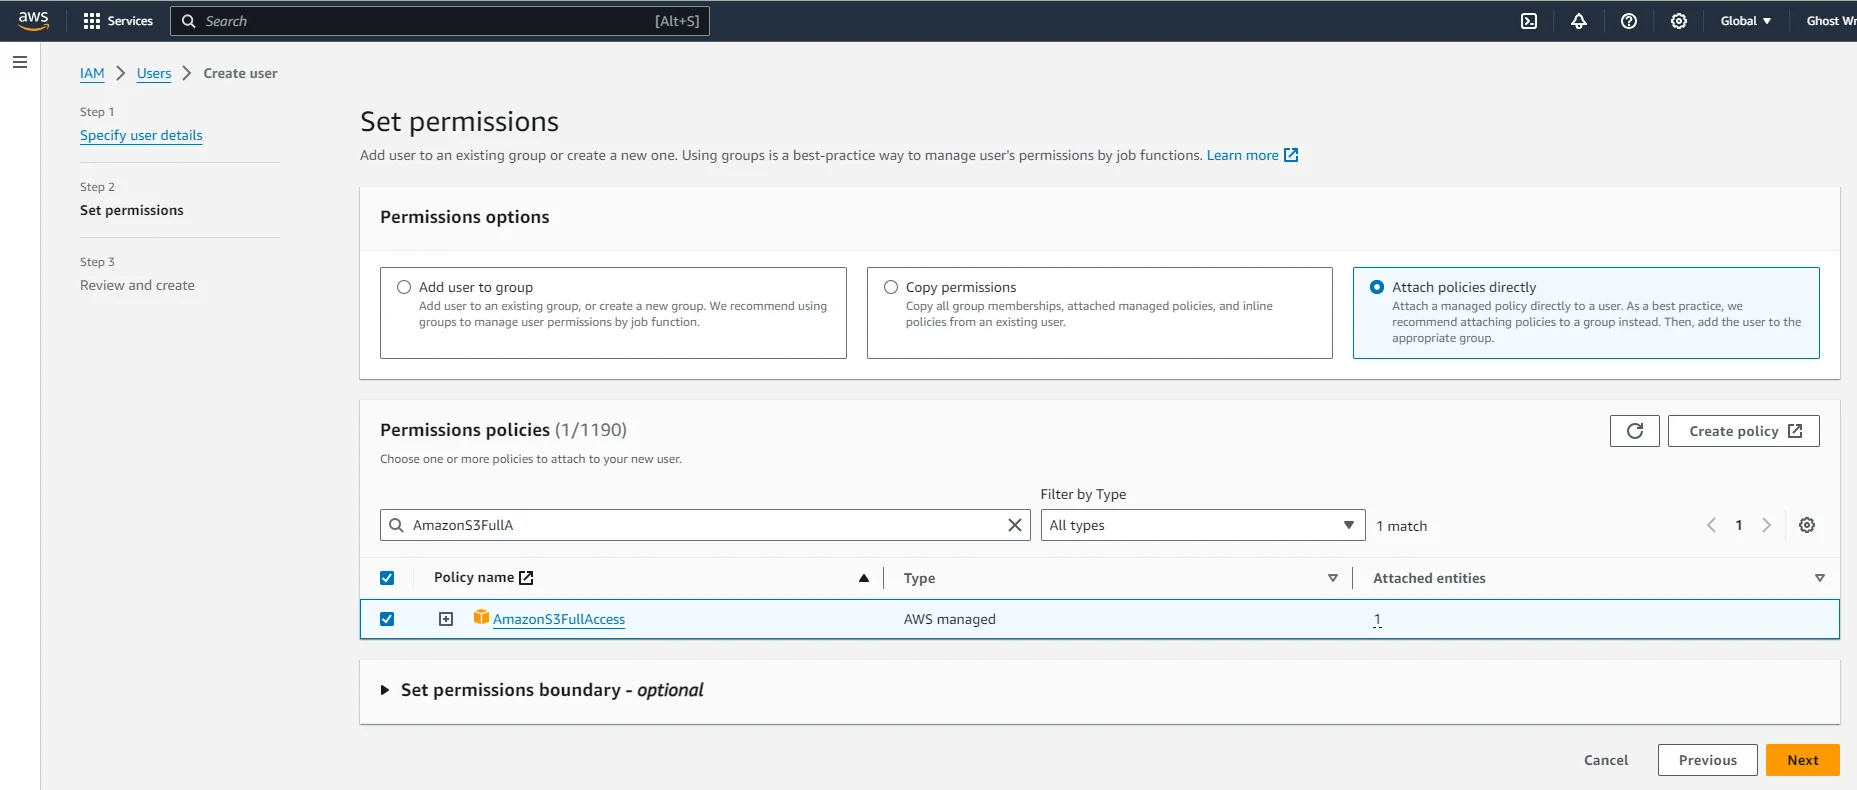
设置 AWS IAM 用户权限
  1. 检查并创建用户:检查设置后创建用户。创建完成后,将看到访问密钥 ID 和私密访问密钥。请务必下载并安全保存这些凭证;完成此步骤后,无法再次获取私密访问密钥。
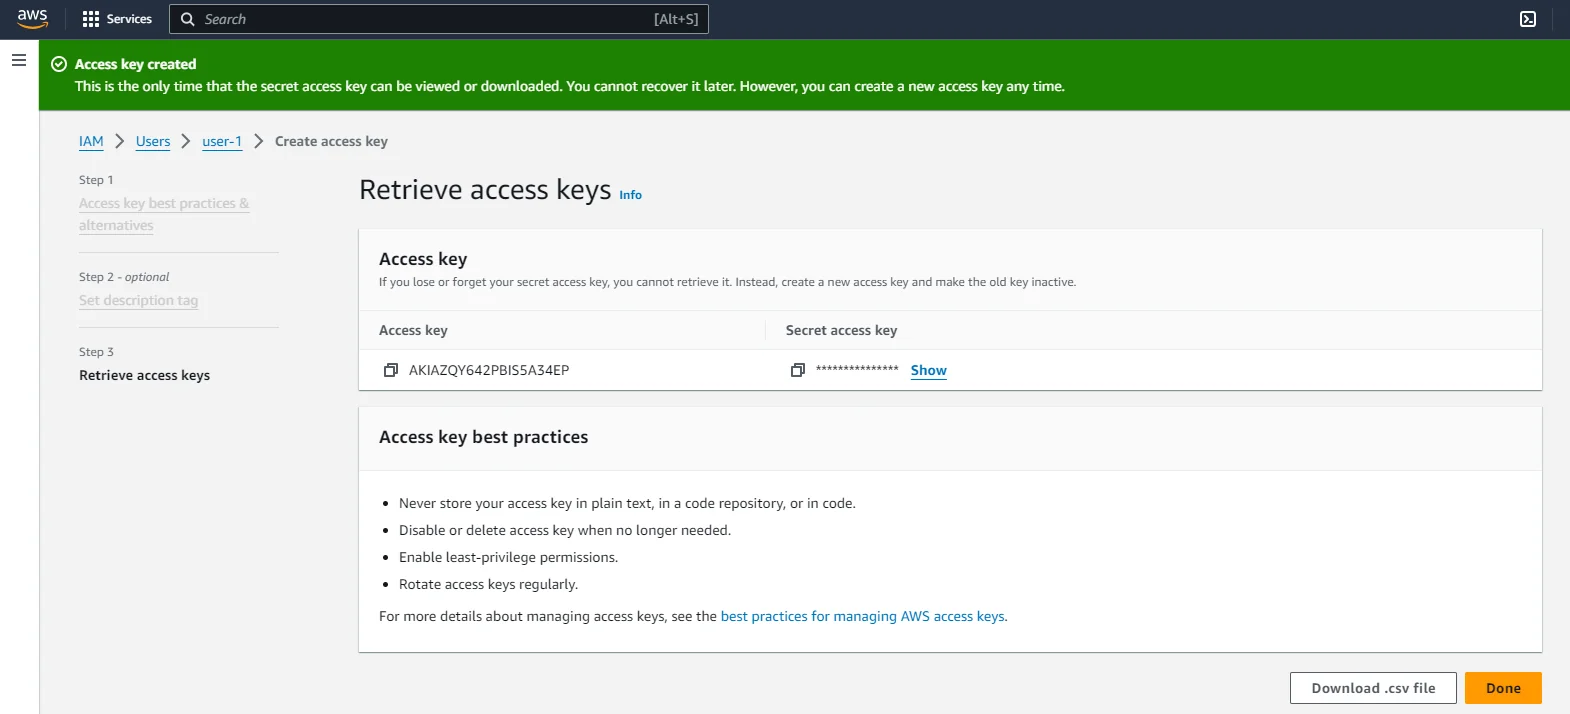
AWS 私密访问密钥
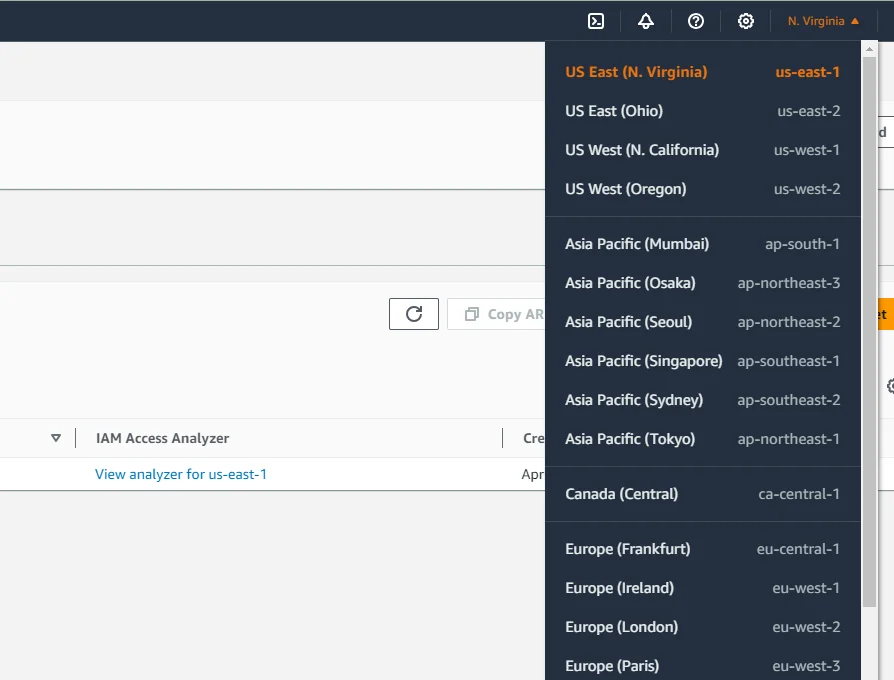
  1. 获取 AWS 区域名称:例如 us-east-1。
AWS 区域名称

如果没有 AWS S3 存储桶,需要按以下步骤创建:

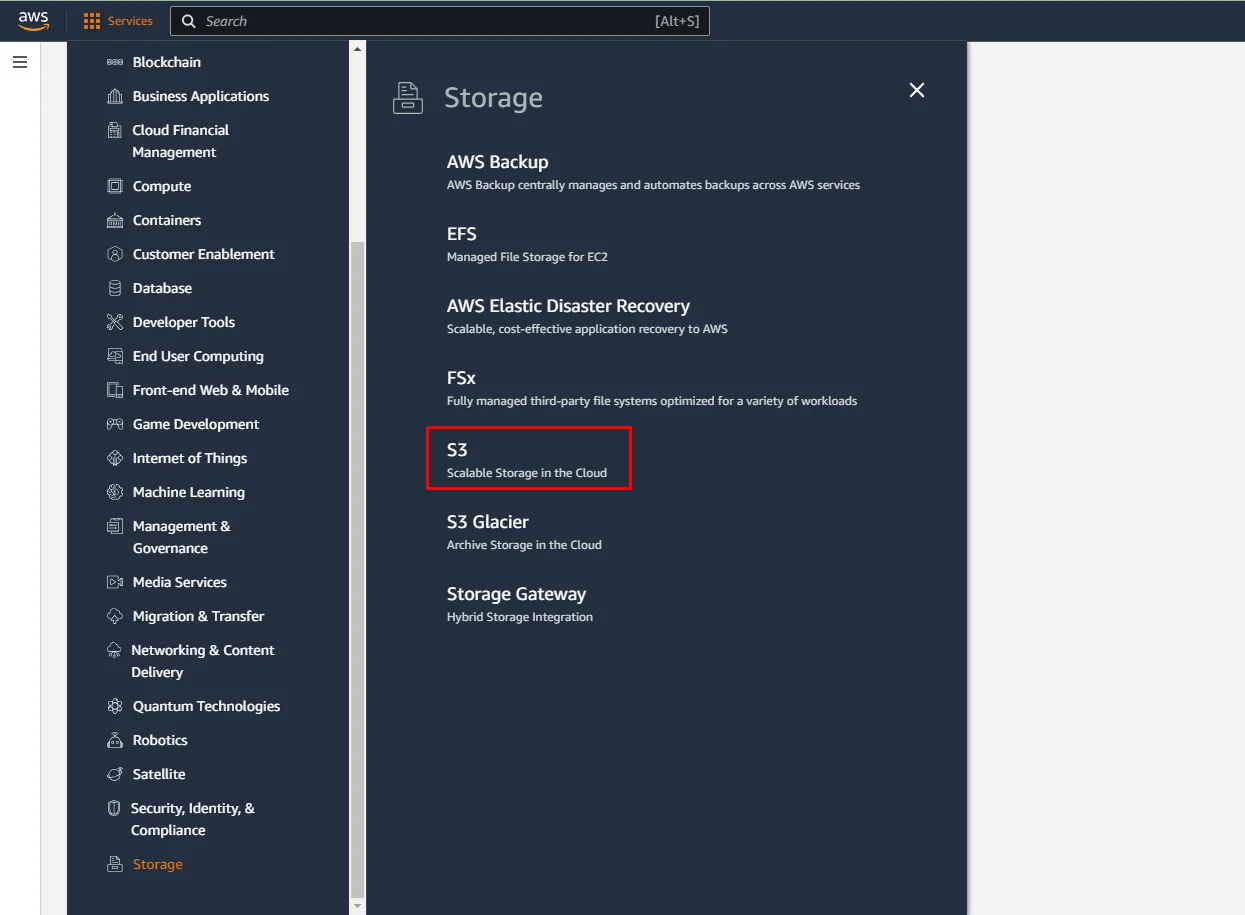
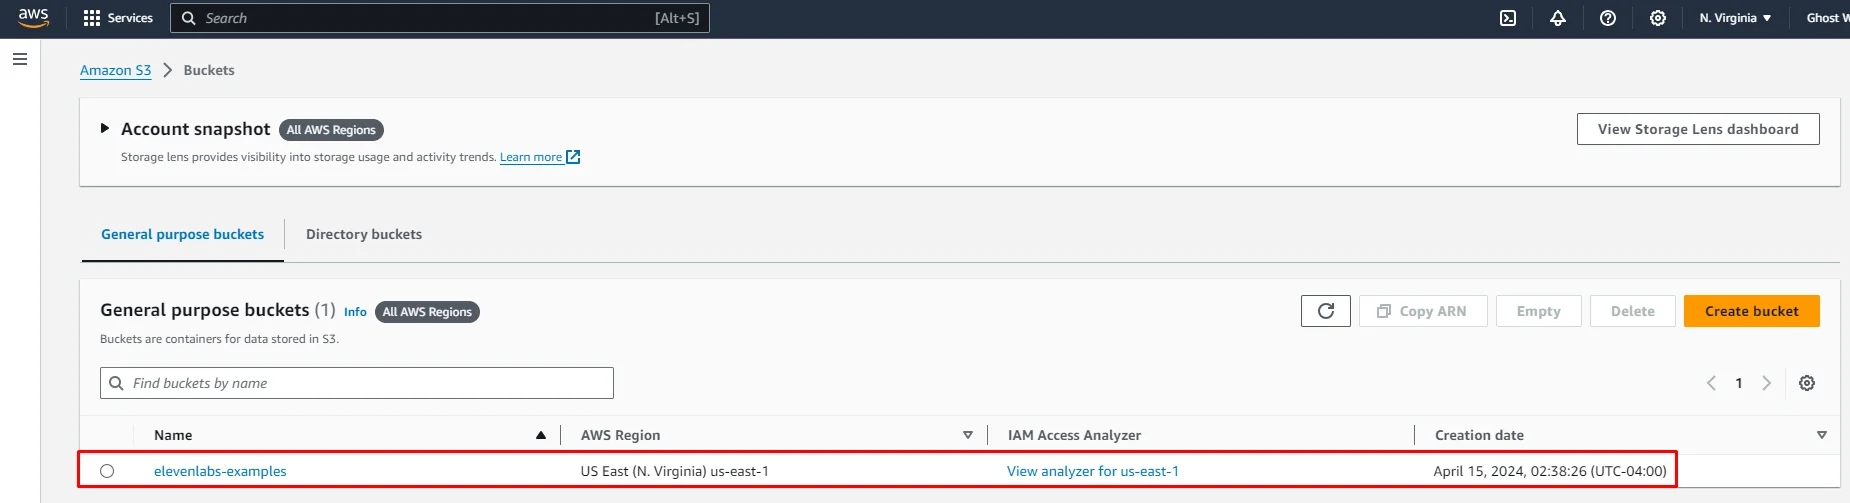
  1. 打开 S3 控制面板:可在服务菜单的“存储”下找到 S3。
AWS S3 控制面板
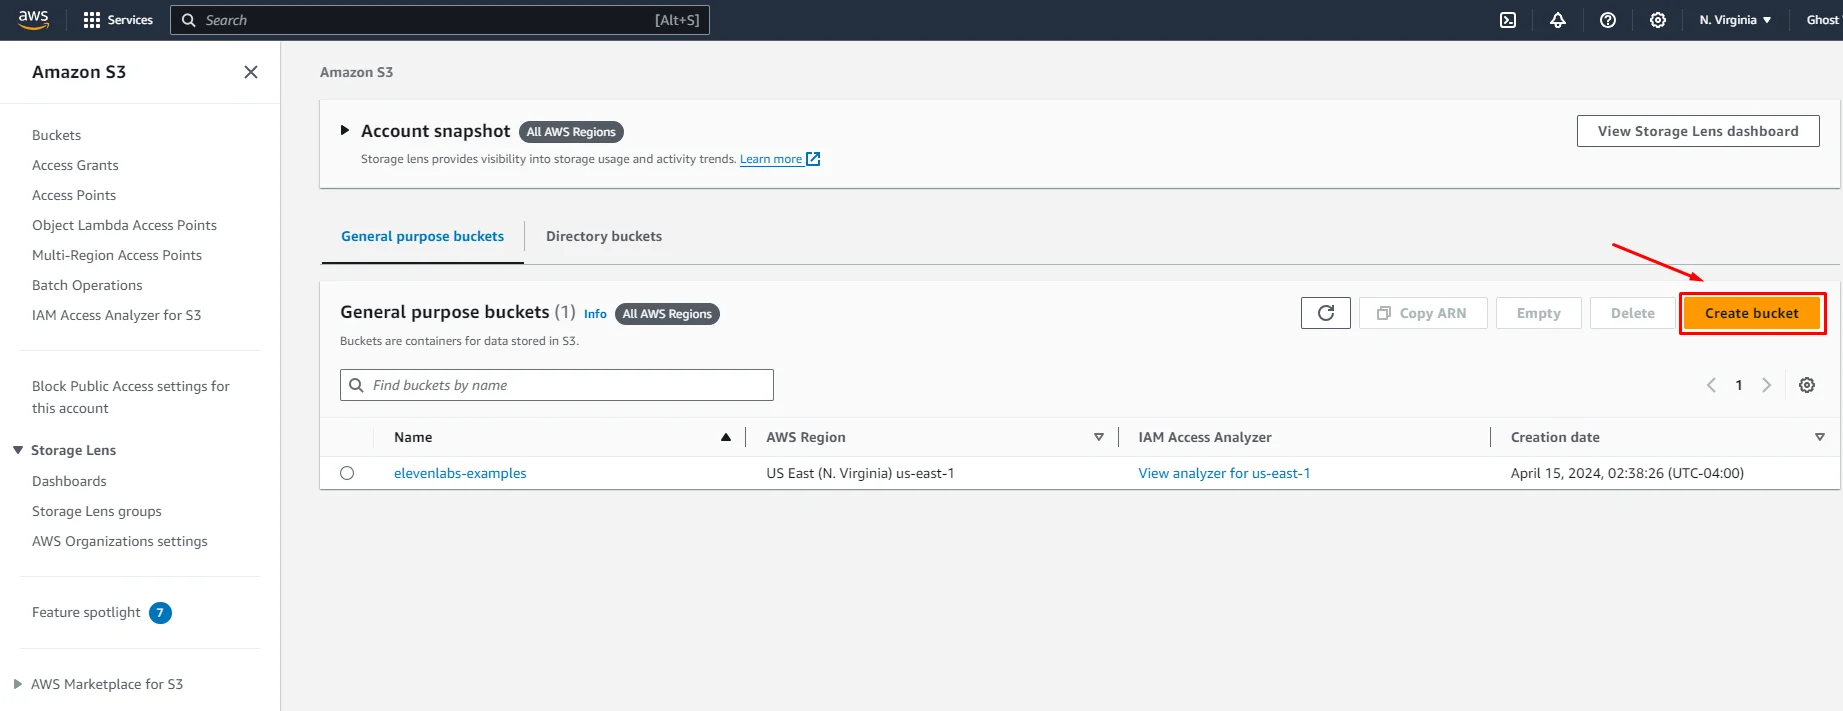
  1. 创建新存储桶:在 S3 控制面板中,点击“创建存储桶”按钮。
点击创建存储桶按钮
  1. 输入存储桶名称,然后点击“创建存储桶”按钮。其他存储桶选项可保留默认设置。新建的存储桶会显示在列表中。
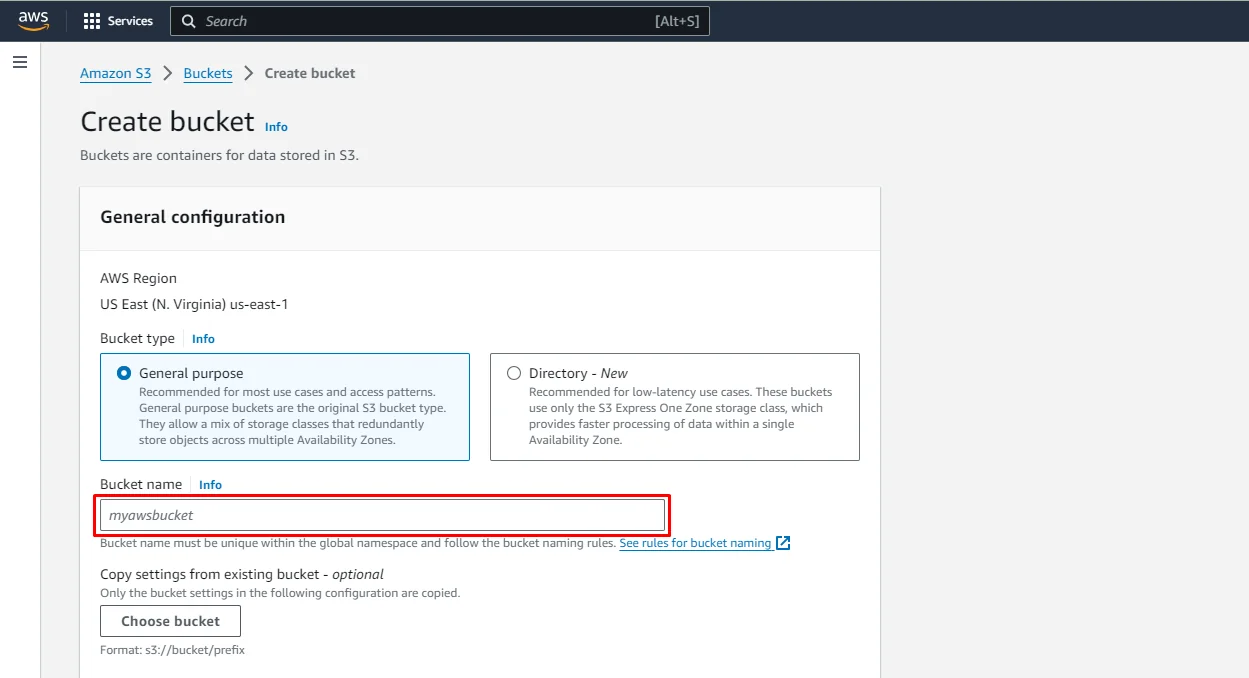
输入新的 S3 存储桶名称
S3 存储桶列表

使用 pip 和 npm 安装用于与 AWS 服务交互的 boto3。

pip install boto3

然后按如下方式将环境变量添加到 .env 文件:

AWS_ACCESS_KEY_ID=your_aws_access_key_id_here
AWS_SECRET_ACCESS_KEY=your_aws_secret_access_key_here
AWS_REGION_NAME=your_aws_region_name_here
AWS_S3_BUCKET_NAME=your_s3_bucket_name_here

添加以下函数,将音频流上传至 S3 并生成签名 URL。

import os
import boto3
import uuid
AWS_ACCESS_KEY_ID = os.getenv("AWS_ACCESS_KEY_ID")
AWS_SECRET_ACCESS_KEY = os.getenv("AWS_SECRET_ACCESS_KEY")
AWS_REGION_NAME = os.getenv("AWS_REGION_NAME")
AWS_S3_BUCKET_NAME = os.getenv("AWS_S3_BUCKET_NAME")
session = boto3.Session(
aws_access_key_id=AWS_ACCESS_KEY_ID,
aws_secret_access_key=AWS_SECRET_ACCESS_KEY,
region_name=AWS_REGION_NAME,
)
s3 = session.client("s3")
def generate_presigned_url(s3_file_name: str) -> str:
signed_url = s3.generate_presigned_url(
"get_object",
Params={"Bucket": AWS_S3_BUCKET_NAME, "Key": s3_file_name},
ExpiresIn=3600,
) # URL expires in 1 hour
return signed_url
def upload_audiostream_to_s3(audio_stream) -> str:
s3_file_name = f"{uuid.uuid4()}.mp3" # Generates a unique file name using UUID
s3.upload_fileobj(audio_stream, AWS_S3_BUCKET_NAME, s3_file_name)
return s3_file_name

然后可以使用文本生成的音频流调用上传函数。

s3_file_name = upload_audiostream_to_s3(audio_stream)

将音频文件上传到 S3 后,生成签名 URL 以分享文件访问权限。此 URL 有时间限制,会在一段时间后失效,因此适合临时安全分享。

现在可以通过以下方式从文件生成 URL:

signed_url = generate_presigned_url(s3_file_name)
print(f"Signed URL to access the file: {signed_url}")

如果需要多次使用该文件,应将 S3 文件路径存储在数据库中,并在每次需要时重新生成签名 URL,而不是直接保存签名 URL,因为它会过期。

要将以上内容整合起来,可以使用以下脚本:

import os
from dotenv import load_dotenv
load_dotenv()
from text_to_speech_stream import text_to_speech_stream
from s3_uploader import upload_audiostream_to_s3, generate_presigned_url
def main():
text = "This is James"
audio_stream = text_to_speech_stream(text)
s3_file_name = upload_audiostream_to_s3(audio_stream)
signed_url = generate_presigned_url(s3_file_name)
print(f"Signed URL to access the file: {signed_url}")
if __name__ == "__main__":
main()

总结

现在你已了解如何将文本转换为语音,并生成签名 URL 来分享音频文件。这项功能可用于动态创建和分享各种内容。

以下是一些可以基于此构建的示例:

  1. 教育播客:创建学生可随时访问的个性化教育内容。教师可以将课程转换为音频格式,上传到 S3,然后与学生分享链接,在传统课堂之外提供更具吸引力的学习体验。

  2. 网站无障碍功能:以音频格式提供文本内容,提升网站无障碍性。这能让视障人士或偏好听觉学习的用户更轻松地获取网站信息。

  3. 自动化客服消息:为常见问题或订单更新等客服场景制作自动化、个性化的音频消息。与传统文本邮件相比,这可以提供更有吸引力的客户体验。

  4. 有声书和叙述:将完整书籍或短篇故事转换为音频格式,为受众提供欣赏文学的新方式。作者和出版商可以丰富内容形式,触达偏好聆听而非阅读的受众。

  5. 语言学习工具:开发为学习者提供音频课程和练习的语言学习辅助工具,从而有针对性地练习发音和听力技能。

后续步骤