テキスト読み上げのストリーミング

このガイドでは、テキスト読み上げをストリーミングし、必要に応じてオーディオをAWS S3にアップロードする方法を説明します。

このガイドでは、ファイルとして音声を生成する方法、オーディオレスポンスを直接ストリーミングする方法、さらに必要に応じて生成したオーディオをAWS S3バケットにアップロードして署名付きURLで共有する方法の3つを紹介します。

このガイドでは、APIキーとSDKのセットアップ が完了していることを前提としています。まだの場合は、先に クイックスタートを完了してください。S3へのアップロードは任意ですが、S3にアクセスできるAWSアカウントも 必要です。

ストリーミングの仕組みに興味がありますか?オーディオストリーミングの 仕組みでは、プロトコル、バッファリング、 レイテンシーのトレードオフを詳しく解説しています。

テキストを音声に変換する(ファイル)

テキストを音声に変換してファイルとして保存するには、ElevenLabs SDKのconvertメソッドを使用し、ローカルに.mp3ファイルとして保存します。

import os
import uuid
from dotenv import load_dotenv
from elevenlabs import VoiceSettings
from elevenlabs.client import ElevenLabs
load_dotenv()
ELEVENLABS_API_KEY = os.getenv("ELEVENLABS_API_KEY")
elevenlabs = ElevenLabs(
api_key=ELEVENLABS_API_KEY,
)
def text_to_speech_file(text: str) -> str:
# Calling the text_to_speech conversion API with detailed parameters
response = elevenlabs.text_to_speech.convert(
voice_id="pNInz6obpgDQGcFmaJgB", # Adam pre-made voice
output_format="mp3_22050_32",
text=text,
model_id="eleven_flash_v2_5", # use the flash model for low latency
# Optional voice settings that allow you to customize the output
voice_settings=VoiceSettings(
stability=0.0,
similarity_boost=1.0,
style=0.0,
use_speaker_boost=True,
speed=1.0,
),
)
# uncomment the line below to play the audio back
# play(response)
# Generating a unique file name for the output MP3 file
save_file_path = f"{uuid.uuid4()}.mp3"
# Writing the audio to a file
with open(save_file_path, "wb") as f:
for chunk in response:
if chunk:
f.write(chunk)
print(f"{save_file_path}: A new audio file was saved successfully!")
# Return the path of the saved audio file
return save_file_path

続けて、次のようにこの関数を実行できます。

text_to_speech_file("Hello World")

テキストを音声に変換する(ストリーミング)

ファイルに保存せずオーディオを直接ストリーミングしたい場合は、ストリーミング機能を使用できます。

import os
from typing import IO
from io import BytesIO
from dotenv import load_dotenv
from elevenlabs import VoiceSettings
from elevenlabs.client import ElevenLabs
load_dotenv()
ELEVENLABS_API_KEY = os.getenv("ELEVENLABS_API_KEY")
elevenlabs = ElevenLabs(
api_key=ELEVENLABS_API_KEY,
)
def text_to_speech_stream(text: str) -> IO[bytes]:
# Perform the text-to-speech conversion
response = elevenlabs.text_to_speech.stream(
voice_id="pNInz6obpgDQGcFmaJgB", # Adam pre-made voice
output_format="mp3_22050_32",
text=text,
model_id="eleven_multilingual_v2",
# Optional voice settings that allow you to customize the output
voice_settings=VoiceSettings(
stability=0.0,
similarity_boost=1.0,
style=0.0,
use_speaker_boost=True,
speed=1.0,
),
)
# Create a BytesIO object to hold the audio data in memory
audio_stream = BytesIO()
# Write each chunk of audio data to the stream
for chunk in response:
if chunk:
audio_stream.write(chunk)
# Reset stream position to the beginning
audio_stream.seek(0)
# Return the stream for further use
return audio_stream

続けて、次のようにこの関数を実行できます。

text_to_speech_stream("This is James")

ボーナス:AWS S3へのアップロードと安全な共有リンクの取得

オーディオデータをファイルまたはストリームとして作成したら、ユーザーと共有したくなるかもしれません。その方法の1つは、AWS S3バケットにアップロードして安全な共有リンクを生成することです。

データをS3にアップロードするには、AWSアクセスキーID、シークレットアクセスキー、AWSリージョン名を.envファイルに追加する必要があります。認証情報を確認するには、次の手順に従ってください。

  1. AWS Management Consoleにログインします。AWSホームページにアクセスし、アカウントでサインインします。
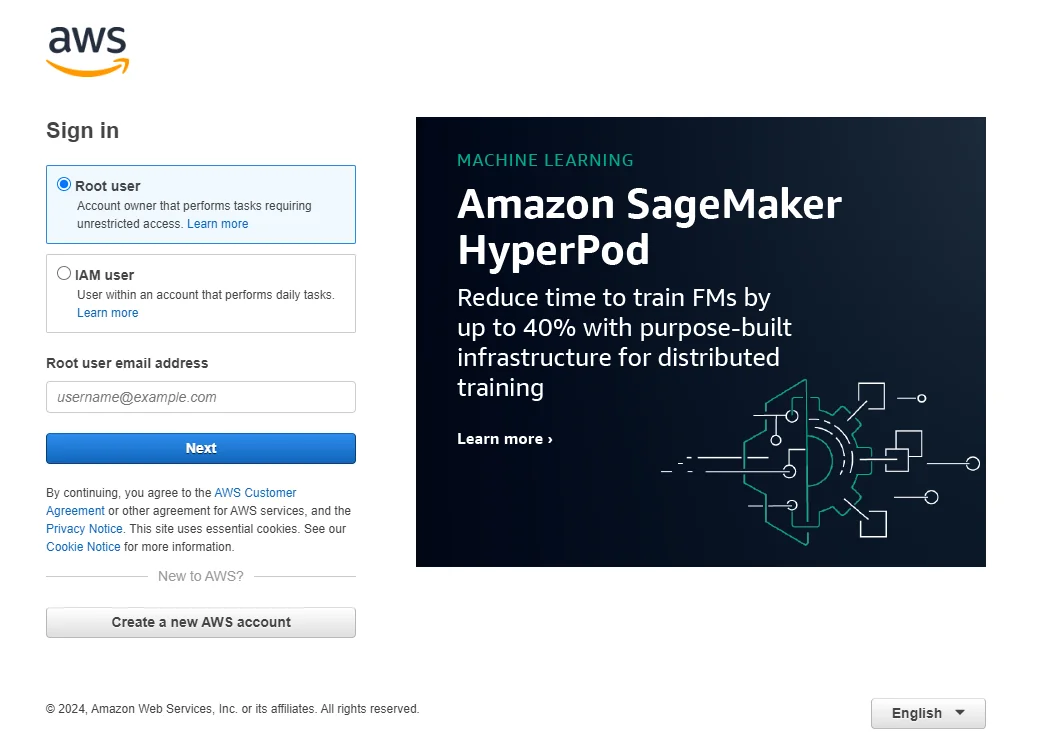
AWSコンソールへのログイン
  1. IAM(Identity and Access Management)ダッシュボードにアクセスします。サービスメニューの「Security, Identity, & Compliance」からIAMを見つけられます。IAMダッシュボードでは、AWSサービスへのアクセスを安全に管理できます。
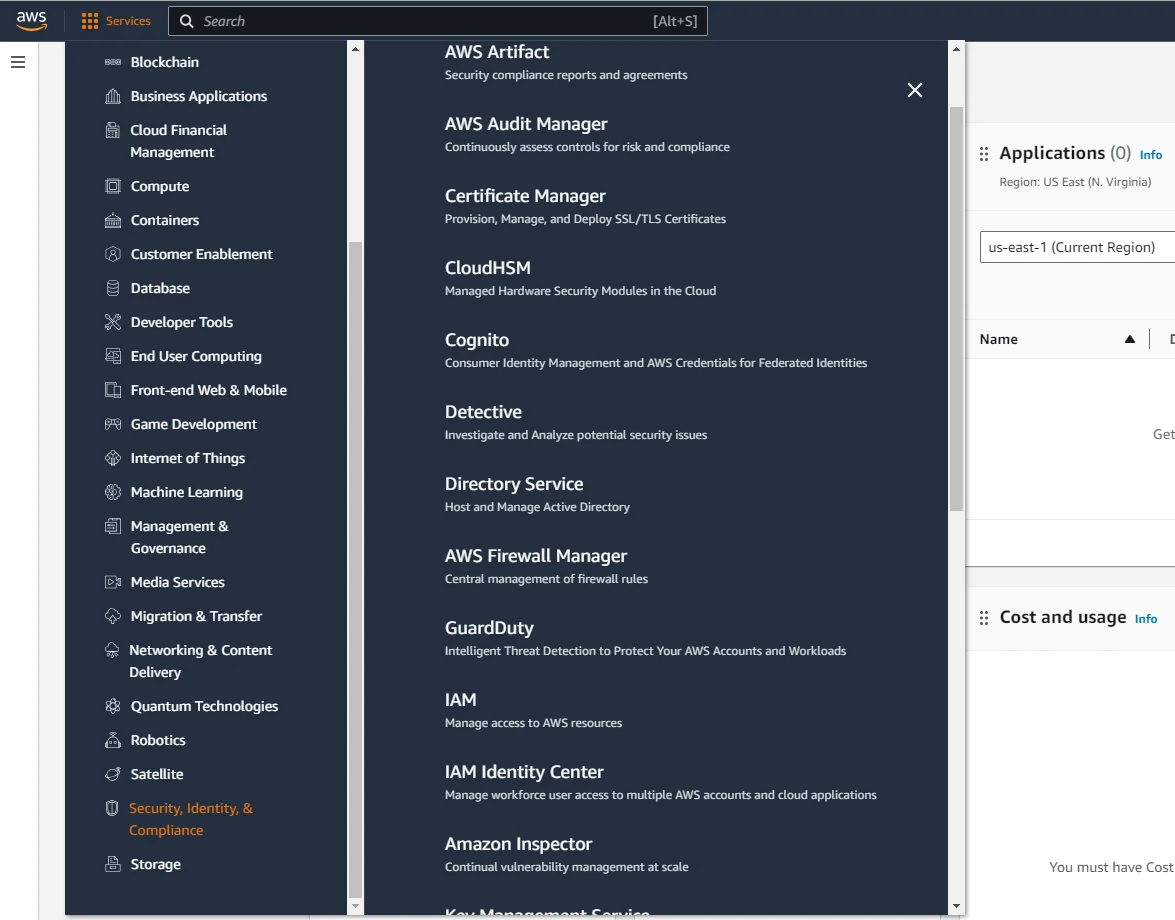
AWS IAMダッシュボード
  1. 新しいユーザーを作成します(必要な場合)。IAMダッシュボードで「Users」を選択し、「Add user」を選択します。ユーザー名を入力します。
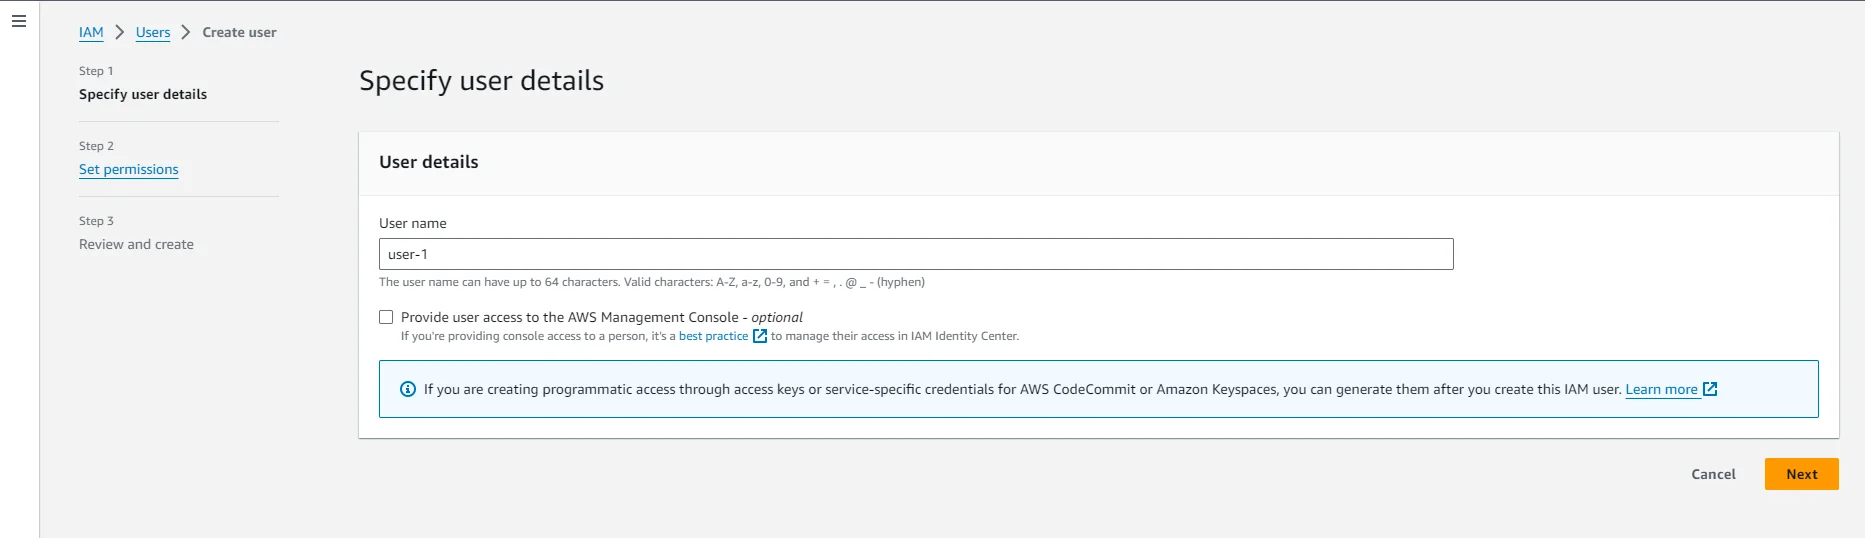
AWS IAMユーザーを追加
  1. 権限を設定します。付与したいアクセスレベルに応じて、ポリシーをユーザーに直接アタッチします。S3へのアップロードには、AmazonS3FullAccessポリシーを使用できます。ただし、タスクの実行に必要な最小限の権限だけを付与する、最小権限の原則に従うことをおすすめします。S3バケットに対して必要なアクションのみを許可するカスタムポリシーを作成するとよいでしょう。
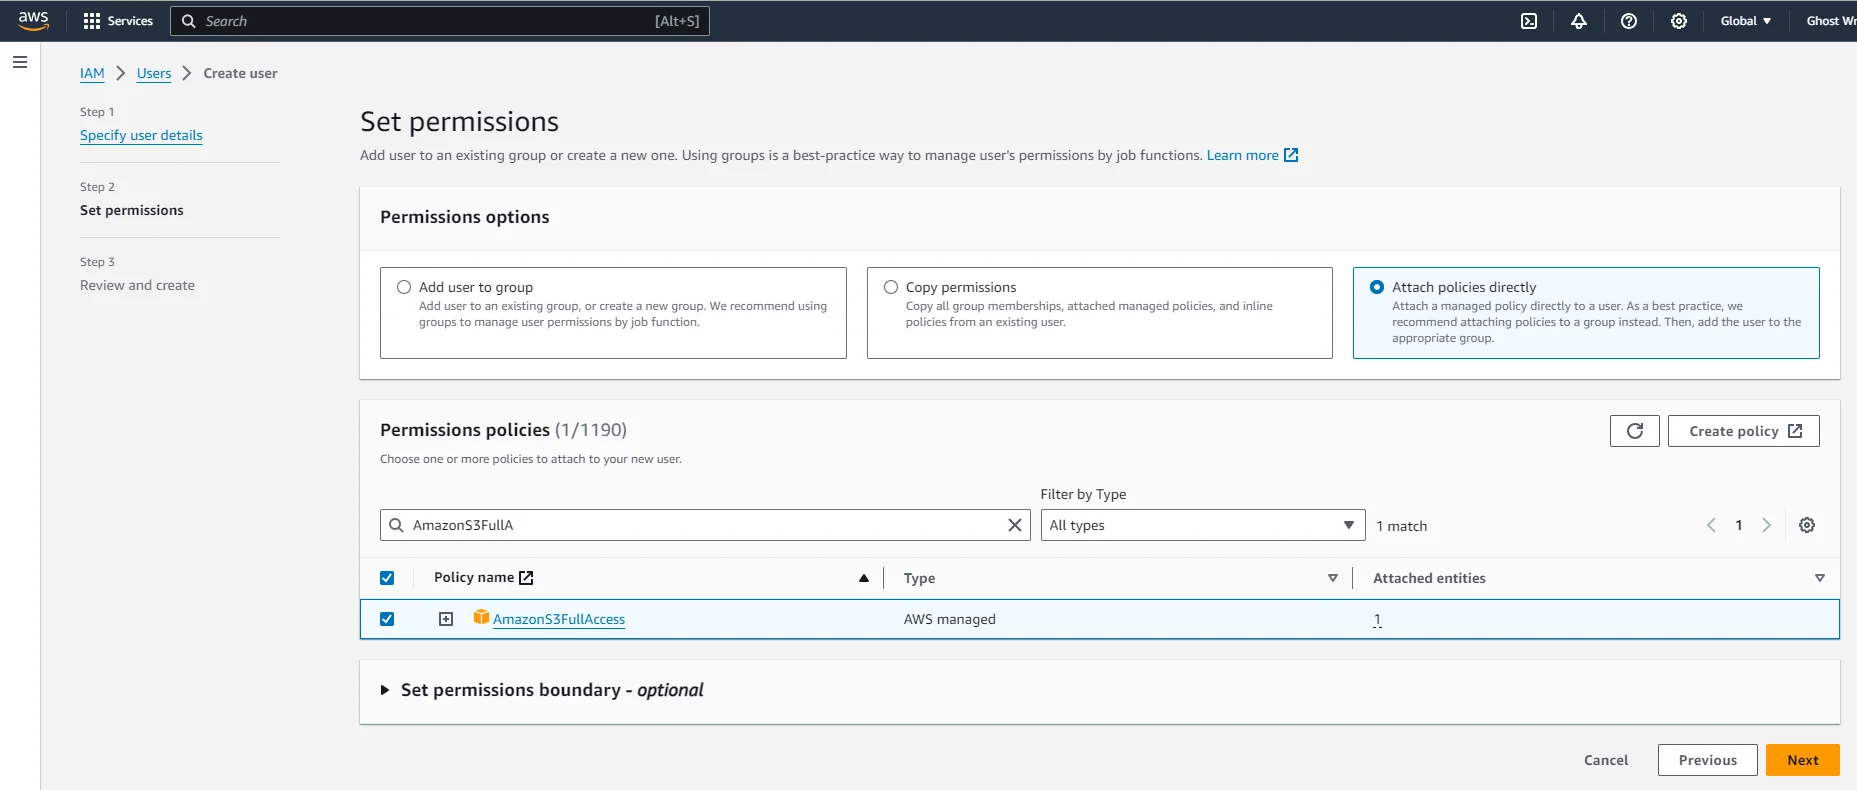
AWS IAMユーザーの権限を設定
  1. ユーザーを確認して作成します。設定を確認してユーザーを作成します。作成すると、アクセスキーIDとシークレットアクセスキーが表示されます。これらの認証情報は必ずダウンロードして安全に保存してください。この手順以降、シークレットアクセスキーを再取得することはできません。
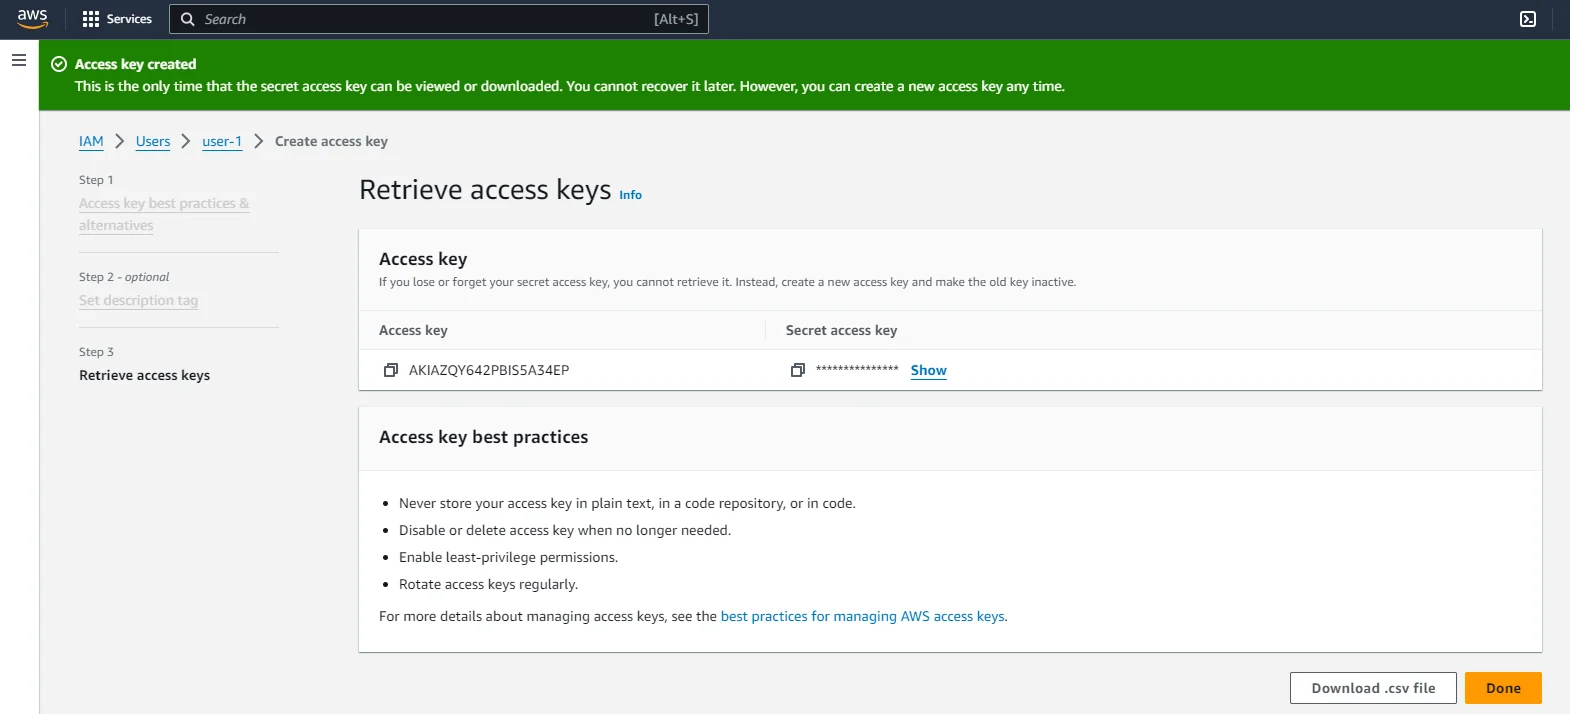
AWSアクセスシークレットキー
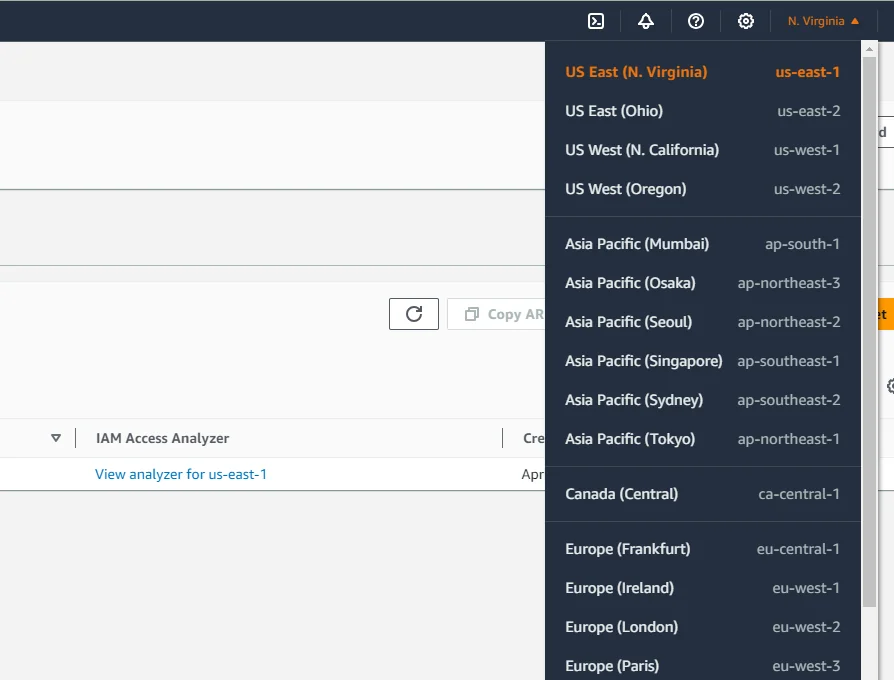
  1. AWSリージョン名を取得します。例:us-east-1
AWSリージョン名

AWS S3バケットがない場合は、次の手順で新しく作成する必要があります。

  1. S3ダッシュボードにアクセスします。サービスメニューの「Storage」からS3を見つけられます。
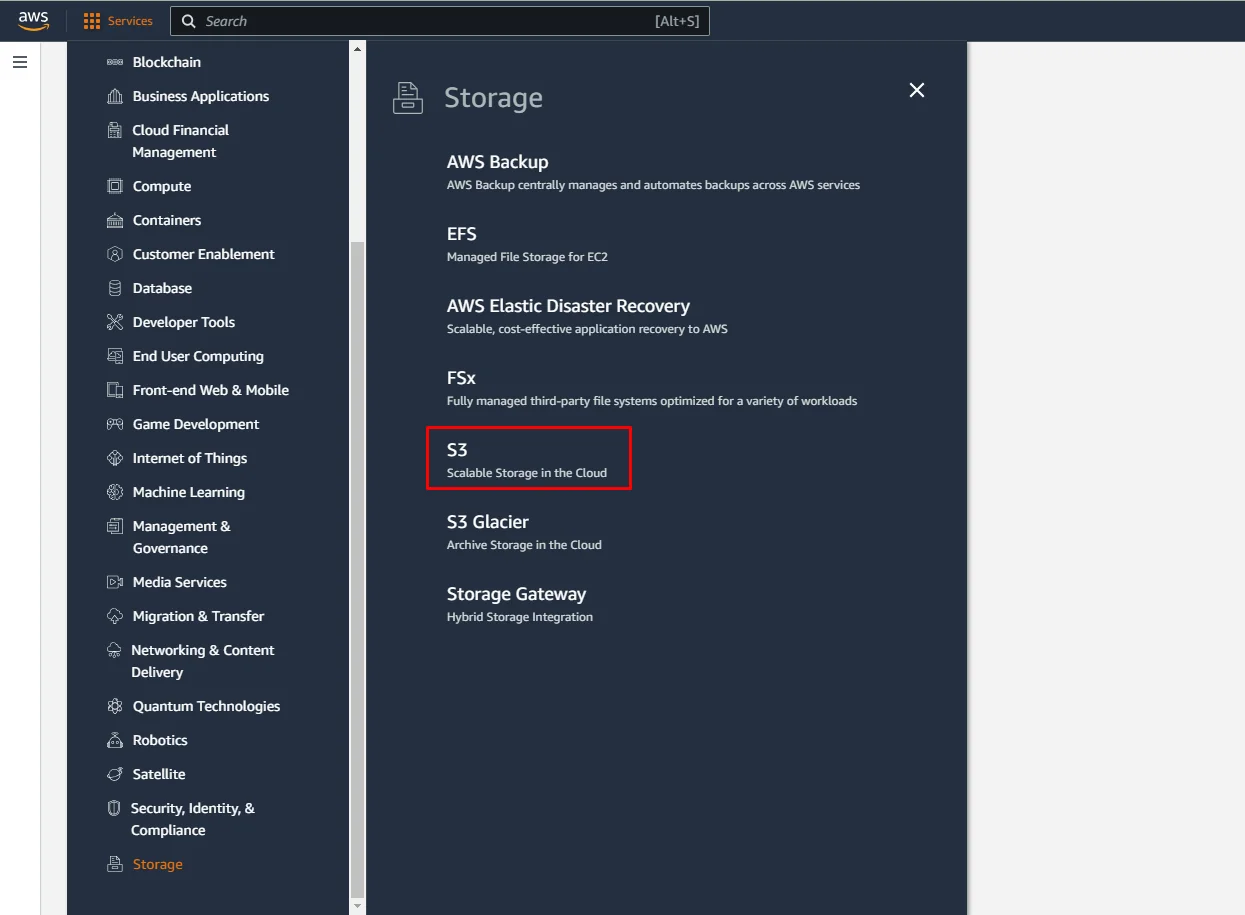
AWS S3ダッシュボード
  1. 新しいバケットを作成します。S3ダッシュボードで「Create bucket」ボタンをクリックします。
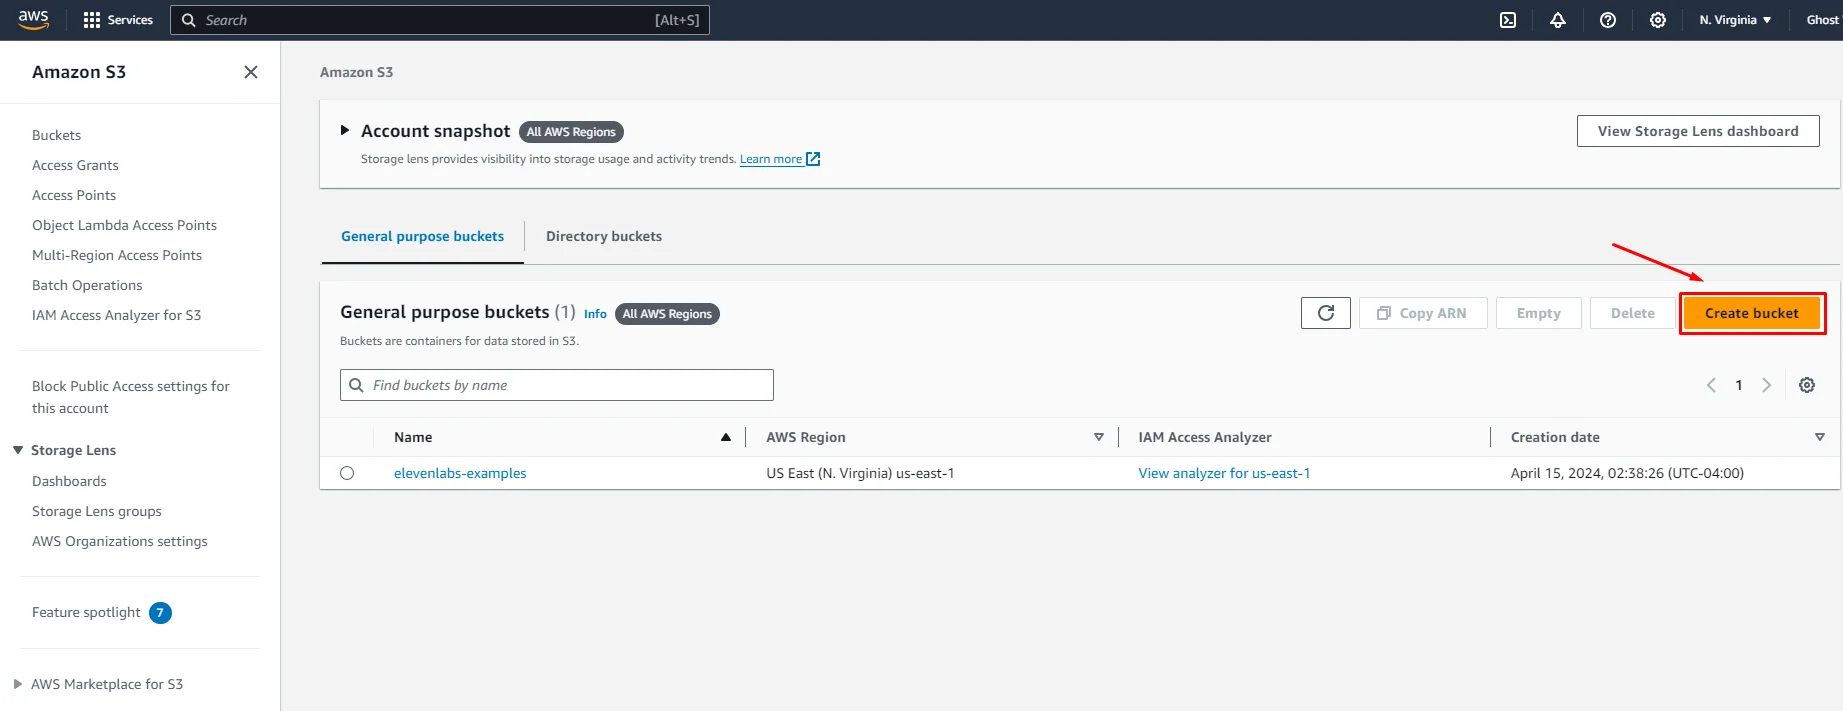
Create bucketボタンをクリック
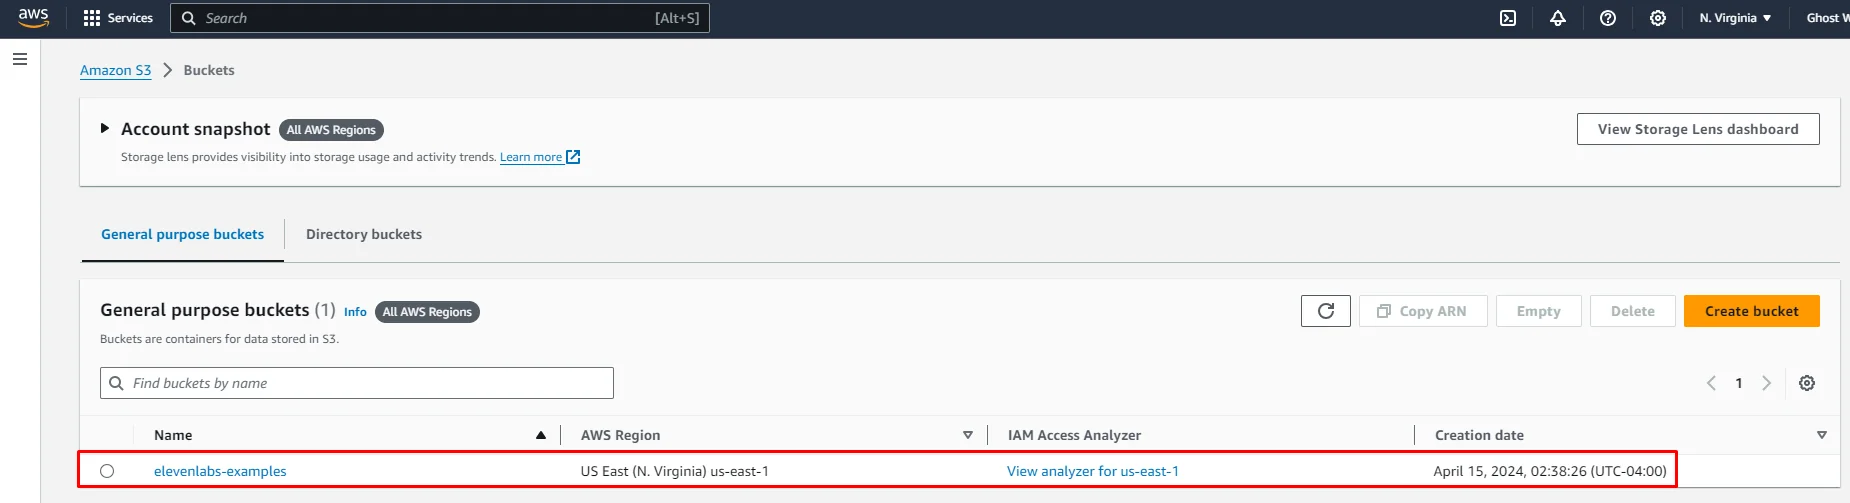
  1. バケット名を入力し、「Create bucket」ボタンをクリックします。その他のバケットオプションはデフォルトのままで構いません。追加したバケットが一覧に表示されます。
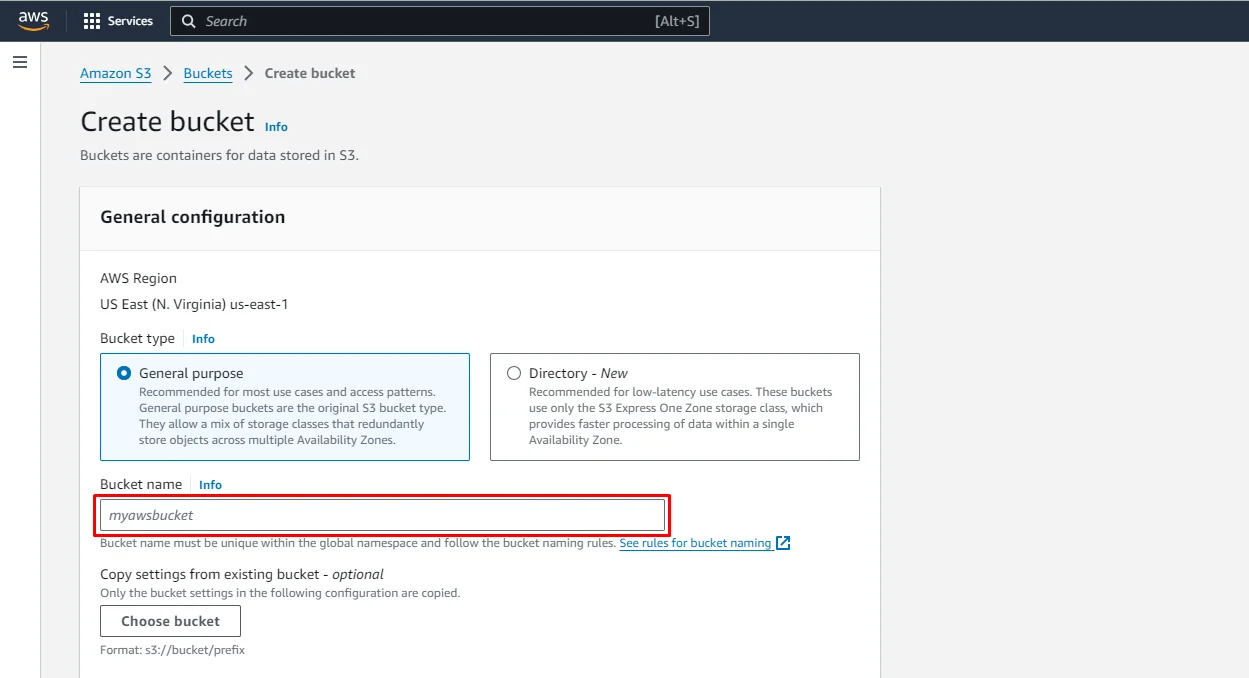
新しいS3バケット名を入力
S3バケット一覧

pipとnpmを使用して、AWSサービスと連携するためのboto3をインストールします。

pip install boto3

次に、以下のように環境変数を.envファイルに追加します。

AWS_ACCESS_KEY_ID=your_aws_access_key_id_here
AWS_SECRET_ACCESS_KEY=your_aws_secret_access_key_here
AWS_REGION_NAME=your_aws_region_name_here
AWS_S3_BUCKET_NAME=your_s3_bucket_name_here

オーディオストリームをS3にアップロードし、署名付きURLを生成するために、次の関数を追加します。

import os
import boto3
import uuid
AWS_ACCESS_KEY_ID = os.getenv("AWS_ACCESS_KEY_ID")
AWS_SECRET_ACCESS_KEY = os.getenv("AWS_SECRET_ACCESS_KEY")
AWS_REGION_NAME = os.getenv("AWS_REGION_NAME")
AWS_S3_BUCKET_NAME = os.getenv("AWS_S3_BUCKET_NAME")
session = boto3.Session(
aws_access_key_id=AWS_ACCESS_KEY_ID,
aws_secret_access_key=AWS_SECRET_ACCESS_KEY,
region_name=AWS_REGION_NAME,
)
s3 = session.client("s3")
def generate_presigned_url(s3_file_name: str) -> str:
signed_url = s3.generate_presigned_url(
"get_object",
Params={"Bucket": AWS_S3_BUCKET_NAME, "Key": s3_file_name},
ExpiresIn=3600,
) # URL expires in 1 hour
return signed_url
def upload_audiostream_to_s3(audio_stream) -> str:
s3_file_name = f"{uuid.uuid4()}.mp3" # Generates a unique file name using UUID
s3.upload_fileobj(audio_stream, AWS_S3_BUCKET_NAME, s3_file_name)
return s3_file_name

テキストから作成したオーディオストリームを使用して、アップロード関数を呼び出せます。

s3_file_name = upload_audiostream_to_s3(audio_stream)

オーディオファイルをS3にアップロードした後、ファイルへのアクセスを共有するための署名付きURLを生成します。このURLには有効期限があるため、一定時間後に期限切れとなり、一時的な共有を安全に行えます。

次のようにファイルからURLを生成できます。

signed_url = generate_presigned_url(s3_file_name)
print(f"Signed URL to access the file: {signed_url}")

ファイルを複数回使用する場合は、期限切れになる署名付きURLを直接保存するのではなく、S3ファイルパスをデータベースに保存し、必要になるたびに署名付きURLを再生成してください。

すべてを組み合わせるには、次のスクリプトを使用できます。

import os
from dotenv import load_dotenv
load_dotenv()
from text_to_speech_stream import text_to_speech_stream
from s3_uploader import upload_audiostream_to_s3, generate_presigned_url
def main():
text = "This is James"
audio_stream = text_to_speech_stream(text)
s3_file_name = upload_audiostream_to_s3(audio_stream)
signed_url = generate_presigned_url(s3_file_name)
print(f"Signed URL to access the file: {signed_url}")
if __name__ == "__main__":
main()

まとめ

これで、テキストを音声に変換し、オーディオファイルを共有するための署名付きURLを生成する方法がわかりました。この機能により、コンテンツを動的に作成・共有するための多くの可能性が広がります。

この機能で構築できるものの例を紹介します。

  1. 教育ポッドキャスト:生徒が必要なときにアクセスできる、パーソナライズされた教育コンテンツを作成できます。教師は授業をオーディオ形式に変換してS3にアップロードし、リンクを生徒と共有することで、従来の教室外でもより魅力的な学習体験を提供できます。

  2. Webサイトのアクセシビリティ機能:テキストコンテンツをオーディオ形式で提供することで、Webサイトのアクセシビリティを向上できます。視覚障害のある方や、聴覚による学習を好む方にとって、Webサイト上の情報がより利用しやすくなります。

  3. 自動カスタマーサポートメッセージ:FAQや注文状況の更新など、カスタマーサポート向けの自動化されたパーソナライズ音声メッセージを作成できます。従来のテキストメールよりも魅力的な顧客体験を提供できます。

  4. オーディオブックとナレーション:書籍全体や短編小説をオーディオ形式に変換し、読者に文学を楽しむ新たな方法を提供できます。著者や出版社はコンテンツの提供方法を多様化し、読むより聴くことを好むユーザーにも届けられます。

  5. 語学学習ツール:学習者にオーディオレッスンや演習を提供する語学学習支援ツールを開発できます。発音やリスニングスキルを目的に合わせて練習できます。

次のステップ