

실시간 오디오 생성
이 가이드에서는 WebSocket 연결을 통해 실시간으로 오디오를 생성하는 방법을 설명합니다.
WebSocket 스트리밍은 하나의 장기간 유지되는 연결을 통해 데이터를 송수신하는 방식입니다. 이 방식은 오디오 데이터를 사용할 수 있게 되는 즉시 스트리밍해야 하는 실시간 애플리케이션에 유용합니다.
ElevenLabs 텍스트 음성 변환 API에 대한 WebSocket 연결의 지연 시간(첫 바이트까지 걸리는 시간)을 빠르게 테스트하려면 npm을 통해 elevenlabs-latency를 설치하고 여기의 안내를 따르세요.
WebSocket은 텍스트 음성 변환 및 Agents Platform에서 사용할 수 있습니다. 이 가이드에서는 텍스트
음성 변환 WebSocket(/v1/text-to-speech/{voice_id}/stream-input)을 다룹니다. 이 엔드포인트는
eleven_v3 또는 eleven_v4 모델을 지원하지 않습니다. WebSocket을 통한 Eleven v3 또는
Eleven v4 대화는 실시간 텍스트-대화 및
텍스트 음성 변환과 텍스트-대화
WebSocket 비교를 참조하세요.
요구 사항
- API 키가 있는 ElevenLabs 계정(API 키 찾는 방법)
- 컴퓨터에 설치된 Python 또는 Node.js(또는 다른 JavaScript 런타임)
설정
필수 종속성을 설치합니다.
다음으로 프로젝트 디렉터리에 .env 파일을 만들고 API 키를 추가합니다.
WebSocket 연결 시작
보이스 라이브러리에서 음성을 선택하고 사용할 텍스트 음성 변환 모델을 정한 후, 텍스트 음성 변환 API에 WebSocket 연결을 시작합니다.
입력 텍스트 전송
WebSocket 연결이 열리면 먼저 음성 설정을 지정합니다. 다음으로 텍스트 메시지를 API에 전송합니다.
오디오를 파일로 저장
WebSocket 연결에서 수신되는 메시지를 읽고 오디오 청크를 로컬 파일에 씁니다.
스크립트 실행
터미널에서 다음 명령어를 실행하여 스크립트를 실행할 수 있습니다. output 디렉터리에 mp3 오디오 파일이 저장됩니다.
고급 구성
WebSocket 사용 시 실시간 오디오 생성을 세밀하게 조정할 수 있는 몇 가지 고급 설정을 사용할 수 있습니다.
버퍼링
실시간 오디오를 생성할 때는 첫 바이트까지 걸리는 시간(Time To First Byte, TTFB)과 버퍼링이라는 두 가지 중요한 개념을 고려해야 합니다. 고품질 오디오를 생성하고 문맥을 파악하려면 모델에 일정 수준 이상의 입력 텍스트가 필요합니다. WebSocket 연결로 더 많은 텍스트를 전송할수록 오디오 품질이 향상됩니다. 임계값에 도달하지 않으면 모델은 텍스트를 버퍼에 추가하고 버퍼가 차면 오디오를 생성합니다.
지연 시간 측면에서 TTFB는 첫 번째 오디오 바이트가 클라이언트로 전송되기까지 걸리는 시간입니다. 이는 오디오의 체감 지연 시간에 영향을 주므로 중요합니다. 따라서 품질과 지연 시간의 균형을 맞추기 위해 버퍼 크기를 제어할 수 있습니다.
이를 관리하려면 WebSocket 연결을 초기화할 때 또는 텍스트를 전송할 때 chunk_length_schedule 파라미터를 사용할 수 있습니다. 이 파라미터는 오디오를 생성하기 전에 모델로 전송할 문자 수를 나타내는 정수 배열입니다. 예를 들어 chunk_length_schedule을 [120, 160, 250, 290]으로 설정하면 모델은 각각 120자, 160자, 250자, 290자가 전송된 후 오디오를 생성합니다.
다음은 chunk_length_schedule의 기본 설정에서 작동하는 방식의 예시입니다.
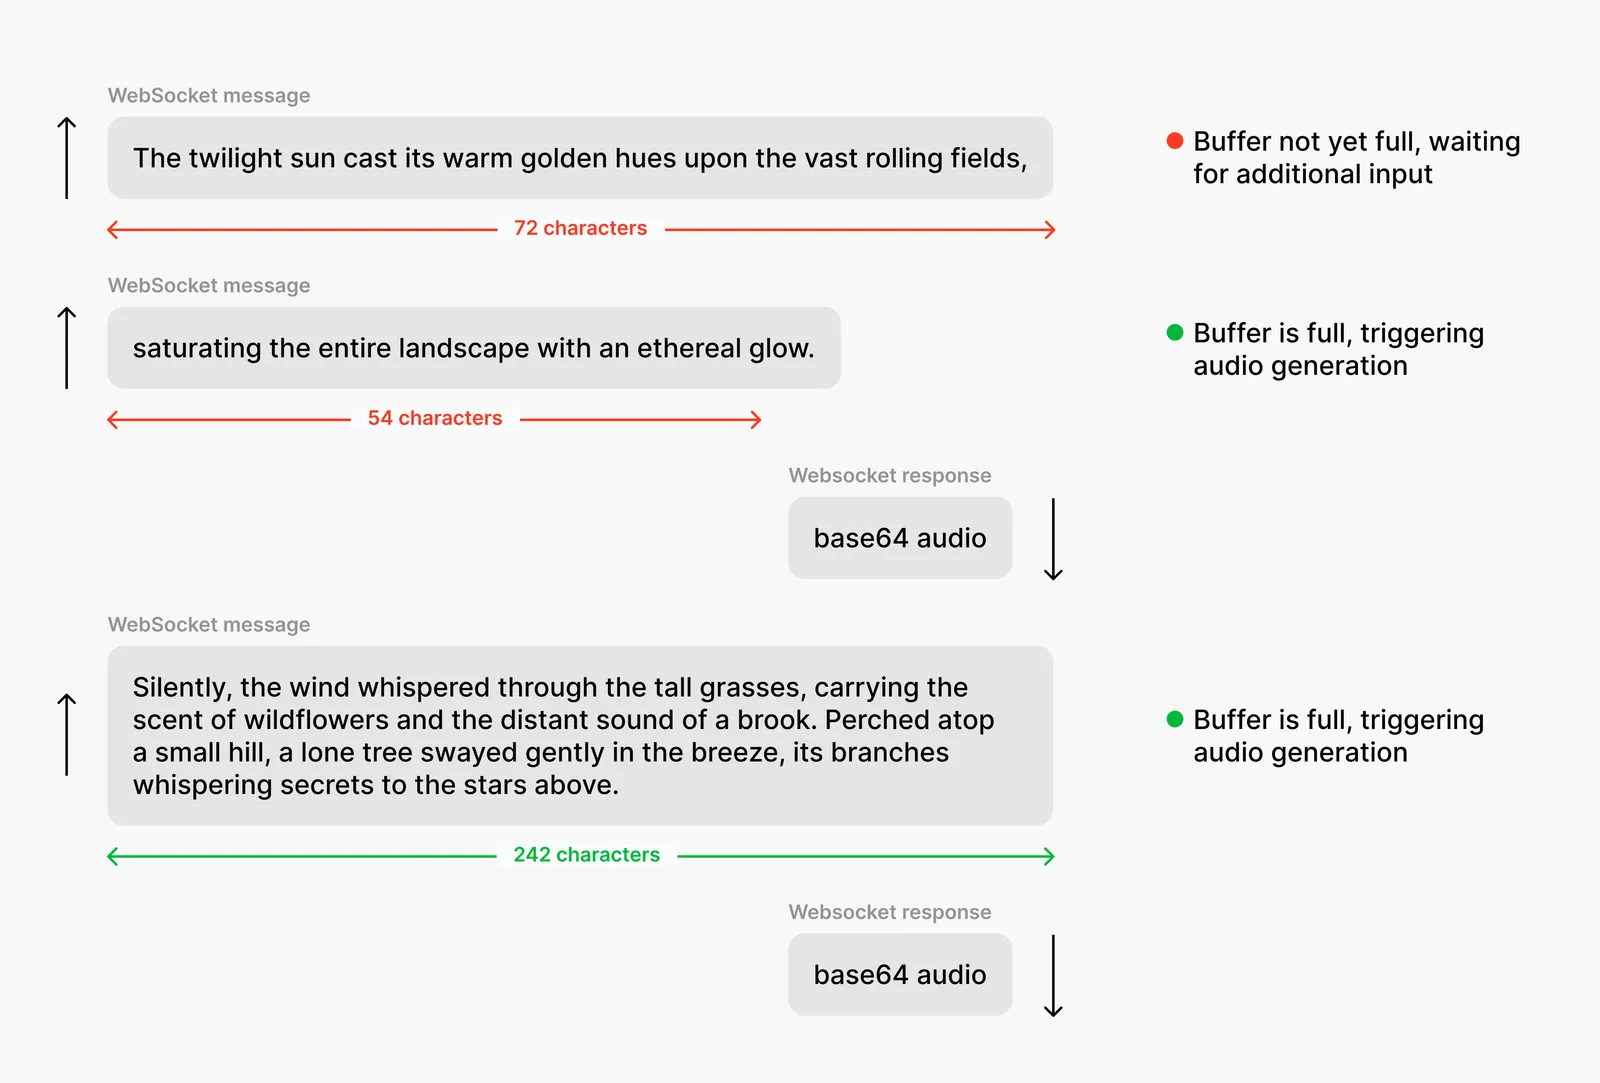
위 다이어그램에서는 두 번째 메시지가 서버로 전송된 후에야 오디오가 생성됩니다. 첫 번째 메시지는 120자 임계값에 미치지 못하지만, 두 번째 메시지가 추가되면 총 문자 수가 임계값을 넘기기 때문입니다. 세 번째 메시지는 160자 임계값을 넘으므로 오디오가 즉시 생성되어 클라이언트로 반환됩니다.
WebSocket 연결을 초기화할 때 또는 텍스트를 전송할 때 chunk_length_schedule의 사용자 지정 값을 지정할 수 있습니다.
오디오를 즉시 반환하도록 강제하려면 flush: true를 사용하여 버퍼를 비우고 버퍼링된 텍스트를 강제로 생성할 수 있습니다. 예를 들어 문서의 끝에 도달하여 마지막 섹션의 오디오를 생성하려는 경우에 유용합니다.
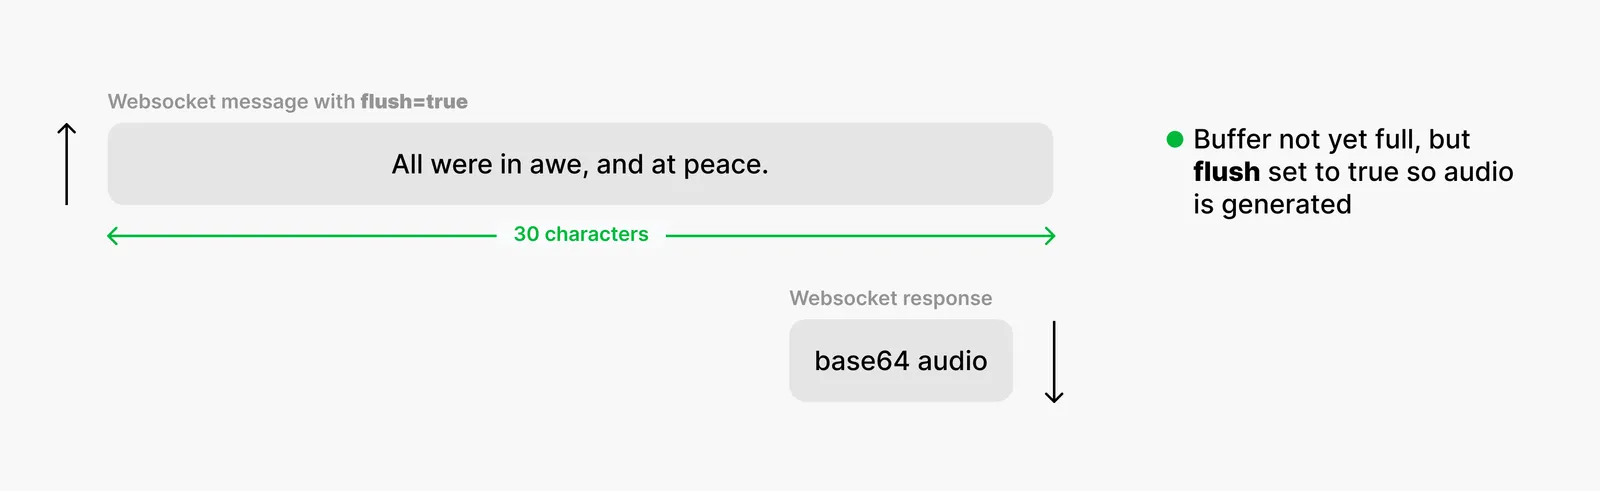
메시지에서 flush: true를 설정하면 메시지별로 이를 지정할 수 있습니다.
또한 WebSocket을 닫으면 버퍼링된 텍스트가 자동으로 강제 생성됩니다.
음성 설정
WebSocket 연결을 초기화할 때 이후 생성에 적용할 음성 설정을 지정할 수 있습니다. 이를 통해 생성된 오디오의 속도, 안정성 및 기타 음성 특성을 제어할 수 있습니다.
메시지에서 다른 voice_settings를 지정하면 메시지별로 이를 재정의할 수 있습니다.
발음 사전
발음 사전을 사용하여 특정 단어나 문구의 발음을 제어할 수 있습니다. 특정 단어가 올바르게 발음되도록 하거나 특정 단어 또는 문구를 강조할 때 유용합니다.
voice_settings 및 generation_config와 달리 발음 사전은 “Initialize Connection” 메시지에서 지정해야 합니다. 자세한 내용은 API 레퍼런스를 참조하세요.
WebSocket에서 음소 기반 발음 사전을 사용할 때는 WebSocket URI에 쿼리 파라미터로 enable_ssml_parsing=true를 추가해야 합니다. 예:
권장 사항
generation_config에서chunk_length_schedule의 기본 설정을 사용하는 것이 좋습니다.- 실시간 대화형 에이전트 애플리케이션을 개발할 때는 적시에 오디오가 생성되도록 대화 턴 끝의 텍스트와 함께
flush: true를 사용하는 것이 좋습니다. - 기본 설정이 사용 사례에 최적의 지연 시간을 제공하지 않는다면
chunk_length_schedule을 수정할 수 있습니다. 단, 이 조정으로 지연 시간을 줄이면 품질이 저하될 수 있다는 점에 유의하세요.
팁
- WebSocket 연결은 20초 동안 활동이 없으면 자동으로 닫힙니다. 연결을 유지하려면 공백 문자 하나인
" "를 전송할 수 있습니다. 완전히 빈 문자열인""을 전송하면 WebSocket이 닫히므로, 이 문자열에는 반드시 공백이 포함되어야 합니다. - 마지막 텍스트 메시지를 전송한 후 WebSocket 연결을 닫으려면 빈 문자열을 전송하세요.
alignment을 사용하면 텍스트의 각 단어에 대한 단어 수준 타임스탬프를 얻을 수 있습니다. 비디오에서 오디오와 텍스트를 동기화하거나 정밀한 타이밍이 필요한 다른 애플리케이션에 유용합니다. 자세한 내용은 API 레퍼런스를 참조하세요.