즉시 음성 복제
업계 최고 수준의 모델로 음성을 즉시 복제하는 방법을 알아보세요.
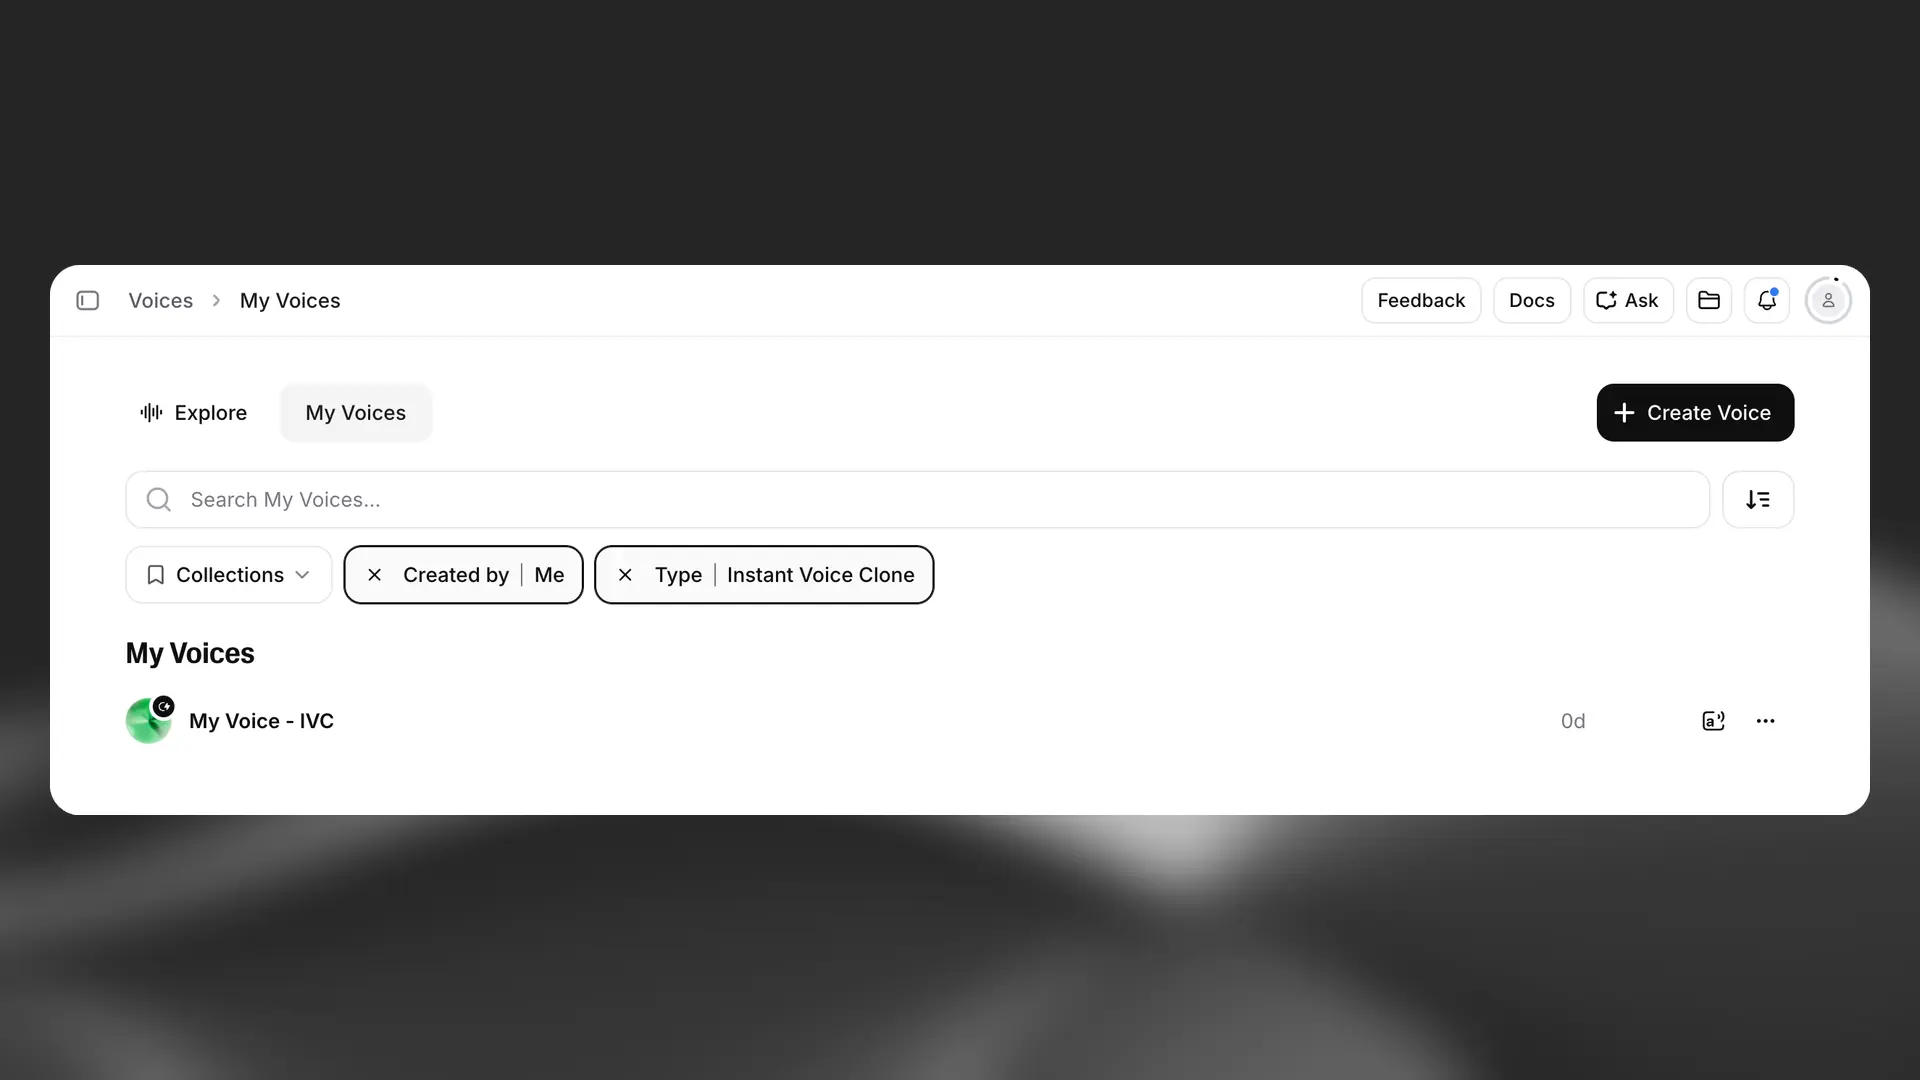
즉석 음성 복제 만들기
음성을 복제할 때는 AI가 어떤 언어와 어떤 유형의 데이터셋으로 학습되었는지 고려하는 것이 중요합니다. 각 모델과 그 강점에 관한 자세한 내용은 모델 페이지에서 확인하세요.
가이드
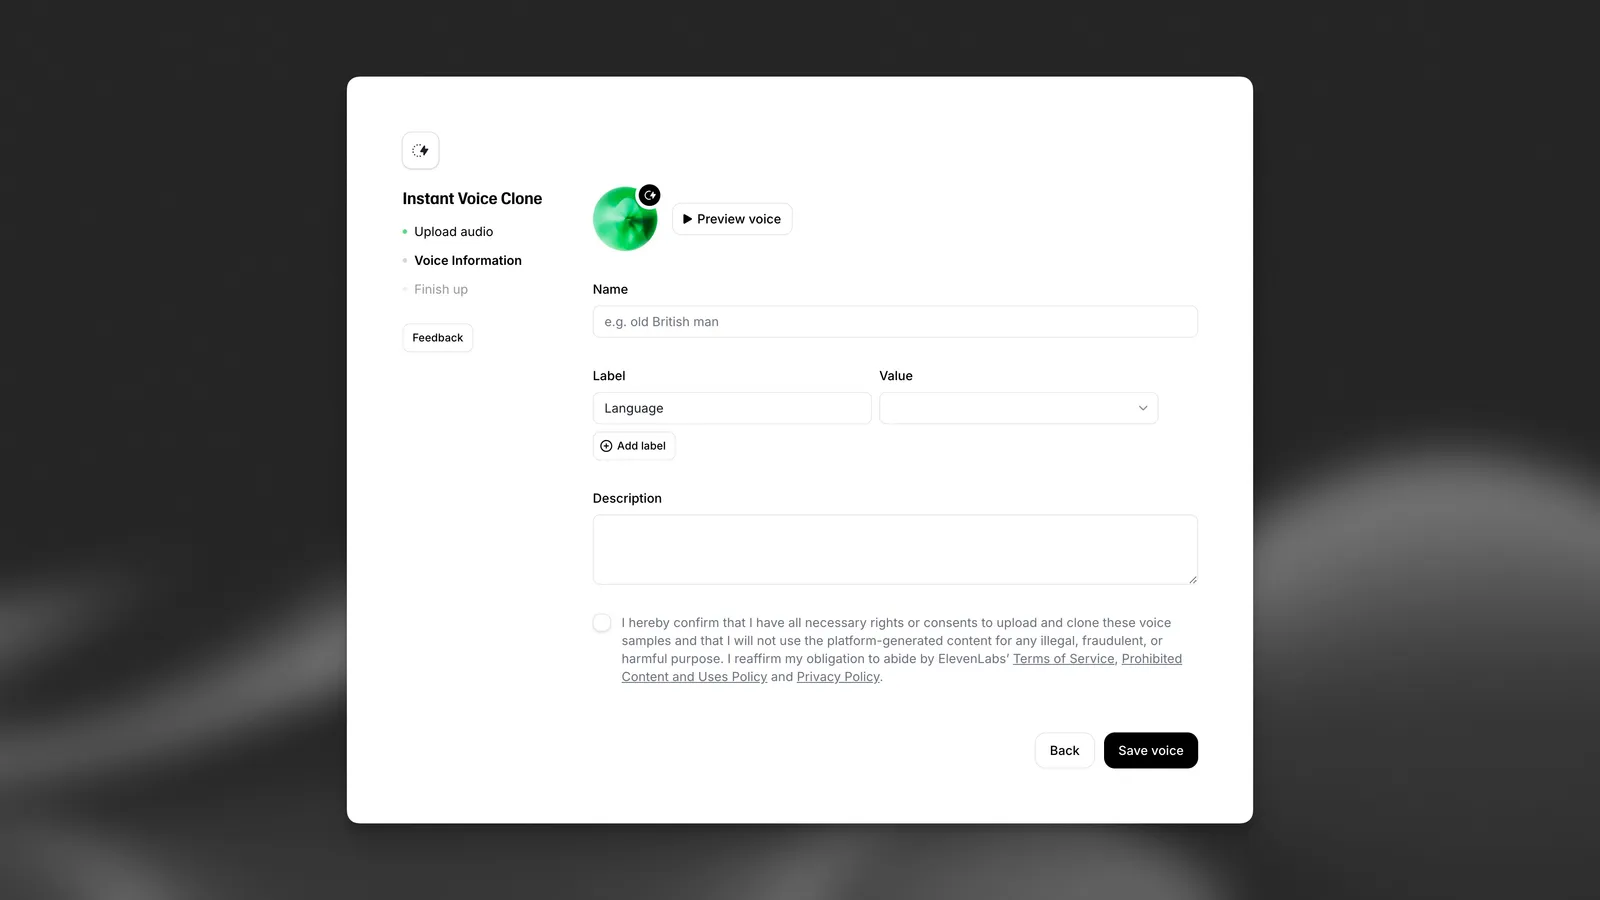
모범 사례
최소 1분 분량의 오디오 녹음
최소 1분 분량의 오디오 녹음
3분을 초과해 녹음하지 마세요. 개선 효과는 거의 없으며, 경우에 따라 복제 품질에 오히려 해로울 수 있습니다.
오디오를 어떻게 녹음했는지가 샘플의 총 길이(총 재생 시간)보다 더 중요합니다. 사용하는 샘플 수는 중요하지 않으며, 중요한 것은 합산된 총 길이(총 재생 시간)입니다.
리버브, 아티팩트 또는 어떤 종류의 배경 소음도 없는 선명한 오디오를 약 1~2분 사용하는 것이 좋습니다. 여기서 “오디오 또는 녹음 품질”이란 MP3나 WAV 같은 코덱을 뜻하는 것이 아니라 오디오를 캡처한 방식을 뜻합니다. 다만 오디오 코덱의 경우 128kbps 이상의 MP3 사용을 권장합니다. 더 높은 비트레이트는 복제 품질에 큰 영향을 주지 않습니다.
오디오의 일관성 유지
오디오의 일관성 유지
AI는 오디오에서 들리는 모든 것을 모방하려고 합니다. 여기에는 화자의 말하기 속도, 억양, 액센트, 음색, 호흡 패턴과 강도는 물론 노이즈와 입소리도 포함됩니다. 혼란을 줄 수 있는 노이즈와 아티팩트도 반영됩니다.
음성이 일관된 톤과 퍼포먼스를 유지하도록 하세요. 또한 모든 샘플에서 음성의 오디오 품질이 일관되게 유지되도록 하세요. 샘플을 하나만 사용하더라도 전체 샘플에 걸쳐 일관성을 유지해야 합니다. 음높이와 볼륨의 변동 폭이 큰 매우 역동적인 오디오를 AI에 입력하면 결과 예측성이 낮아집니다.
퍼포먼스 재현
퍼포먼스 재현
또 하나 기억할 점은 AI가 제공한 음성의 퍼포먼스를 재현하려 한다는 것입니다. 감정 표현이 거의 없는 느리고 단조로운 목소리로 말하면 AI도 그렇게 모방합니다. 반대로 감정을 많이 담아 빠르게 말하면 AI는 그 방식을 재현하려고 합니다.
톤뿐 아니라 퍼포먼스 측면에서도 모든 샘플에서 음성이 일관되게 유지되는 것이 중요합니다. 편차가 너무 크면 AI가 혼란을 겪어 생성 결과 간 변동이 더 커질 수 있습니다.
적절한 볼륨 균형 찾기
적절한 볼륨 균형 찾기
오디오가 너무 작거나 크지 않도록 적절한 볼륨 균형을 맞추세요. 이상적인 수준은 실제 피크 -3dB 기준으로 -23dB~-18dB RMS입니다.
FAQ
|
|
|
|
|
|
|
|
|