
Hoppa till navigering

Speech to Text

En guide till hur du transkriberar ljud med ElevenLabs
Text to Speech-produktfunktion

Översikt

Med speech to text kan du transkribera talat ljud till text med branschledande precision. Med automatisk språkidentifiering kan du transkribera ljud på många olika språk.

Skapa en transkription

1

Ladda upp ljud

I ElevenLabs-kontrollpanelen går du till sidan Speech to Text och klickar på knappen “Transcribe files”. I dialogrutan kan du ladda upp en ljud- eller videofil för transkribering.
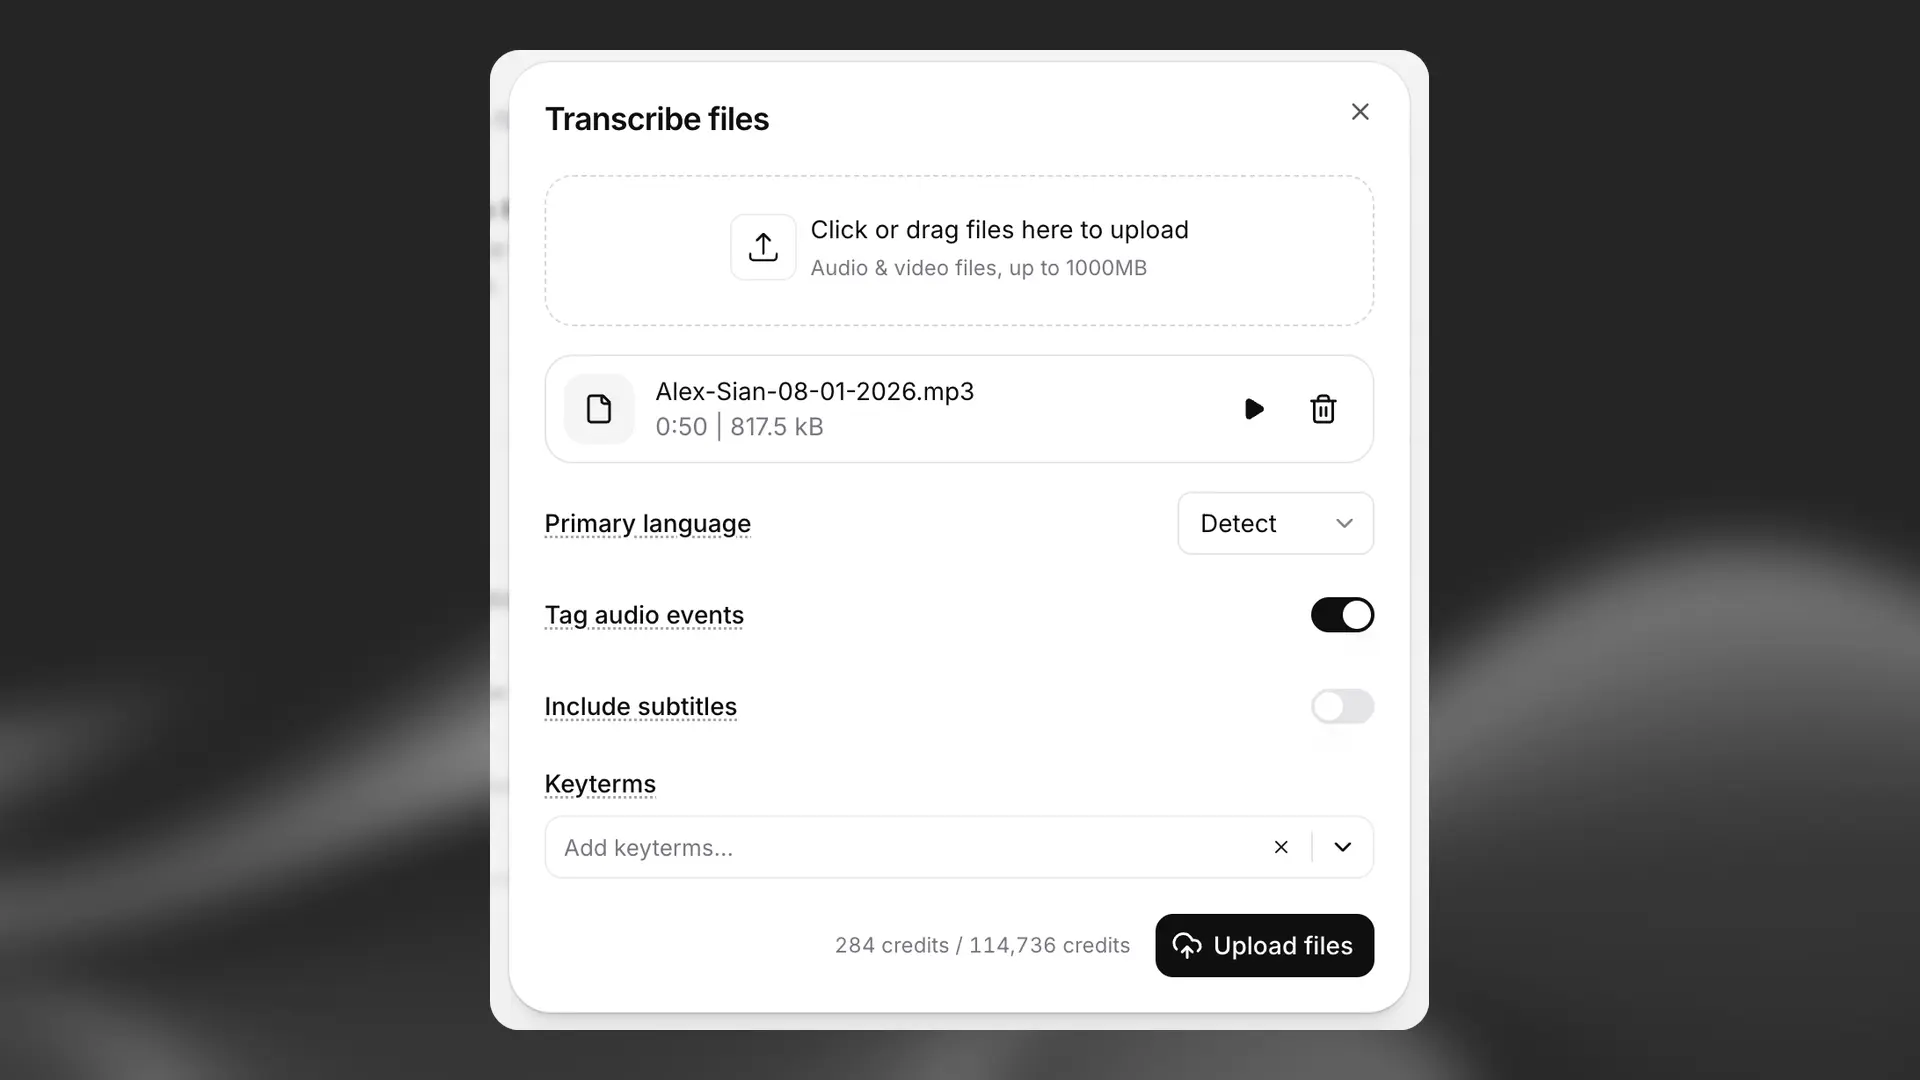
Uppladdning i Speech to Text

2

Välj alternativ

  • Välj ljudets primära språk om du känner till det. Du kan lämna inställningen på “Detect”, så identifieras alla språk i ljudet automatiskt.

  • Välj om du vill tagga ljudhändelser som skratt eller applåder med reglaget “Tag audio events”.

  • Med nyckelordspromptar kan du lägga till upp till 1 000 ord eller fraser för att styra modellen mot att transkribera dem. Det är användbart för att transkribera specifika ord eller meningar som inte är vanliga i ljudet, till exempel produktnamn, namn eller andra specifika termer.

När du är redo klickar du på knappen “Upload files” för att skicka in.

3

Visa resultat

Klicka på namnet på ljudfilen du laddade upp i mittenpanelen för att visa resultaten. Du kan klicka på ett ord för att börja spela upp ljudet från den punkten.

Klicka på knappen “Export” uppe till höger för att ladda ner resultaten i olika format.

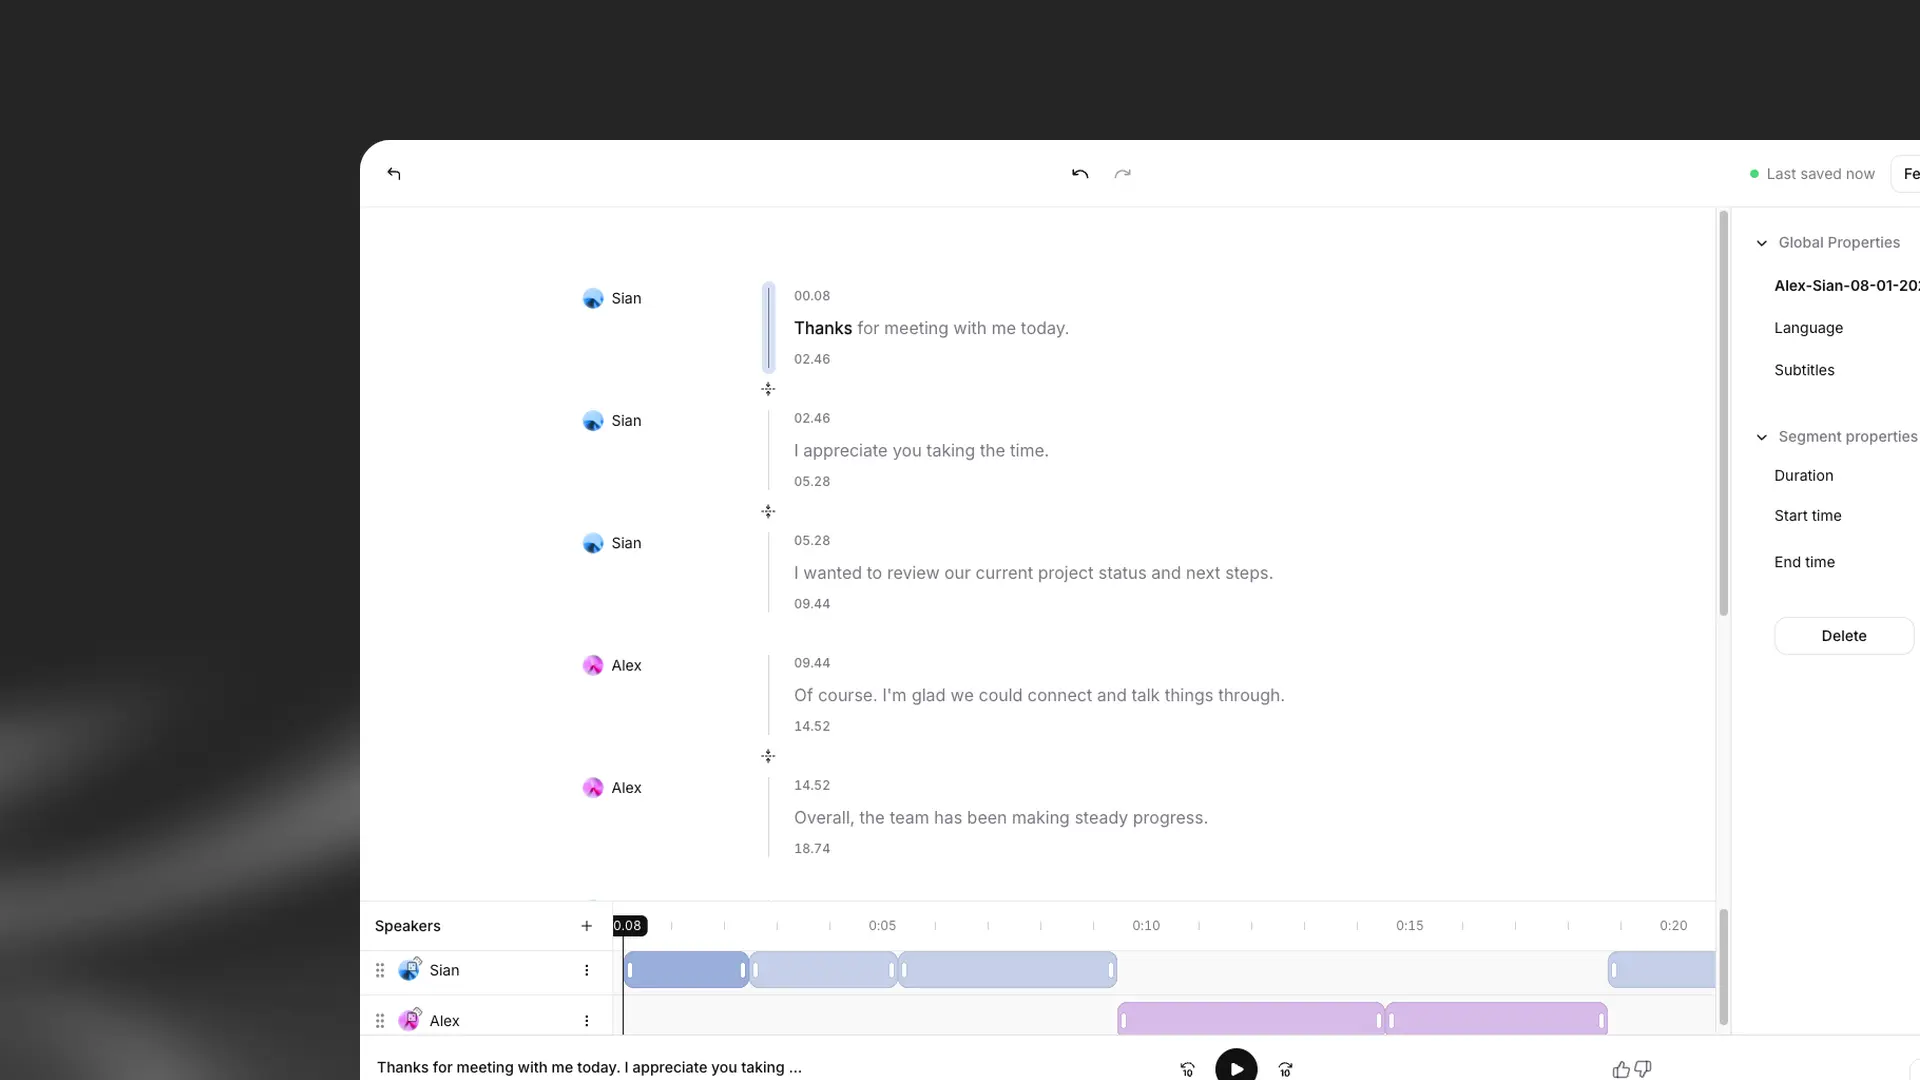
Transkriptredigeraren

När du har skapat en transkription kan du redigera den i vår transkriptredigerare. Läs mer i den här guiden.

Vanliga frågor

Ja, verktyget stöder uppladdning av både ljud- och videofiler. Den maximala filstorleken för båda är 3 GB.

Byta namn på talare

Ja, du kan byta namn på talare genom att klicka på knappen “edit” bredvid etiketten “Speakers”.

Speech to Text omvandlar talat ljud till skriven text. På ElevenLabs heter vår Speech to Text-modell Scribe. Med den kan du transkribera tal korrekt på över 90 språk, så att du enkelt kan omvandla ljud till läsbar och sökbar text.

Viktiga funktioner i Scribe

  • Branschledande precision, med 98 % precision för stora språk som engelska, franska, italienska, portugisiska, spanska och tyska.
  • Exakta tidsstämplar på ordnivå, så att du kan se precis när varje ord sägs.
  • Smart talaridentifiering som automatiskt identifierar och skiljer mellan olika talare.
  • Dynamisk ljudtaggning för att upptäcka ljud som inte är tal.
  • Stöd för upp till 32 talare med fortsatt hög precision.

Nyheter i Scribe v2

Scribe v2 bygger vidare på kärnmodellen med ytterligare funktioner för mer krävande användningsområden.

  • Nyckeltermsinstruktioner. Du kan ange upp till 100 ord eller fraser för att hjälpa modellen att transkribera viktiga termer korrekt. Användning av nyckeltermsinstruktioner ökar kostnaden med 20 %.
  • Entitetsidentifiering. Du kan välja specifika informationskategorier som ska upptäckas i transkriptionen, till exempel kreditkortsnummer, namn eller medicinska tillstånd. Entitetsidentifiering är endast tillgänglig via API och ökar kostnaden med 30 %.
  • Smart stöd för flera språk. Du kan skicka in ljud som innehåller flera språk, och Scribe v2 identifierar och transkriberar automatiskt varje språk korrekt.
  • Förbättrad stabilitet. Scribe v2 hanterar pauser, tonförändringar och långa tystnader utan att avbrytas eller tappa precision.

Vilken version bör du använda?

Vi rekommenderar Scribe v2 när transkribering med hög precision krävs. Den finns tillgänglig via vår webbplats och API. När du använder Speech to Text via vår webbplats är Scribe v2 standardmodellen.

För medicinskt och kliniskt ljud använder du Scribe v2 Medical (scribe_v2_medical) via samma API. Den debiteras till samma pris som Scribe v2.

För användning i realtid rekommenderar vi Scribe v2 Realtime, som är tillgänglig via ElevenAgents och API.

Mer information finns i vår dokumentation för Speech to Text.

Speech to Text har stöd för över 90 språk.

En fullständig översikt över vilka språk som stöds finns i avsnittet om språkstöd i vår dokumentation för Speech to Text.

Gränsen för samtidighet (förfrågningar som körs parallellt) beror på din prenumeration och på om du använder Speech to Text eller Realtime Speech to Text.

Nedan visas de aktuella gränserna för samtidighet för Speech to Text.

PlanGräns för samtidighet i Speech to TextGräns för samtidighet i Realtime Speech to Text
Free86
Starter129
Creator2015
Pro4030
Scale6045
Business6045
EnterpriseUtökadUtökad

Om du behöver fler samtidiga förfrågningar kan du kontakta vår Enterprise-avdelning direkt via den här webbsidan. Vi diskuterar gärna en skräddarsydd plan som uppfyller dina specifika behov.

No results