

模型
模型
旗舰模型
文本转语音
语音转文本
音乐
模型概览
ElevenLabs API 提供多种音频模型,针对不同使用场景、质量等级和性能要求进行了优化。
已弃用模型
eleven_turbo_v2_5 和 eleven_turbo_v2 模型分别在功能上等同于
eleven_flash_v2_5 和 eleven_flash_v2,但 Flash 模型的平均延迟更低。建议在所有使用场景中优先使用 Flash 模型,而非 Turbo 模型。
Eleven v4
Eleven v4 是我们先进的语音合成模型,可提供最高质量的音频、丰富表现力,以及对音色演绎方式的精细控制。Eleven v4 支持高保真语音克隆,在生成长文本时也能稳定保留说话人特征。
该模型尤其适合以下场景:
- 角色旁白配音:凭借丰富的情感表现力,非常适合游戏和动画。
- 情感对话:生成自然逼真的对话,具有丰富情感表现力和上下文理解能力。
- 有声书制作:适合需要复杂情感演绎的长篇旁白。
- 多语言项目:在切换语言时保持一致的音色质量。
可通过文本转对话 API 使用 Eleven v4。
支持的语言
Eleven v4 模型系列支持 90+ 种语言,包括:
南非荷兰语(afr)、阿姆哈拉语(amh)、阿拉伯语(ara)、亚美尼亚语(hye)、阿萨姆语(asm)、阿斯图里亚斯语(ast)、阿塞拜疆语(aze)、白俄罗斯语(bel)、孟加拉语(ben)、波斯尼亚语(bos)、保加利亚语(bul)、缅甸语(mya)、粤语(yue)、加泰罗尼亚语(cat)、宿务语(ceb)、克罗地亚语(hrv)、捷克语(ces)、丹麦语(dan)、荷兰语(nld)、英语(eng)、爱沙尼亚语(est)、菲律宾语(fil)、芬兰语(fin)、法语(fra)、富拉语/普拉尔语(ful)、加利西亚语(glg)、格鲁吉亚语(kat)、德语(deu)、希腊语(ell)、古吉拉特语(guj)、豪萨语(hau)、希伯来语(heb)、印地语(hin)、匈牙利语(hun)、冰岛语(isl)、印尼语(ind)、意大利语(ita)、日语(jpn)、爪哇语(jav)、坎巴语(kam)、卡纳达语(kan)、哈萨克语(kaz)、韩语(kor)、吉尔吉斯语(kir)、老挝语(lao)、拉脱维亚语(lav)、林加拉语(lin)、立陶宛语(lit)、卢干达语(lug)、卢森堡语(ltz)、马其顿语(mkd)、马来语(msa)、马拉雅拉姆语(mal)、马耳他语(mlt)、普通话(cmn)、毛利语(mri)、马拉地语(mar)、蒙古语(mon)、尼泊尔语(nep)、挪威博克马尔语(nob)、奥克语(oci)、奥里亚语(ori)、普什图语(pus)、波斯语(fas)、波兰语(pol)、巴西葡萄牙语(por)、旁遮普语(pan)、罗马尼亚语(ron)、俄语(rus)、塞尔维亚语(srp)、绍纳语(sna)、信德语(snd)、斯洛伐克语(slk)、斯洛文尼亚语(slv)、索马里语(som)、索拉尼库尔德语(ckb)、拉丁美洲西班牙语(spa)、斯瓦希里语(swa)、瑞典语(swe)、塔吉克语(tgk)、泰米尔语(tam)、泰卢固语(tel)、泰语(tha)、土耳其语(tur)、乌克兰语(ukr)、乌尔都语(urd)、乌兹别克语(uzb)、越南语(vie)、威尔士语(cym)、沃洛夫语(wol)、祖鲁语(zul)。
Eleven v4 Turbo
Eleven v4 Turbo 是我们先进的实时语音合成模型,可提供高质量音频、丰富表现力,以及对音色演绎方式的精细控制。Eleven v4 Turbo 支持高保真语音克隆,推理延迟中位数约为 100ms。
该模型尤其适合以下场景:
- 支持智能体:为实时解决客户问题的语音智能体提供支持。
- AI 助手:生成自然逼真的对话,具有丰富情感表现力和上下文理解能力。
- 互动角色:非常适合包含富有表现力角色的音频体验。
可通过文本转对话 WebSocket 使用 Eleven v4 Turbo。
支持的语言
Eleven v4 模型系列支持 90+ 种语言,包括:
南非荷兰语(afr)、阿姆哈拉语(amh)、阿拉伯语(ara)、亚美尼亚语(hye)、阿萨姆语(asm)、阿斯图里亚斯语(ast)、阿塞拜疆语(aze)、白俄罗斯语(bel)、孟加拉语(ben)、波斯尼亚语(bos)、保加利亚语(bul)、缅甸语(mya)、粤语(yue)、加泰罗尼亚语(cat)、宿务语(ceb)、克罗地亚语(hrv)、捷克语(ces)、丹麦语(dan)、荷兰语(nld)、英语(eng)、爱沙尼亚语(est)、菲律宾语(fil)、芬兰语(fin)、法语(fra)、富拉语/普拉尔语(ful)、加利西亚语(glg)、格鲁吉亚语(kat)、德语(deu)、希腊语(ell)、古吉拉特语(guj)、豪萨语(hau)、希伯来语(heb)、印地语(hin)、匈牙利语(hun)、冰岛语(isl)、印尼语(ind)、意大利语(ita)、日语(jpn)、爪哇语(jav)、坎巴语(kam)、卡纳达语(kan)、哈萨克语(kaz)、韩语(kor)、吉尔吉斯语(kir)、老挝语(lao)、拉脱维亚语(lav)、林加拉语(lin)、立陶宛语(lit)、卢干达语(lug)、卢森堡语(ltz)、马其顿语(mkd)、马来语(msa)、马拉雅拉姆语(mal)、马耳他语(mlt)、普通话(cmn)、毛利语(mri)、马拉地语(mar)、蒙古语(mon)、尼泊尔语(nep)、挪威博克马尔语(nob)、奥克语(oci)、奥里亚语(ori)、普什图语(pus)、波斯语(fas)、波兰语(pol)、巴西葡萄牙语(por)、旁遮普语(pan)、罗马尼亚语(ron)、俄语(rus)、塞尔维亚语(srp)、绍纳语(sna)、信德语(snd)、斯洛伐克语(slk)、斯洛文尼亚语(slv)、索马里语(som)、索拉尼库尔德语(ckb)、拉丁美洲西班牙语(spa)、斯瓦希里语(swa)、瑞典语(swe)、塔吉克语(tgk)、泰米尔语(tam)、泰卢固语(tel)、泰语(tha)、土耳其语(tur)、乌克兰语(ukr)、乌尔都语(urd)、乌兹别克语(uzb)、越南语(vie)、威尔士语(cym)、沃洛夫语(wol)、祖鲁语(zul)。
Eleven v3
Eleven v3 是我们的上一代语音合成模型,可生成自然逼真的语音,并在多种语言中提供丰富的情感表现力和上下文理解能力。
Eleven v3 引入了新的文本转对话 API,可让你在多种语言中生成自然逼真的对话,并具备丰富的情感表现力和上下文理解能力。Eleven v3 也可配合文本转语音 API 使用,在多种语言中生成自然逼真的语音,并具备丰富的情感表现力和上下文理解能力。
在此处了解有关文本转对话 API 的更多信息。
支持的语言
Eleven v3 模型支持 70+ 种语言,包括:
南非荷兰语(afr)、阿拉伯语(ara)、亚美尼亚语(hye)、阿萨姆语(asm)、阿塞拜疆语(aze)、白俄罗斯语(bel)、孟加拉语(ben)、波斯尼亚语(bos)、保加利亚语(bul)、加泰罗尼亚语(cat)、宿务语(ceb)、齐切瓦语(nya)、克罗地亚语(hrv)、捷克语(ces)、丹麦语(dan)、荷兰语(nld)、英语(eng)、爱沙尼亚语(est)、菲律宾语(fil)、芬兰语(fin)、法语(fra)、加利西亚语(glg)、格鲁吉亚语(kat)、德语(deu)、希腊语(ell)、古吉拉特语(guj)、豪萨语(hau)、希伯来语(heb)、印地语(hin)、匈牙利语(hun)、冰岛语(isl)、印尼语(ind)、爱尔兰语(gle)、意大利语(ita)、日语(jpn)、爪哇语(jav)、卡纳达语(kan)、哈萨克语(kaz)、吉尔吉斯语(kir)、韩语(kor)、拉脱维亚语(lav)、林加拉语(lin)、立陶宛语(lit)、卢森堡语(ltz)、马其顿语(mkd)、马来语(msa)、马拉雅拉姆语(mal)、普通话(cmn)、马拉地语(mar)、尼泊尔语(nep)、挪威语(nor)、普什图语(pus)、波斯语(fas)、波兰语(pol)、葡萄牙语(por)、旁遮普语(pan)、罗马尼亚语(ron)、俄语(rus)、塞尔维亚语(srp)、信德语(snd)、斯洛伐克语(slk)、斯洛文尼亚语(slv)、索马里语(som)、西班牙语(spa)、斯瓦希里语(swa)、瑞典语(swe)、泰米尔语(tam)、泰卢固语(tel)、泰语(tha)、土耳其语(tur)、乌克兰语(ukr)、乌尔都语(urd)、越南语(vie)、威尔士语(cym)。
Eleven v3 Conversational
Eleven v3 Conversational 是我们的上一代实时语音合成模型。它可在多种语言中生成自然逼真的语音,并具备丰富的情感表现力和上下文理解能力。
Eleven v3 Conversational 引入了新的文本转对话 WebSocket,可让你在多种语言中生成自然逼真的对话,并具备丰富的情感表现力和上下文理解能力。
Eleven v3 Conversational 引入了新的文本转对话 WebSocket,可让你在多种语言中生成自然逼真的对话,并具备丰富的情感表现力和上下文理解能力。
在此处了解有关文本转对话 WebSocket 的更多信息。
支持的语言
Eleven v3 模型支持 70+ 种语言,包括:
南非荷兰语(afr)、阿拉伯语(ara)、亚美尼亚语(hye)、阿萨姆语(asm)、阿塞拜疆语(aze)、白俄罗斯语(bel)、孟加拉语(ben)、波斯尼亚语(bos)、保加利亚语(bul)、加泰罗尼亚语(cat)、宿务语(ceb)、齐切瓦语(nya)、克罗地亚语(hrv)、捷克语(ces)、丹麦语(dan)、荷兰语(nld)、英语(eng)、爱沙尼亚语(est)、菲律宾语(fil)、芬兰语(fin)、法语(fra)、加利西亚语(glg)、格鲁吉亚语(kat)、德语(deu)、希腊语(ell)、古吉拉特语(guj)、豪萨语(hau)、希伯来语(heb)、印地语(hin)、匈牙利语(hun)、冰岛语(isl)、印尼语(ind)、爱尔兰语(gle)、意大利语(ita)、日语(jpn)、爪哇语(jav)、卡纳达语(kan)、哈萨克语(kaz)、吉尔吉斯语(kir)、韩语(kor)、拉脱维亚语(lav)、林加拉语(lin)、立陶宛语(lit)、卢森堡语(ltz)、马其顿语(mkd)、马来语(msa)、马拉雅拉姆语(mal)、普通话(cmn)、马拉地语(mar)、尼泊尔语(nep)、挪威语(nor)、普什图语(pus)、波斯语(fas)、波兰语(pol)、葡萄牙语(por)、旁遮普语(pan)、罗马尼亚语(ron)、俄语(rus)、塞尔维亚语(srp)、信德语(snd)、斯洛伐克语(slk)、斯洛文尼亚语(slv)、索马里语(som)、西班牙语(spa)、斯瓦希里语(swa)、瑞典语(swe)、泰米尔语(tam)、泰卢固语(tel)、泰语(tha)、土耳其语(tur)、乌克兰语(ukr)、乌尔都语(urd)、越南语(vie)、威尔士语(cym)。
Multilingual v2
Eleven Multilingual v2 是上一代情感感知语音合成模型。它可在多种语言中生成自然、逼真的语音,具备丰富的情感表达和上下文理解能力。
该模型可在所有支持的语言中保持一致的音色质量和个性,同时保留说话者的独特特征和口音。
此模型尤其适合需要高质量、细腻情感表达语音的场景:
- 角色旁白配音:情感表达丰富,适合游戏和动画。
- 专业内容:适合企业视频和在线学习材料。
- 多语言项目:切换语言时仍能保持一致的音色质量。
- 稳定质量:持续生成高质量音频。
虽然其延迟和每字符成本高于 Flash 模型,但对于重视逼真语音的项目,可提供更出色的质量。
多语言 v2 模型支持 29 种语言:
英语(美国、英国、澳大利亚、加拿大)、日语、中文、德语、印地语、法语(法国、加拿大)、韩语、葡萄牙语(巴西、葡萄牙)、意大利语、西班牙语(西班牙、墨西哥)、印尼语、荷兰语、土耳其语、菲律宾语、波兰语、瑞典语、保加利亚语、罗马尼亚语、阿拉伯语(沙特阿拉伯、阿联酋)、捷克语、希腊语、芬兰语、克罗地亚语、马来语、斯洛伐克语、丹麦语、泰米尔语、乌克兰语和俄语。
Flash v2.5
Eleven Flash v2.5 是我们速度最快的语音合成模型,专为实时应用和智能体平台设计。它支持 32 种语言,可提供高质量、超低延迟(约 75ms†)的语音。
该模型兼顾速度与质量,适合交互式应用,同时在不同语言中保持自然的输出和一致的音色特征。
此模型尤其适合:
- 智能体平台:非常适合实时语音智能体和聊天机器人。
- 交互式应用:适合游戏及需要即时响应的应用。
- 大规模处理:可高效批量转换文本为语音。
凭借更低的 API 生成价格和 75ms 延迟,Flash v2.5 是需要快速、可靠的多语言语音合成时更具成本效益的选择。
Flash v2.5 支持 32 种语言——包括 v2 模型支持的所有语言,以及:
匈牙利语、挪威语和越南语
† 不包括应用和网络延迟注意事项
数字文本规范化
使用 Flash v2.5 时,默认的数字规范化方式可能不符合预期。例如,电话号码的读法可能不够清晰。日期和货币也会受到类似影响。
为保持低延迟,Flash v2.5 默认禁用规范化。不过,企业版客户现在可在请求中将 apply_text_normalization 参数设为 “on”,为 v2.5 模型启用文本规范化。
Multilingual v2 模型在数字规范化方面表现更好,因此建议在电话号码及其他重视数字规范化的场景中使用它。
对于低延迟或智能体平台应用,最佳做法是在将文本传给 TTS 模型前,让 LLM 规范化文本,或使用 apply_text_normalization 参数(仅限企业版方案的 v2.5 模型)。
模型选择指南
如需了解哪种模型最符合需求和使用场景,请参阅模型选择指南。
需求
使用场景
字符限制
单次文本转语音请求支持的最大字符数因模型而异。
Scribe v2
Scribe v2 是我们先进的语音识别模型,专为准确转录 90 多种语言而设计。它提供精确到词级别的时间戳,以及说话人分离和动态音频标签等高级功能。
此模型尤其适合需要准确语音转文本的场景:
- 转录服务:适合将音频或视频内容转换为文本
- 会议文档:适合记录和整理对话内容
- 内容分析:适合处理和分析音频内容
- 多语言识别:支持准确转录 90 多种语言
主要功能:
- 带词级时间戳的准确转录
- 支持多人音频的说话人分离
- 通过动态音频标签增强上下文
- 支持 90 多种语言
- 实体检测
- 关键词提示
- 转录文本编辑
在此处了解更多 Scribe v2 信息。
Scribe v2 Realtime
Scribe v2 Realtime 是我们速度最快、准确度最高的实时语音识别模型,支持超过 90 种语言,以超低的 150ms 延迟提供先进的识别准确度。
此模型尤其适合对话场景:
- 实时会议转录:非常适合实时转录
- AI 智能体:适合实时对话
- 多语言识别:支持准确转录 90 多种语言,并能自动识别语言
主要功能:
- 超低延迟:约 150 毫秒即可获得部分转录结果
- 流式支持:可分块发送音频,同时实时接收转录文本
- 多种音频格式:支持 PCM(8kHz 至 48kHz)和 μ-law 编码
- 语音活动检测(VAD):基于静音检测自动分割语音
- 手动提交控制:可完全控制何时完成转录片段
- 实体检测
- 转录文本编辑
在此处了解更多 Scribe v2 Realtime 信息。
Scribe v2 Medical
Scribe v2 Medical 是专为医疗和临床音频打造的批量语音识别模型。它基于 Scribe v2 Finetune,在保持与 Scribe v2 相同日常语音识别准确度的同时,提升了对药物名称、解剖学、病理学和临床口述内容的识别能力。它使用与 Scribe v2 相同的语音转文本 API,计费标准也相同。将 scribe_v2_medical 作为 model_id 传入。
预期用途
Scribe v2 Medical 是一款批量语音转文本 API 模型,供开发者和 组织集成到应用中,将包括临床医生与患者对话、口述内容、接诊和照护协调通话在内的临床音频转换为 用于文档记录及相关管理工作流程的转录初稿。生成的文本 应在使用前由医疗专业人员或其他获授权用户审核和更正。Scribe v2 Medical 不用于解读临床信息,也不提供诊断、治疗 建议、临床决策或其他临床指导。
此模型非常适合:
- 临床文档:医疗术语在对话中出现的环境式问诊和记录
- 口述:包含大量药物、剂量和检查结果的连续内容
- 接诊和协调通话:患者描述自身状况的通话,通常通过电话进行
- 合规工作流程:结合实体检测识别 PHI 类别
主要功能:
- 与 Scribe v2 相同的请求格式(
keyterms、entity_detection、no_verbatim、说话人分离、时间戳) - 改进对药物名称、解剖学和病理学术语的识别
- 相比 Scribe v2,日常语音识别效果不降低
- 支持 90 多种语言
- 支持多人音频的说话人分离
- 动态音频标签
- 实体检测,包括 PHI 类别
Scribe v2 Medical 是批量模型。如需实时转录,请使用 Scribe v2 Realtime。
Scribe v2 Medical 符合 HIPAA 要求。企业版客户可获得商业合作伙伴协议,并可使用零保留模式(ZRM)。启用 ZRM 后,每次请求完成后会立即删除音频输入和文本输出。ElevenLabs 不会保留任何内容,应用将收到完整的 API 响应,并可自行控制转录文本的保留。
需要符合 HIPAA 要求的公司,必须在发送受保护健康信息前联系 ElevenLabs 销售团队,签署商业合作伙伴协议(BAA)。
在此处了解更多语音转文本信息。
Eleven Music
Eleven Music 是我们的录音室级音乐生成模型。你可以通过自然语言提示词,生成任何风格的音乐。
此模型非常适合以下场景:
- 游戏原声:为游戏创作沉浸式原声音乐
- 播客背景音乐:用专业音乐提升播客效果
- 营销:为广告短片添加背景音乐
主要功能:
- 完整控制流派、风格和结构
- 可生成带人声或纯器乐音乐
- 支持多种语言,包括英语、西班牙语、德语、日语等
- 编辑单个段落或整首歌曲的声音和歌词
在此处了解更多 Eleven Music 信息。
并发与优先级
订阅套餐决定可同时处理的请求数量,以及请求在队列中的优先级。 语音转文本具有更高的并发限制。 达到并发限制后,后续请求会与低优先级请求一起在队列中处理。 实际通常只会增加约 50ms 延迟。
响应标头包含 current-concurrent-requests 和 maximum-concurrent-requests,可用于监控并发情况。
每分钟 API 请求数与并发请求数
务必了解,每分钟 API 请求数 和 并发请求数 是两项不同的指标,具体取决于使用模式。
每分钟 API 请求数可能不同于并发请求数,因为它取决于每个请求的耗时以及请求的批处理方式。
示例 1:间隔发送请求 如果每分钟有 180 个请求,每个请求耗时 1 秒,且每隔 0.33 秒发送一个请求,最大并发请求数为 3,平均值也为 3,因为始终会有 3 个请求正在处理。
示例 2:批量请求 但如果使用模式不同,例如每分钟有 180 个请求,每个请求耗时 3 秒,但所有请求同时发出,那么最大并发请求数为 180,平均值为 9(该分钟的前 3 秒有 180 个请求同时处理,后 57 秒则为 0 个请求)。
由于系统关注的是并发,请求耗时和发送模式比每分钟请求数更重要。
端点请求方式会影响并发限制:
- 使用 HTTP 时,每个请求都会单独计入并发限制。
- 使用文本转语音 WebSocket 时,只有模型生成音频的时间会计入并发限制。这意味着在大多数情况下,打开的 websocket 完全不占用并发限制。
- 文本转对话 WebSocket 的工作方式不同:每个打开的连接只要保持开启,就会从单独的池中预留一个对话会话;通过该连接生成的音频不计入标准并发限制。这样更易于理解:一个连接就是一个会话,对话会话限制也会针对这一新的并发方法进行调整。请参阅文本转对话并发。
了解并发限制
套餐对应的并发限制不应理解为可同时处理的最大对话、电话、角色旁白配音等数量。 实际数量取决于多项因素,包括所使用的具体 AI 语音以及使用场景的特征。
一般来说,并发限制为 5 时,通常最多可支持约 100 路同时音频播报。
这是因为,相比处理 TTS 请求所需的时间,生成音频的速度更快。 下图展示了如何在仅达到 2 个并发请求的情况下,为 4 个不同用户同时提供通话服务。
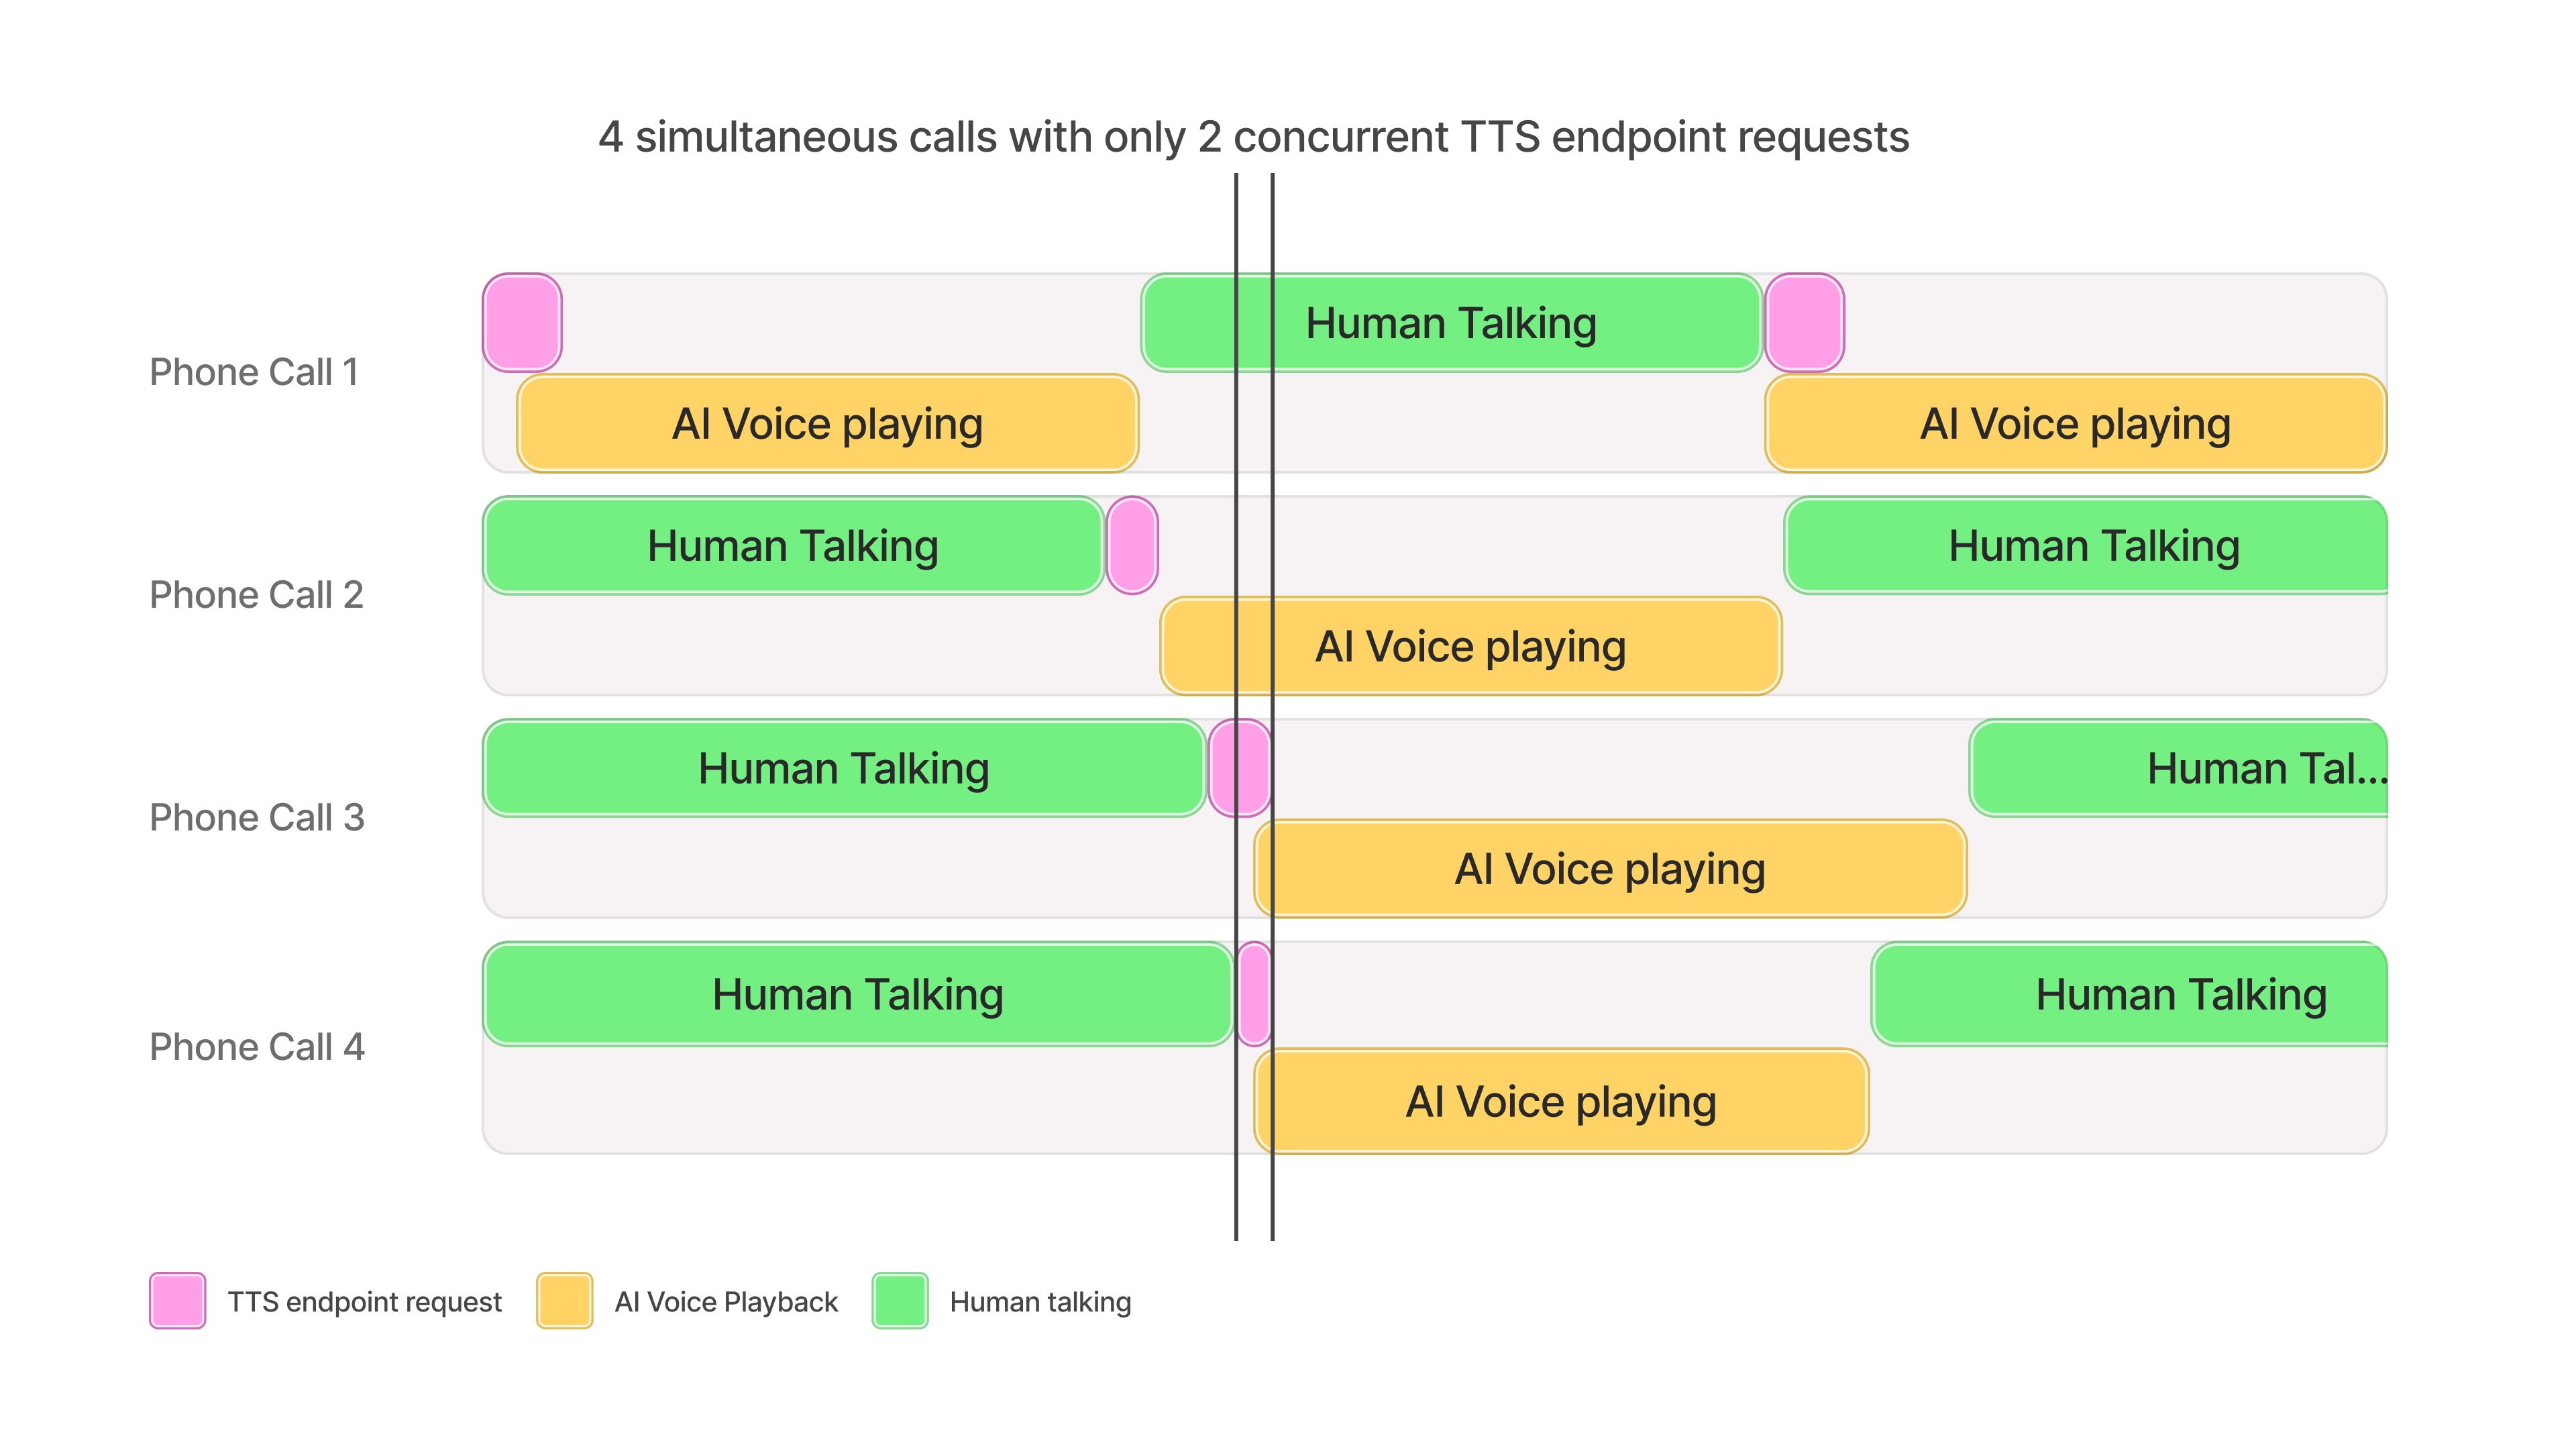
构建 AI 语音智能体
当 TTS 用于促成对话时,并发限制为 5 可支持约 100 路 AI 智能体与真人参与者之间较为均衡的对话播报。
如果 AI 智能体的发言频率低于真人,例如客户支持互动,则可支持超过 100 路同时对话。
角色旁白配音
一般来说,并发限制为 5 时,可支持超过 100 路同时角色旁白配音。
具体数量可能因角色对话频率、停顿时长以及台词间的游戏内操作而异。
实时配音
并发配音流通常遵循上述经验法则。
如果播报中包含对话停顿时段(例如因配乐、视觉场景等原因),则可能支持比建议值更多的同时配音流。
如果在任何时候超过套餐的并发限制,且使用的是企业版套餐,模型请求仍可能根据可用容量以尽力而为的方式成功处理,但速度会较慢。
如需提高并发限制和队列优先级,请升级订阅 套餐。
企业版客户可联系客户经理申请更高的并发限制。
文本转对话并发
文本转对话请求会根据调用 API 的方式,以两种不同方式计量:
- HTTP 端点(创建对话 和流式对话)会在生成音频时计入套餐的标准并发限制,与其他文本转语音请求相同。
- 文本转对话 WebSocket 等 WebSocket 端点 按 对话会话 计量。无论当前是否生成音频,打开的连接只要保持开启,就会占用一个对话会话。
基于会话的计量方式让容量规划更简单:一个连接就是一个会话,因此使用量不会随生成活动波动。由于会话会在整个连接期间占用,而非仅在生成音频时占用,对话会话限制已针对这一新的并发方法进行调整。
如果在工作区所有对话会话都已占用时打开连接,新连接会被拒绝,并返回 too_many_concurrent_requests 错误。要释放会话,请关闭不再需要的连接;除非发送 keep_alive 消息,否则连接在 20 秒无活动后也会自动关闭。
要监控对话会话,请在控制台侧边栏底部打开 开发者,选择 分析 标签页,然后在用量视图中查看 并发请求 指标。对话会话会作为独立数据系列 TTD Websocket Sessions 上报,与其他并发请求分开显示。
扩展测试并发限制
扩展测试有助于发现客户端扩展问题,并验证使用场景的并发限制是否设置正确。
强烈建议尽可能贴近真实使用情况测试端到端 workflow。推荐通过模拟并测量可支持的用户数量来实现这一点。重要事项:
- 模拟用户,而非原始请求
- 模拟典型用户行为,例如在发起请求前等待音频播放、用户说话或转写完成
- 在数分钟内逐步增加用户数量
- 为请求时间和请求大小引入随机性
- 记录延迟指标及 API 返回的所有错误代码
例如,要测试一个旨在支持 100 路同时对话的智能体系统,可以创建最多 100 个独立“用户”,每个用户各自模拟一段对话。对话通常由循环构成:用户说话约 10 秒,接着调用 TTS API 生成约 150 个字符的内容,然后向用户播放音频约 10 秒。因此,每位用户应每隔 20 秒通过 websocket 发起一次文本转语音 API 调用,请求生成 150 个字符的文本,并对等待时间和请求字符数加入少量随机性。测试时应每秒启动一位用户,直到达到 100 位,然后总共测试 10 分钟,以检验整体稳定性。