Modele interakcji: Naturalny dialog człowiek-AI
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Każdy, kto próbował przerwać AI agentowi głosowemu w połowie zdania, wie, jak to jest, gdy system nie jest stworzony do ludzkiej rozmowy. Rytm się nie zgadza, głos jest oderwany od treści, a nawet gdy informacje są poprawne, interakcja wydaje się nienaturalna: nie jak rozmowa z kompetentną osobą, lecz jak obsługa oprogramowania, które akurat używa słów.
Przyczyna tego nienaturalnego wrażenia jest strukturalna: wiele systemów głosowych AI stworzono do obsługi tur, a nie rozmów. Słuchają, przetwarzają i odpowiadają na jedną wymianę naraz. To działa w prostych demonstracjach, ale zawodzi, gdy rozmowa staje się emocjonalna i nieprzewidywalna.
Modele interakcji to systemy AI stworzone do komunikacji przez audio i tekst w czasie rzeczywistym. Rozumieją nie tylko, co zostało powiedziane, lecz także kiedy i jakiej emocjonalnej reakcji wymaga dana chwila. Ten artykuł wyjaśnia, czym model interakcji różni się od innych, dlaczego ma znaczenie dla firm wdrażających głosowe AI i jak ElevenLabs go rozwija.
Podsumowanie
- Większość głosowych systemów AI zawodzi w prawdziwej rozmowie, bo nie radzi sobie z przerwami, ciszą ani kontekstem przenoszonym między turami.
- System interakcji ElevenLabs obsługuje przerwania, pauzy i nakładającą się mowę bez utraty kontekstu ani płynności rozmowy.
- ElevenLabs rozwija prawdziwe modele interakcji dzięki zaawansowanej architekturze kaskadowej, własnym modelom Speech to Text (STT) i Text to Speech (TTS) oraz systemowi zoptymalizowanemu pod kątem niskich opóźnień i naturalnej, płynnej rozmowy.
Dlaczego większość komunikacji głosowej człowiek–AI nie brzmi naturalnie
Większość głosowych systemów AI traktuje rozmowę jako serię oddzielnych danych wejściowych i wyjściowych: system czeka na fragment wypowiedzi, zamienia go w tekst, przetwarza ten tekst i odpowiada. To działa w interakcjach typu polecenie–odpowiedź, ale prawdziwa rozmowa nie jest czystą sekwencją wymian tekstowych. To ciągła wymiana, pełna pauz i wtrąceń.
Usunięcie płynności między turami i kontekstu, który je łączy, prowadzi do trzech konkretnych problemów:
- Przerywa ci lub każe czekać: System nie odróżnia pauzy na zastanowienie od zakończonej tury, więc albo wchodzi ci w słowo, gdy jeszcze mówisz, albo milczy, gdy już skończysz. Zbierasz myśli w połowie zdania — zostajesz przerwany; kończysz wypowiedź — czekasz w martwej ciszy.
- Nie reaguje, gdy zacznie mówić: Gdy system zaczyna odpowiadać, przestaje słuchać. Jeśli mu przerwiesz, by zmienić temat, nadal udziela odpowiedzi na pytanie, które już cię nie interesuje, bo nie zauważa zmiany.
- Zapomina w trakcie: Każda tura jest przetwarzana osobno, więc kontekst sprzed pięciu wymian nie przechodzi dalej. Musisz się powtarzać albo system odpowiada, jakby rozmowa dopiero się zaczęła.
Rezultatem jest rozmowa, która może być poprawna pod względem funkcjonalnym, a mimo to wydawać się niewłaściwa.
Czego modele interakcji potrafią dokonać, a tradycyjne głosowe AI nie
Tradycyjne głosowe AI obsługuje jedną turę naraz, a model interakcji prowadzi całą rozmowę — jednocześnie uwzględnia to, co jest mówione, i to, co powinno wydarzyć się dalej. Różnica funkcjonalna polega na tym, że model interakcji reaguje na faktyczny stan wymiany, a nie tylko na ostatnie dane wejściowe.
Modele interakcji oferują:
- Reakcję w czasie rzeczywistym: System zaprojektowano tak, by odpowiadał w tempie rozmowy, a pełny cykl może trwać poniżej sekundy — zależnie od konfiguracji.
- Naturalną obsługę przerwań, ciszy i nakładającej się mowy: Odróżnia pauzę na zastanowienie od zakończonej tury, więc nie przerywa ludziom ani nie pozostawia martwej ciszy. Gdy klient wchodzi mu w słowo, by zmienić kierunek rozmowy, radzi sobie z tym bez utraty kontekstu ani zerwania rozmowy.
- Ciągłość przez całą rozmowę: Zamiast resetować kontekst przy każdej turze, system zachowuje historię rozmowy, więc to, co mówi w 10. turze, uwzględnia wszystko, co wydarzyło się od pierwszej.
- Dopasowany sposób mówienia: Głos można zaprogramować tak, by zmieniał sposób mówienia — był spokojniejszy, bardziej bezpośredni lub bardziej uspokajający — zależnie od wykonywanego zadania.
- Równoległe wykonywanie zadań: System jednocześnie pobiera informacje, wywołuje narzędzia i mówi, zamiast milczeć podczas wyszukiwania danych.
Testem modelu interakcji jest rozmowa, która idzie źle. Na nagraniu poniżej klient dzwoni w sprawie odwołanego lotu. Jest spięty i szybko potrzebuje rozwiązania problemu.

Agent od razu rozpoznaje pilność i frustrację klienta po słowach, których używa. Dostosowuje ton, obsługuje przerwanie bez gubienia wątku i wykorzystuje połączone narzędzia, by zaproponować realne rozwiązania dotyczące odwołanego lotu. Ostatecznie klient otrzymuje rozwiązanie bez udziału ludzkiego agenta.
Porównaj to z typowymi agentami działającymi turami, używanymi obecnie. Takie systemy czekałyby na każdą pauzę, odpowiadały z neutralnego poziomu i całkowicie przeoczyły frustrację klienta. Po kilku wymianach, które nie odnoszą się do tego, co rozmówca naprawdę czuje, rozmowa prawdopodobnie musiałaby trafić do człowieka, a klient byłby jeszcze bardziej sfrustrowany niż na początku.
Jak ElevenLabs rozwija modele interakcji
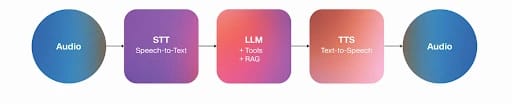
Nasz pipeline rozmowy korzysta z zaawansowanej architektury kaskadowej zamiast architektury łączonej, więc zamiast jednego modelu obsługującego wszystko, każdy etap ma własny wyspecjalizowany komponent.
Zaletą tego podejścia jest możliwość niezależnej optymalizacji każdego etapu pipeline’u i zastąpienia dowolnego komponentu lepszym modelem bez przebudowy całego systemu. Ponieważ tworzymy te komponenty we własnym zakresie, są wspólnie zoptymalizowane tak, by przekazywać sobie bogaty kontekst, a nie tylko dane. Dzięki temu pipeline nadal działa jak jedna spójna rozmowa, a nie łańcuch oddzielnych narzędzi.
Struktura modelu kaskadowego
Struktura modelu łączonego
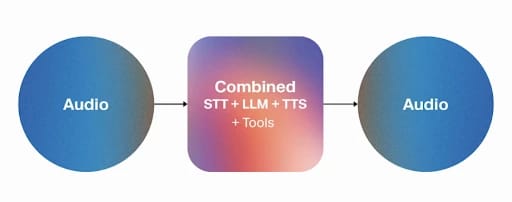
Grafiki: modele kaskadowe i łączone
Oto technologie, które obecnie tworzą ten pipeline:
- Scribe v2 Realtime: Nasz własny model STT transkrybuje mowę w około 150 ms w ponad 90 językach, dobrze radząc sobie z hałasem w tle, akcentami, przerwaniami i zdarzeniami niewerbalnymi, takimi jak śmiech i pauzy. Obsługuje też słownictwo branżowe — od terminów medycznych po żargon finansowy.
- Przewidywanie końca tury: Ten system decyduje, kiedy mówić, zrobić pauzę lub czekać, odczytując przebieg rozmowy zamiast polegać na sztywnym progu ciszy. Ulepszenia naszego modelu wykrywania aktywności głosowej pomagają mu lepiej filtrować mowę w tle i krótkie odpowiedzi, dzięki czemu zmiana tur brzmi bardziej naturalnie.
- Eleven v3 Conversational: Nasz najbardziej ekspresyjny model TTS, stworzony do dialogu na żywo. Przenosi emocjonalny ton rozmowy między turami, więc sposób mówienia agenta w 10. turze uwzględnia wszystko, co było wcześniej, a nie tylko ostatnią odpowiedź.
- Expressive Mode: Zbudowany na Eleven v3 Conversational i systemie zmiany tur, Expressive Mode kontroluje, jak agent brzmi w danej chwili — łagodzi sytuację, gdy klienci są sfrustrowani, uspokaja ich, gdy są zdezorientowani, i mówi wprost, gdy potrzebna jest jasność. Odczytuje też tagi ekspresji, więc model może reagować na wskazówki takie jak [laughs], [whispers] czy [sighs], aby kształtować sposób mówienia w konkretnych momentach.
- Flash v2.5: Nasz model TTS o niskich opóźnieniach obsługuje 32 języki i generuje mowę w mniej niż 75 ms. Gdy priorytetem są opóźnienia, utrzymuje czas odpowiedzi w zakresie naturalnego ludzkiego rytmu.
- Speech Engine: Warstwa łącząca cały system, która łączy twój serwer z naszym ElevenAPI przez WebSocket — jedno połączenie na rozmowę. My obsługujemy STT i TTS, a twój serwer uruchamia LLM, więc zespoły techniczne mogą używać własnego modelu i zachować logikę rozmowy we własnej infrastrukturze.
Te modele są stale ulepszane, a nowe wersje wydajemy regularnie. Każda kolejna zmniejsza różnicę między rozmową z oprogramowaniem a rozmową z człowiekiem — dzięki szybszym odpowiedziom, lepszemu rozpoznawaniu emocji, większej liczbie języków i płynniejszemu sposobowi mówienia.
Mówienie podczas myślenia
Nie każda część modelu interakcji musi działać w ścisłej kolejności. ElevenAgents może dalej pracować w tle podczas rozmowy, zamiast domyślnie milczeć między pytaniem a odpowiedzią.
Kilka kluczowych systemów współpracuje, by umożliwić jednoczesne mówienie i myślenie:
- Równoległe wywołania narzędzi: Agent może przeszukać bazę danych, uruchomić narzędzie lub sprawdzić status zamówienia, gdy wciąż mówi, więc pobieranie informacji nigdy nie przypomina martwej pauzy w rozmowie.
- Miękki limit czasu: Jeśli LLM potrzebuje więcej czasu niż oczekiwano na wygenerowanie odpowiedzi, agent wypowiada krótkie wypełnienie, takie jak „Niech pomyślę” lub „hmmm”, zamiast zostawiać niezręczną ciszę. Miękki limit czasu pomaga utrzymać naturalny tok rozmowy i zmniejsza prawdopodobieństwo przerwań.
- Wyrazy ignorowane przy przerwaniu: Zamiast używać stałego progu ciszy, system stara się rozumieć znaczenie tego, co jest mówione, aby wyczuć, kiedy tura naprawdę się skończyła. Podobnie krótkie potwierdzenia, takie jak „okej” lub „mhm”, można skonfigurować tak, by przechodziły bez wywoływania pełnego przerwania, dzięki czemu agent nie gubi wątku za każdym razem, gdy rozmówca się wtrąca.
Razem systemy te sprawiają, że agent nie brzmi, jakby buforował lub ładował odpowiedź. Tworzą sprawny silnik rozmowy, który naturalnie wypełnia przerwy tak jak człowiek, a jednocześnie przetwarza informacje i zbiera myśli w tle.
Jak naprawdę działa rozmowa z ElevenLabs
Powyższe komponenty nie działają po kolei, w uporządkowanej linii. Nakładają się na siebie. Oto jak agent ElevenLabs obsłużyłby rozmówcę, który w trakcie rozmowy z pomocą techniczną pyta: „Czy moje zamówienie zostało już wysłane, czy nadal jest przetwarzane?”
- Rozmówca mówi: Audio jest przesyłane do ElevenLabs przez połączenie WebSocket, a Scribe zaczyna transkrypcję w czasie rzeczywistym, z opóźnieniem około 150 ms względem głosu.
- System odczytuje przebieg: Gdy Scribe wciąż transkrybuje, system przewidywania końca tury już ocenia, czy rozmówca skończył, czy jest w trakcie myśli. Końcowe „czy nadal jest przetwarzane?” jest odczytywane jako przekazanie głosu, a nie pauza, więc uruchamia kolejny krok zamiast czekać w ciszy.
- LLM zbiera kontekst i odpowiada: Transkrybowane pytanie trafia do LLM razem z historią rozmowy, danymi zamówienia pobranymi z własnych systemów firmy przez RAG, wynikami narzędzi użytych wcześniej w rozmowie oraz promptem systemowym. LLM analizuje całość i tworzy odpowiedź opartą na faktycznym zamówieniu rozmówcy, a nie ogólny komunikat o statusie.
- Eleven v3 syntezuje odpowiedź: Tekst zamienia się w naturalnie brzmiące audio. Jeśli Expressive Mode jest aktywny, odpowiedź zawiera wskazówki dotyczące sposobu mówienia, które pasują do sytuacji, więc rutynowa aktualizacja brzmi swobodnie i bez pośpiechu, a nie płasko. Gdy priorytetem są opóźnienia, Flash wykonuje syntezę w mniej niż 75 ms.
- Odpowiedź wraca strumieniowo: Audio zaczyna być odtwarzane przed zakończeniem syntezy, więc rozmówca słyszy początek odpowiedzi, gdy reszta jest jeszcze generowana.
- Cykl się powtarza: Każda nowa tura przenosi dalej ton, kontekst i historię rozmowy.
W tym szybkim procesie rozmowa brzmi naturalnie. Rozmówca przestaje dostosowywać się do maszyny: nie zwalnia, nie wymawia słów przesadnie wyraźnie ani nie czeka na sygnał. Po prostu mówi, tak jak z człowiekiem.
Wdrażaj naturalnie brzmiących agentów głosowych w całej firmie
Wszystko, co opisaliśmy, działa już dziś w produkcji, a nie jest jedynie planem. Od architektury kaskadowej po pipeline działający w czasie poniżej sekundy — firmy na całym świecie już używają ElevenAgents do obsługi prawdziwych rozmów z klientami na dużą skalę.
Dotyczy to także regulowanych środowisk o wysokiej stawce, ponieważ architektura naszych agentów obsługuje zabezpieczenia, dzienniki audytowe i mechanizmy kontroli zgodności. ElevenLabs ma certyfikaty SOC 2 Type II, ISO 27001, HIPAA i PCI DSS Level 1, a także Zero Retention Mode i regionalną rezydencję danych dla zespołów, które muszą przechowywać dane w określonych granicach.
Chcesz wdrożyć agenta? Możesz utworzyć agenta i zacząć budować w konsoli albo porozmawiać z naszym zespołem sprzedaży o wdrożeniu dopasowanym do twojego środowiska.