

API Text to Speech
Ultrarealistyczna synteza mowy z niskimi opóźnieniami
Twórz z wysokiej jakości, kontrolowanym TTS dla aplikacji czasu rzeczywistego i generowania na dużą skalę. Modele zoptymalizowane pod kątem opóźnień, jakości i spójności długich treści.
- Lovable
- Synthesia
- Stripe
- Perplexity
- Twilio
Oparte na najpotężniejszych modelach Voice AI
Wybierz model do swojego zastosowania: od agentów z ultraniskimi opóźnieniami po ekspresyjną narrację długich treści.

Eleven v4
Nasz najbardziej emocjonalny model o najwyższej jakości.
- Wyjątkowe możliwości Voice Cloning
- Obsługa ponad 90 języków
- Limit 10 000 znaków
- Dialogi wielu rozmówców
- ~0,08 USD za minutę

Eleven v4 Turbo
Nasz najbardziej ekspresyjny model do mowy w czasie rzeczywistym.
- Bardzo niskie opóźnienie (~100 ms)
- Wyjątkowe możliwości Voice Cloning
- Obsługa ponad 90 języków
- Tagi audio do precyzyjnej kontroli
- ~0,04 USD za minutę
Wszystko, czego potrzebujesz, by tworzyć gotową do użycia mowę
Generuj ekspresyjną, kontrolowaną mowę z modelami stworzonymi do działania w czasie rzeczywistym, długich treści i wdrożeń produkcyjnych.
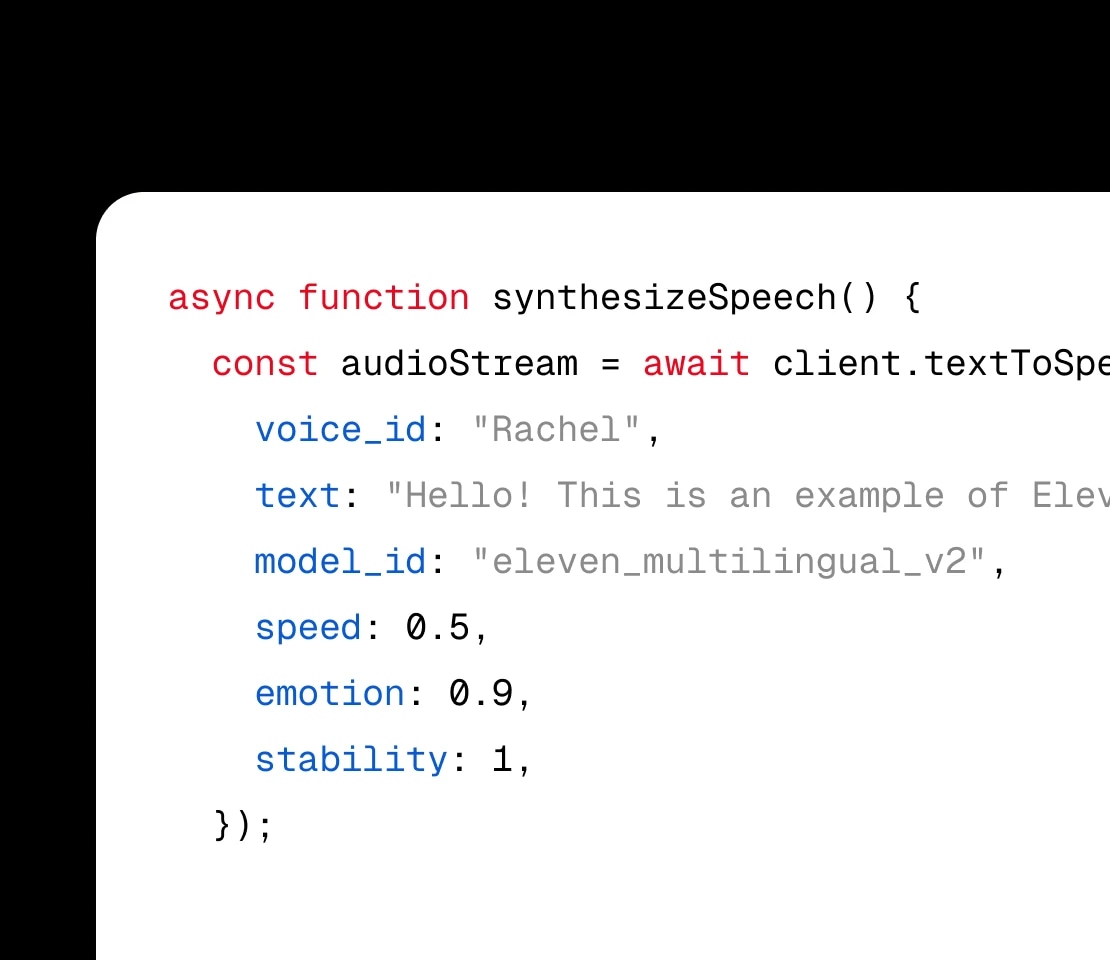
Kontroluj emocje i sposób wypowiedzi
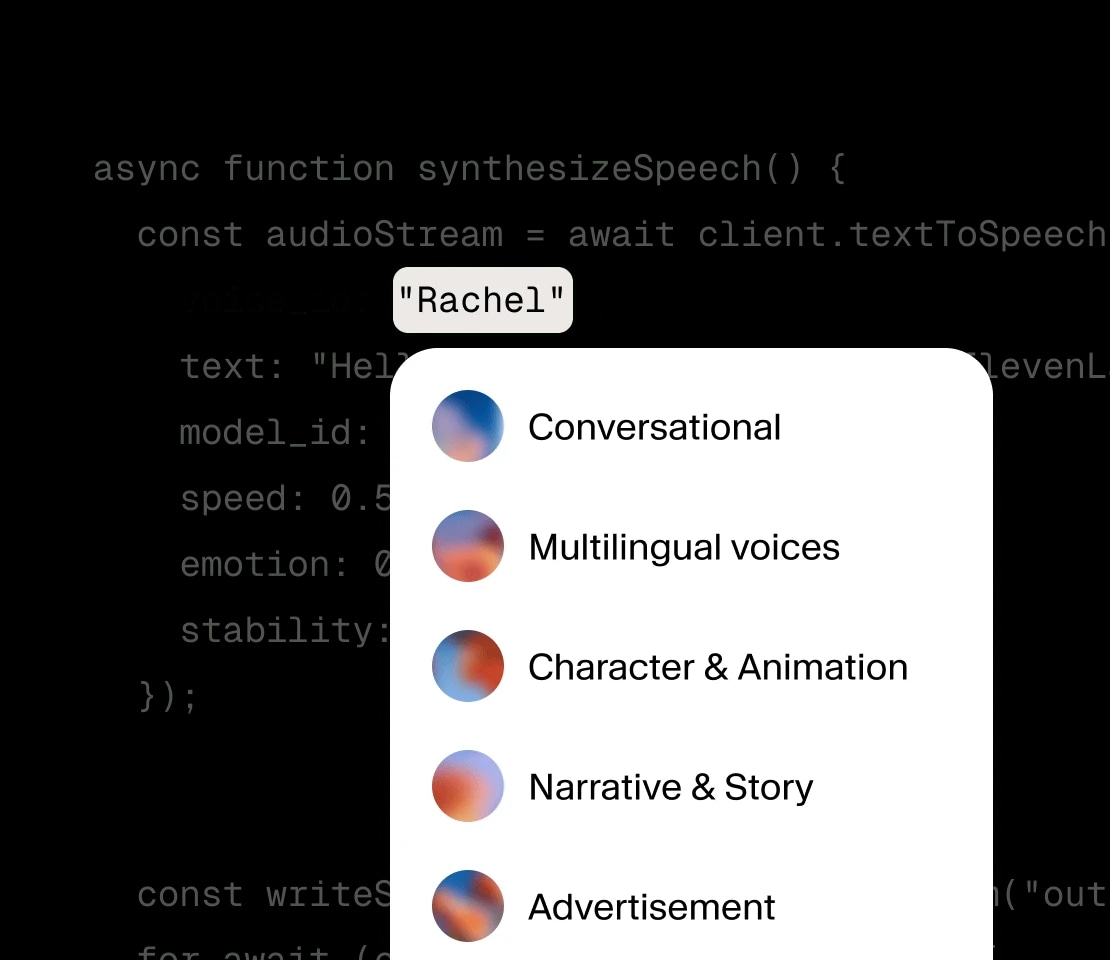
Dostęp do ponad 11 000 głosów
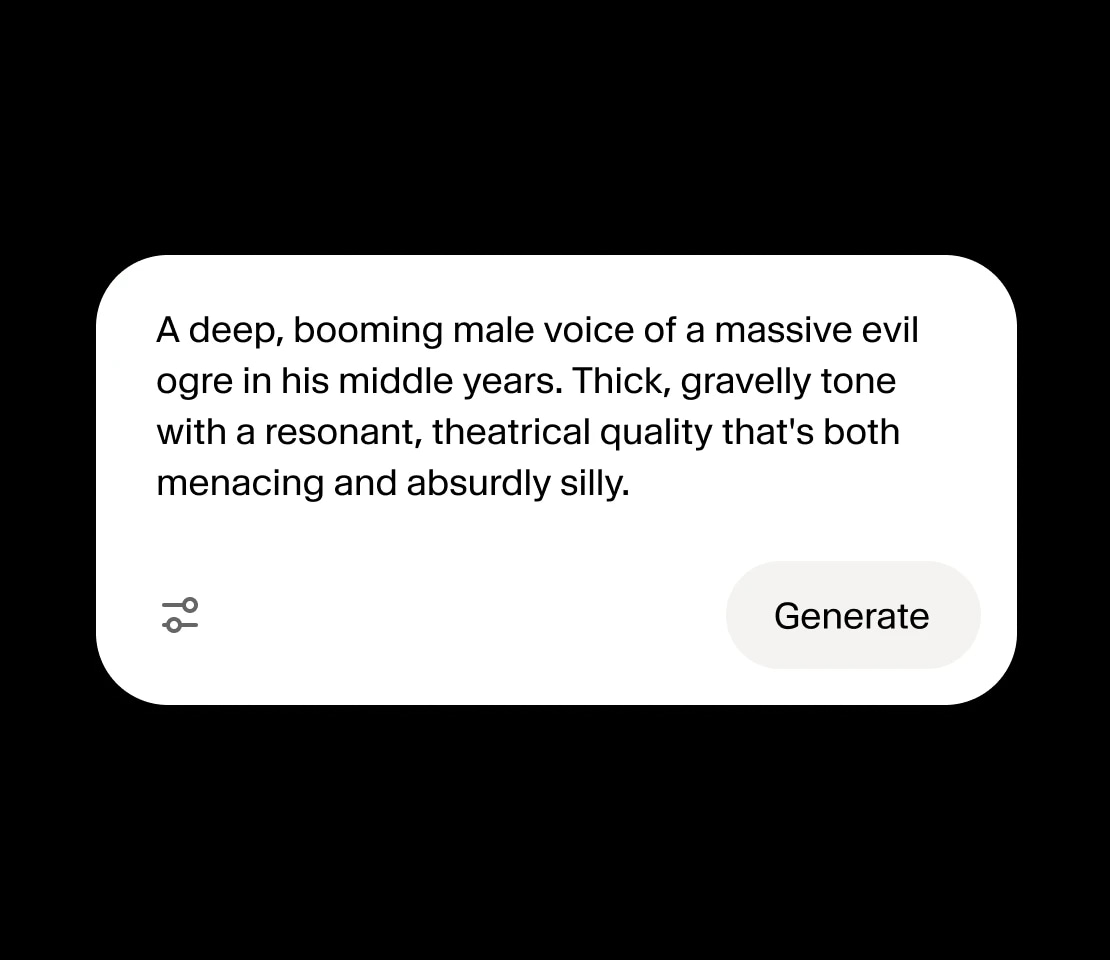
Voice Design i klonowanie
Dialogi wielu rozmówców
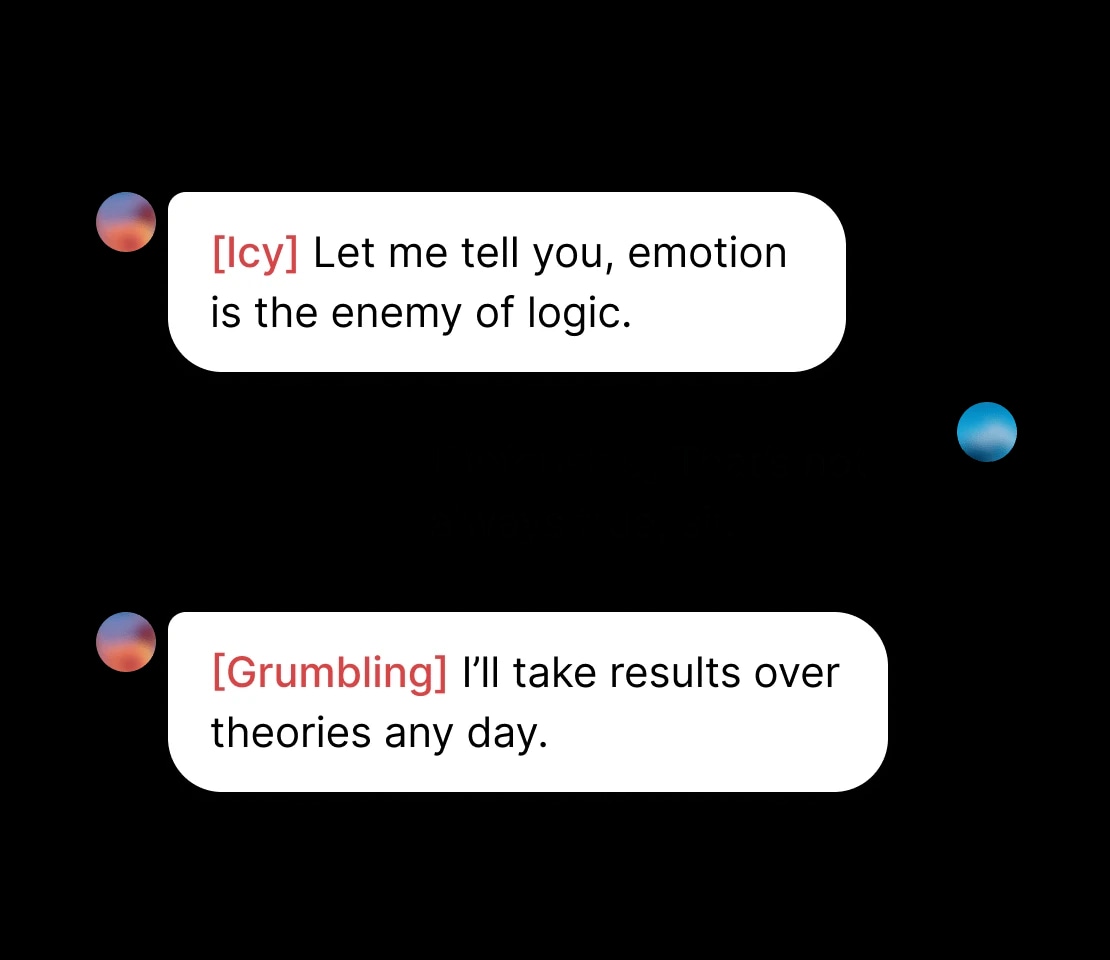
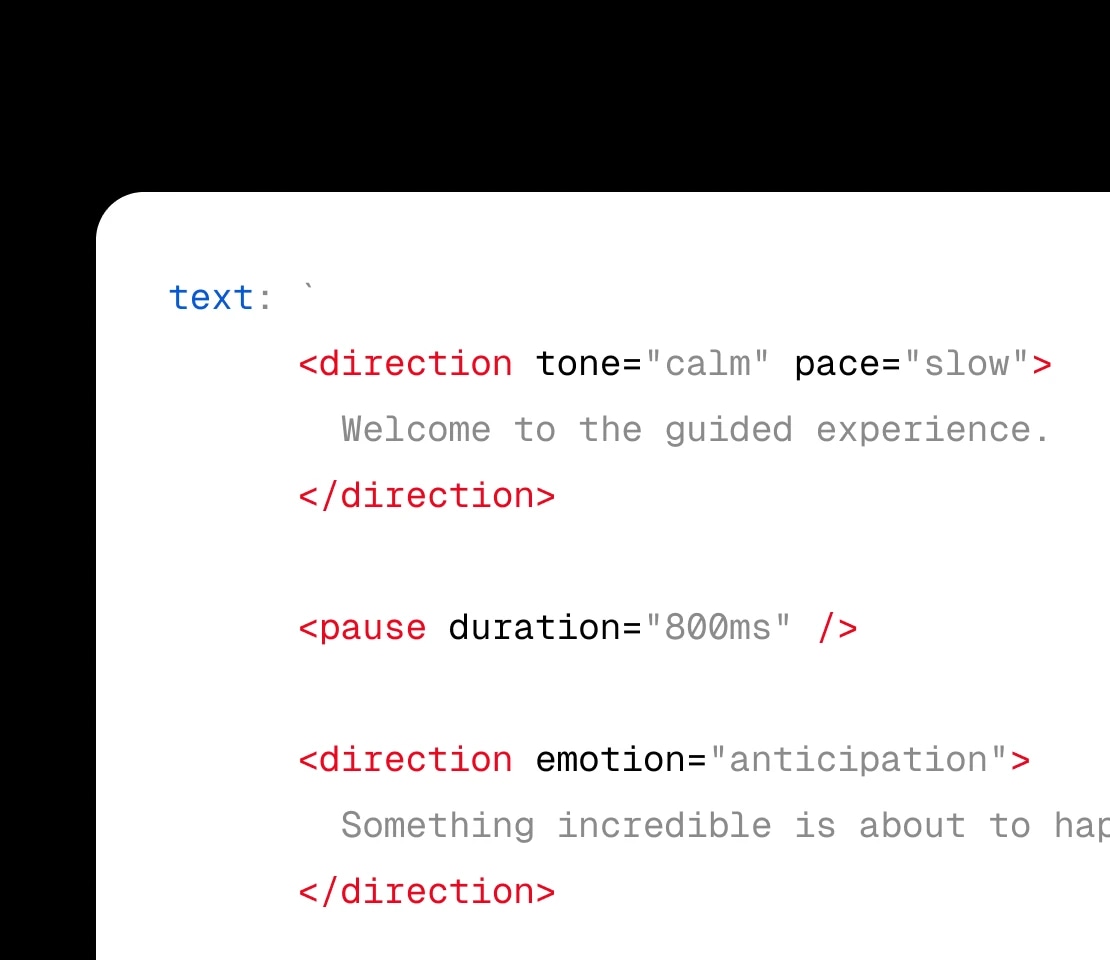
Zdarzenia audio i reżyseria
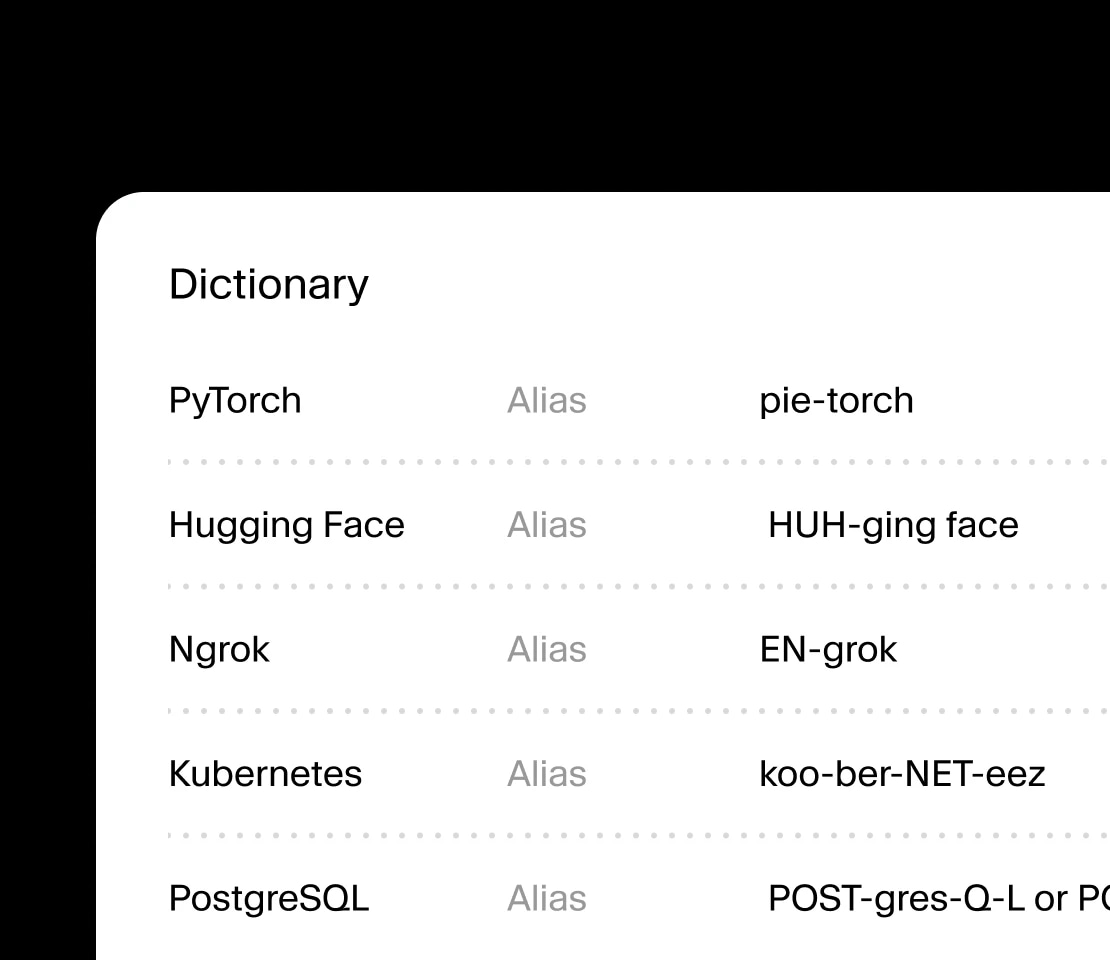
Słowniki wymowy
Napędzamy wiodące firmy i marki na świecie
“Od dubbingu rolek Reels w lokalnych językach po generowanie muzyki i głosów postaci w Horizon — platforma ElevenLabs pozwala twórcom, firmom i organizacjom na całym świecie tworzyć na dużą skalę z użyciem głosu, muzyki i dźwięku.”

“Miliony osób każdego dnia uczą się szachów od twórców takich jak Hikaru, Levy i Magnus na YouTube oraz Twitchu. Teraz mogą uczyć się od nich w Chess.com w sposób wciągający, osobisty i pełen charakteru. Naszą misją jest stworzenie trenera szachowego, który uczy na odpowiednim poziomie, wita graczy o każdym poziomie umiejętności i wyjaśnia szachy, zachowując przy tym zabawę i osobowość. Dzięki ElevenLabs i tym niesamowitym nowym głosom zrobiliśmy duży krok, by urzeczywistnić tę wizję.”

“ElevenLabs ułatwiło nam szybkie dodanie zaawansowanej zamiany tekstu na mowę do naszego SDK, dzięki czemu Agenci mogą odpowiadać w czasie rzeczywistym ekspresyjnymi głosami na pytania użytkowników lub przekazywać informacje o tym, co widzą.”

“Twilio zintegrowało generatywną technologię głosową AI ElevenLabs ze swoją platformą CPaaS, usprawniając ConversationRelay. Integracja pozwala firmom i deweloperom tworzyć konwersacyjne interakcje głosowe AI, które brzmią po ludzku, są ekspresyjne i odpowiadają w czasie rzeczywistym bezpośrednio z platformy Twilio CPaaS. W ElevenLabs cieszymy się, że Twilio wybrało ElevenLabs, aby wzbogacić ConversationRelay o najbardziej ekspresyjne, naturalnie brzmiące dostępne głosy. ”

API gotowe do produkcji

Dane są szyfrowane podczas przesyłania i przechowywania, z obsługą zgodności z SOC 2, HIPAA i RODO. Tryby EU Data Residency i Zero Retention zapewniają większą kontrolę nad danymi.
Dane są szyfrowane podczas przesyłania i przechowywania, z obsługą zgodności z SOC 2, HIPAA i RODO. Tryby EU Data Residency i Zero Retention zapewniają większą kontrolę nad danymi.
Oficjalne SDK dla Pythona i TypeScript z bezpieczeństwem typów, obsługą streamingu i jasnymi przykładami.
Nasz zespół zadba o płynne wdrożenie i niezawodne działanie, zapewniając stałą wydajność i spokój.
