Czym jest okno kontekstowe? Co powinien wiedzieć każdy użytkownik LLM
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Okno kontekstowe to ilość informacji, którą duży model językowy (LLM) może przetworzyć w jednym żądaniu. Mierzy się je tokenami i może obejmować prompt, historię rozmowy, instrukcje systemowe, pobrane dokumenty, wyniki narzędzi oraz odpowiedź wygenerowaną przez model.
Większe okno kontekstowe pozwala modelowi pracować z większą ilością informacji w jednym żądaniu. Na przykład agent programistyczny badający błąd może jednocześnie korzystać z odpowiednich plików źródłowych, dokumentacji, wyników testów i ostatnich zmian w kodzie, zamiast analizować każdy element osobno i tracić przydatny kontekst między żądaniami.
Większe okno kontekstowe nie oznacza jednak doskonałej pamięci. Dłuższe prompty wymagają więcej obliczeń, zużywają więcej tokenów i mogą utrudniać modelowi rozpoznanie, które szczegóły naprawdę mają znaczenie. Badania modeli z długim kontekstem, w tym Zagubieni pośrodku oraz benchmark NVIDIA RULER, wielokrotnie wykazały, że wraz ze wzrostem kontekstu modele wykorzystują mniej dostępnych informacji, zwłaszcza gdy istotne dane są ukryte pośród mniej przydatnych treści.
Wyjaśniamy, jak działają okna kontekstowe, jak się je mierzy, co dzieje się po ich zapełnieniu i jak deweloperzy mogą nimi skutecznie zarządzać.

Podsumowanie
- Okno kontekstowe to łączny budżet tokenów, z którego LLM korzysta w jednym żądaniu. Obejmuje prompt użytkownika, historię rozmowy, pobrane treści i dane wyjściowe.
- Większe okna kontekstowe pozwalają obsługiwać dłuższe dokumenty, bazy kodu i rozmowy, ale nie gwarantują, że model dobrze wykorzysta każdą ich część.
- Modele najmniej niezawodnie wyszukują informacje ze środka długich promptów — zjawisko opisane w badaniu Lost in the Middle i benchmarku RULER.
- Skuteczne zarządzanie kontekstem (wyszukiwanie, podsumowywanie, cache'owanie) zwykle daje lepsze efekty niż maksymalizowanie liczby wysyłanych tokenów.
- Najlepsza strategia kontekstu pasuje do rzeczywistego obciążenia, a nie korzysta z największego reklamowanego okna kontekstowego.
Czym jest okno kontekstowe w modelu AI?
Okno kontekstowe to aktywna przestrzeń robocza modelu, w której przed wygenerowaniem odpowiedzi zbierają się wszystkie informacje istotne dla bieżącego żądania.
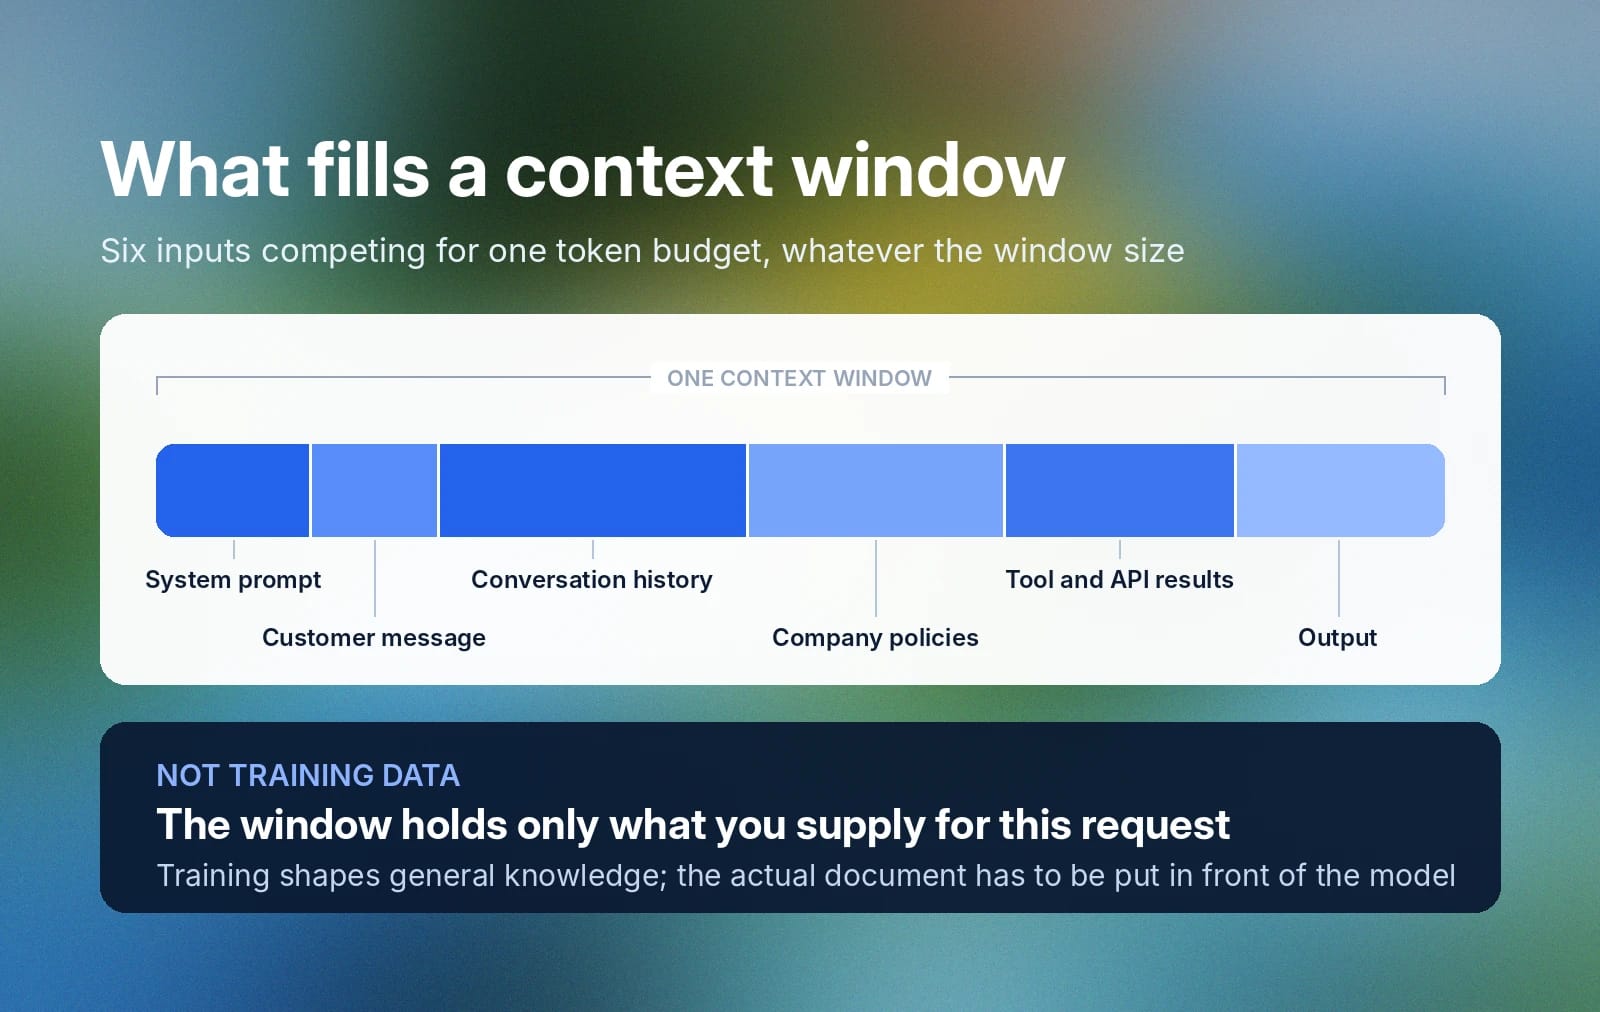
Weźmy agenta AI, który podsumowuje rozmowę z działem obsługi klienta i proponuje rozwiązanie. Aby zrobić to dobrze, model musi przetworzyć:
- prompt systemowy
- Wiadomość klienta
- Historię rozmowy
- Zasady firmy
- Wyniki narzędzi i API
- Dane wyjściowe
Wszystko to konkuruje o miejsce w tym samym oknie kontekstowym, niezależnie od jego rozmiaru.
Okna kontekstowe nie obejmują danych treningowych. Trening na stałe zapisuje informacje w parametrach modelu, kształtując jego ogólną „wiedzę”. Okno kontekstowe zawiera natomiast wyłącznie informacje dostarczone do bieżącego zadania.
To rozróżnienie ma znaczenie w praktyce: jeśli aplikacja potrzebuje, by model przeanalizował konkretną zasadę, dane klienta lub dokument techniczny, informacja ta nie jest dostępna tylko dlatego, że model trenowano na podobnych materiałach. Zwykle musi trafić bezpośrednio do kontekstu roboczego modelu — w prompcie albo przez system wyszukiwania czy narzędzia. W przeciwnym razie model będzie wnioskować na podstawie wiedzy ogólnej, a nie dokumentu, który ma przed sobą.
Tokenizacja i okna kontekstowe: jak przetwarzane są dane
Zanim LLM przetworzy tekst, tokenizator dzieli go na mniejsze jednostki zwane tokenami. Token może oznaczać całe słowo, część słowa, znak interpunkcyjny lub inny krótki fragment tekstu.
W języku angielskim przydatna zasada mówi, że jeden token to około cztery znaki lub mniej więcej trzy czwarte słowa. Według tego szacunku 100 tokenów odpowiada około 75 słowom. To jednak tylko przybliżenie. Weźmy zdanie „Okna kontekstowe wpływają na wydajność aplikacji”. Tokenizator nie musi traktować go jako pięciu pełnych słów — zależnie od tokenizatora jedno lub więcej słów może zostać podzielone na kilka tokenów podrzędnych.
Tokenizacja znacznie różni się też między językami. Dwa zdania o podobnym znaczeniu i długości mogą zużywać bardzo różną liczbę tokenów, zależnie od języka i tokenizatora. Badania nad sprawiedliwością tokenizatorów wykazały, że w przypadku niektórych par językowych długość tokenizowanego równoważnego tekstu może różnić się nawet 15-krotnie — także w tokenizatorach obsługujących wiele języków. Deweloperzy tworzący aplikacje wielojęzyczne powinni mierzyć użycie tokenów rzeczywistym tokenizatorem danego modelu, zamiast szacować je na podstawie liczby słów.
Okno kontekstowe o wielkości 200 000 tokenów może brzmieć imponująco, ale aplikacja, która stale dodaje historię rozmowy, pobraną dokumentację, odpowiedzi narzędzi i instrukcje systemowe, może osiągnąć ten limit szybciej, niż się wydaje. Dlatego aplikacje produkcyjne często monitorują użycie tokenów i stosują podsumowywanie, przycinanie historii, filtrowanie wyników wyszukiwania oraz kompresję promptów, aby najistotniejsze informacje mieściły się w aktywnym kontekście.
Jak działa okno kontekstowe w modelach językowych?
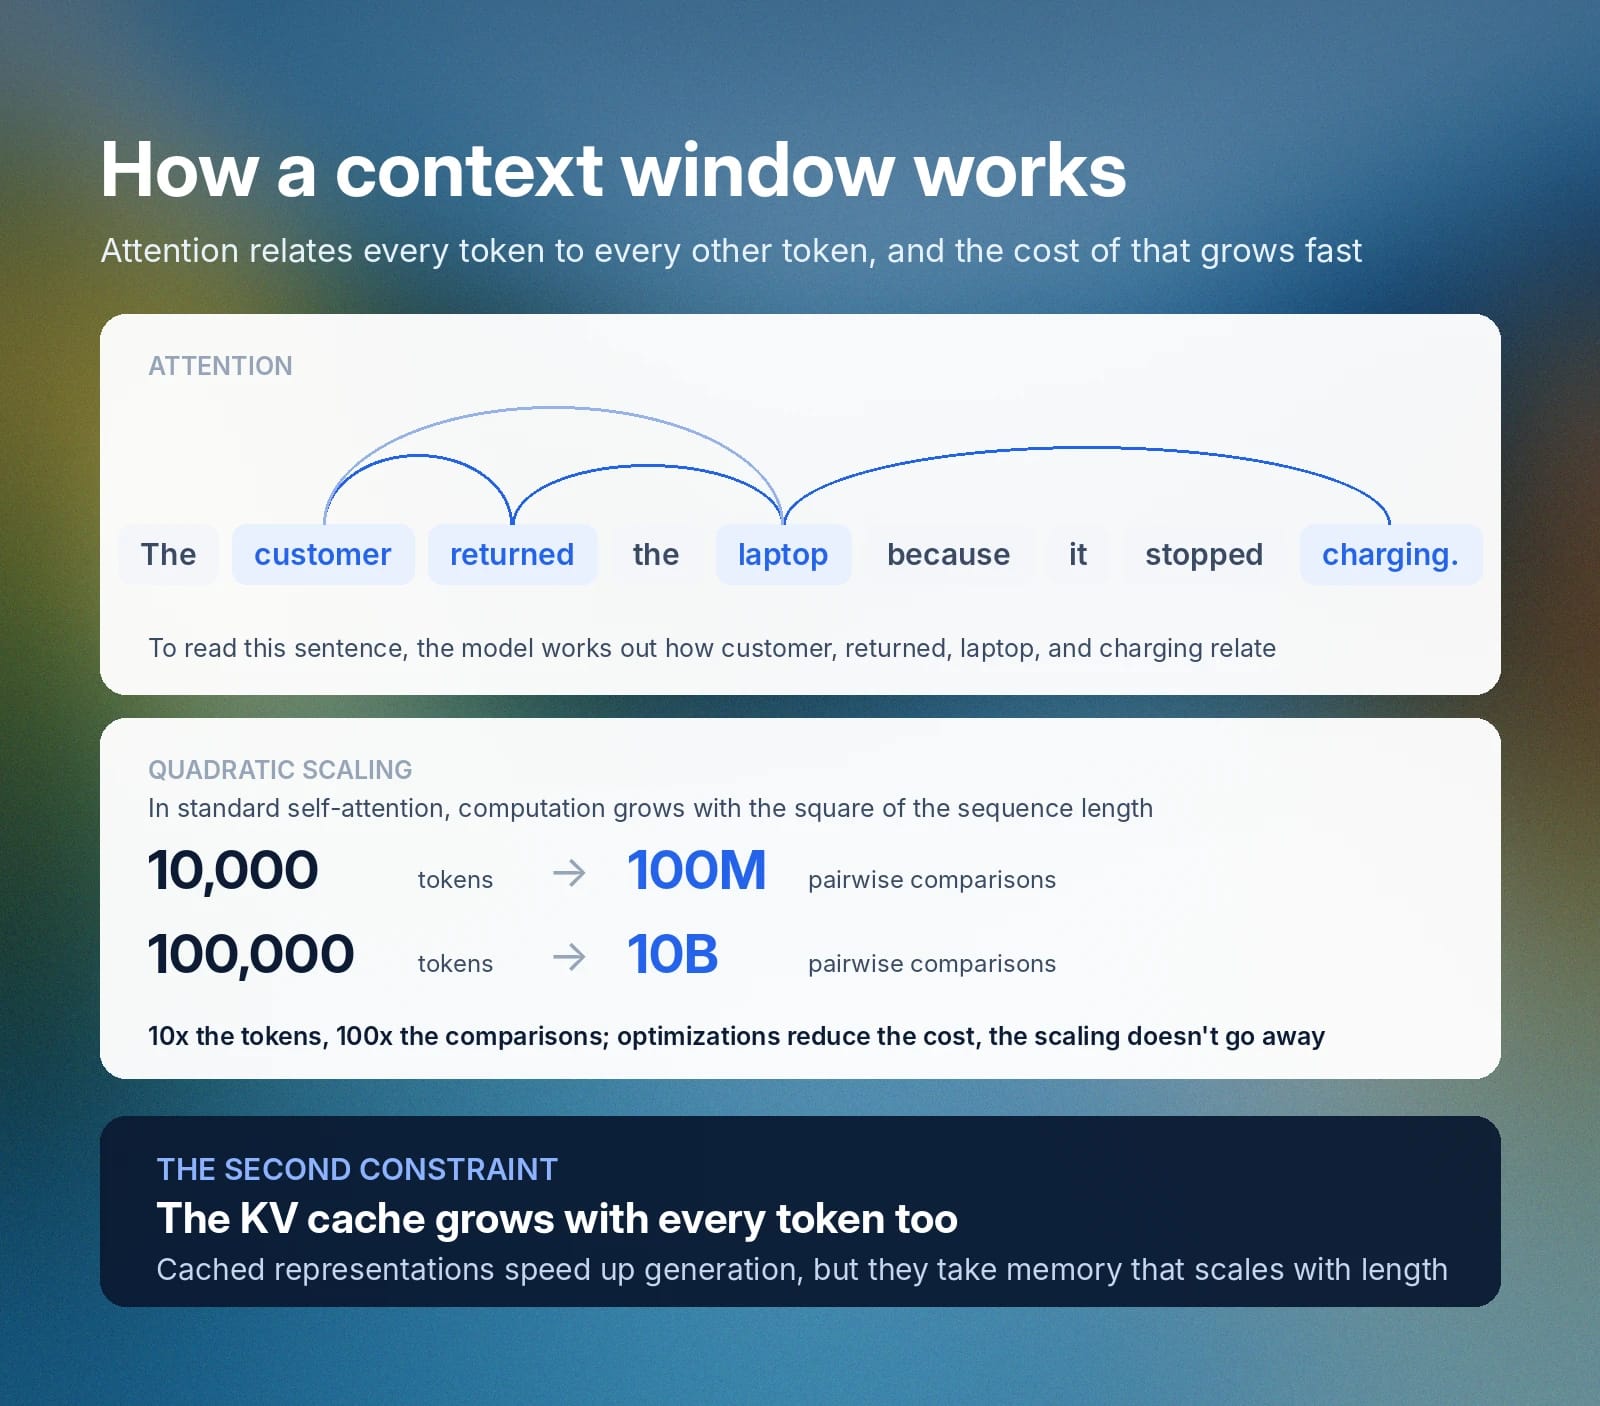
Okno kontekstowe działa dzięki mechanizmowi uwagi w architekturze transformera, który przed wygenerowaniem odpowiedzi oblicza relacje każdego tokenu wejściowego ze wszystkimi pozostałymi tokenami.
Weźmy zdanie „Klient zwrócił laptopa, ponieważ przestał się ładować”. Aby poprawnie je zinterpretować, model musi ustalić, jak klient, laptop, zwrócił i ładować odnoszą się do siebie. Wraz z wydłużaniem sekwencji liczba tych relacji szybko rośnie.
W standardowym mechanizmie self-attention wymagane obliczenia rosną mniej więcej z kwadratem długości sekwencji. Na przykład prompt z 10 000 tokenów wymaga około 100 milionów porównań par, a prompt z 100 000 tokenów — około 10 miliardów. Nowoczesne modele stosują różne optymalizacje architektury i infrastruktury, by w praktyce obniżyć ten koszt, ale podstawowy problem skalowania nie znika.
Długie rozmowy wiążą się z drugim ograniczeniem: cache'em klucz-wartość, czyli KV cache. Podczas generowania modele zachowują pośrednie reprezentacje wcześniejszych tokenów, zamiast obliczać je ponownie dla każdego nowego tokenu, co znacznie przyspiesza inferencję. Sam cache zajmuje jednak pamięć i rośnie wraz z długością sekwencji.
Maksymalna długość kontekstu w modelach AI i dlaczego ma znaczenie
Maksymalna długość kontekstu modelu określa, ile informacji może on przyjąć i przetworzyć w jednym żądaniu. Osobną kwestią jest jednak to, czy model skutecznie wykorzystuje duże okno kontekstowe.
Dłuższe okna kontekstowe umożliwiają zastosowania, które były trudne lub niepraktyczne we wcześniejszych LLM-ach. Deweloperzy mogą przekazać modelowi całe repozytorium kodu, długi dokument prawny, pracę badawczą, transkrypcję spotkania lub rozbudowaną historię rozmowy bez wcześniejszego skracania materiału do kilku tysięcy tokenów.
To ważne, ponieważ zachowanie większej części oryginalnego kontekstu może poprawić zdolność modelu do trafnego odpowiadania na pytania, wykrywania relacji między odległymi fragmentami informacji i wykonywania zadań zależnych od całego dokumentu. Na przykład asystent programistyczny może potrzebować przejrzeć kilka plików, by zrozumieć, jak wywoływana jest funkcja, a asystent do dokumentów prawnych — porównać definicje z jednej sekcji z obowiązkami opisanymi znacznie dalej w dokumencie.
Większe okno kontekstowe nie zapewnia jednak automatycznie lepszych wyników. Bardzo długie dane wejściowe mogą zwiększać koszt i opóźnienia, a modele mogą poświęcać mniej uwagi informacjom ukrytym w środku dużego kontekstu. Deweloperzy powinni więc selektywnie uwzględniać istotne informacje, przejrzyście organizować długie dane wejściowe i w razie potrzeby stosować wyszukiwanie, podsumowywanie oraz przycinanie kontekstu.
Porównanie rozmiarów okien kontekstowych według modelu
Okna kontekstowe w głównych obecnie rodzinach modeli znacznie się różnią — od kilkuset tysięcy do 10 milionów tokenów. Tak wypadają obecne modele flagowe:
Model | Okno kontekstowe | Uwagi |
10 milionów tokenów | Model Meta z otwartymi wagami; największe publicznie dostępne okno w chwili pisania | |
1,05 miliona tokenów | Obecny flagowy model OpenAI do programowania i rozumowania agentowego | |
1 milion tokenów | Obecny model Google w klasie Pro do analizy długich dokumentów i wielu plików | |
1 milion tokenów | Obecny model Anthropic w klasie Sonnet; okno domyślnie obowiązuje w całym Claude API |
Reklamowane limity szybko się zmieniają, gdy dostawcy wydają nowe modele i podnoszą limity, dlatego taką tabelę traktuj jak migawkę, a nie stały ranking. Rozmiar kontekstu to też tylko jeden z czynników wyboru modelu. Sam w sobie nie mówi nic o jakości rozumowania, limitach odpowiedzi, opóźnieniach ani kosztach.
Małe a duże okno kontekstowe — konsekwencje
Małe okno kontekstowe zmusza deweloperów do selekcji. Długie dokumenty dzieli się na fragmenty, starszą historię rozmowy podsumowuje, a wiedzę zewnętrzną pobiera tylko wtedy, gdy jest naprawdę potrzebna.
Duże okno kontekstowe usuwa część tych ograniczeń. Możesz dostarczyć więcej przykładów, zachować więcej historii rozmowy lub przeanalizować większy zbiór dokumentów bez uprzedniego dzielenia wszystkiego na części.
Większe okno wprowadza jednak inny problem: rozproszenie uwagi. Gdy prompt zawiera dużą ilość informacji, model może mieć trudność z rozpoznaniem szczegółów najbardziej istotnych dla bieżącego żądania. Ważne instrukcje lub dowody mogą zaginąć pośród mniej istotnych treści, zwiększając ryzyko niepełnych, niespójnych lub mniej precyzyjnych odpowiedzi.
Dlaczego modele gubią się w środku
Modele zwykle najlepiej wyszukują informacje znajdujące się na początku lub końcu długiego promptu, a najgorzej te ukryte w środku. Wpływowe badanie Zagubieni pośrodku sprawdziło to bezpośrednio, umieszczając odpowiedź na pytanie w różnych miejscach długiego promptu i mierząc, jak często modele ją odnajdywały. Trafność była stale najwyższa na początku i końcu kontekstu, a najniższa w środku.
Oznacza to, że model może technicznie przyjąć dokument, nie wykorzystując niezawodnie każdej jego części. Wyślij LLM-owi 100 dokumentów pomocy, ponieważ jeden z nich zawiera odpowiedź na pytanie klienta, a większe okno kontekstowe może pomieścić wszystkie 100. Model nadal musi jednak wybrać jeden istotny fragment spośród 99 nieistotnych, a dłuższe okno nie gwarantuje, że to zrobi.
Warto więc odróżniać reklamowane okno kontekstowe modelu od jego efektywnego okna kontekstowego dla danego obciążenia. Benchmarki takie jak RULER i LongBench próbują mierzyć tę różnicę. RULER wykazał, że modele osiągające niemal perfekcyjne wyniki w prostych testach wyszukiwania nadal traciły skuteczność wraz ze wzrostem długości kontekstu i złożoności zadania. LongBench ocenia szerszy zakres zadań, w tym odpowiadanie na pytania o dokumenty, rozumowanie na wielu dokumentach, podsumowywanie, few-shot learning i uzupełnianie kodu.
Długi kontekst nadal wnosi realną wartość. Pojemność i rozumienie to po prostu różne właściwości, a obie mają znaczenie przy wyborze modelu do danego zadania.

Zarządzanie limitami kontekstu: dobre praktyki dla deweloperów
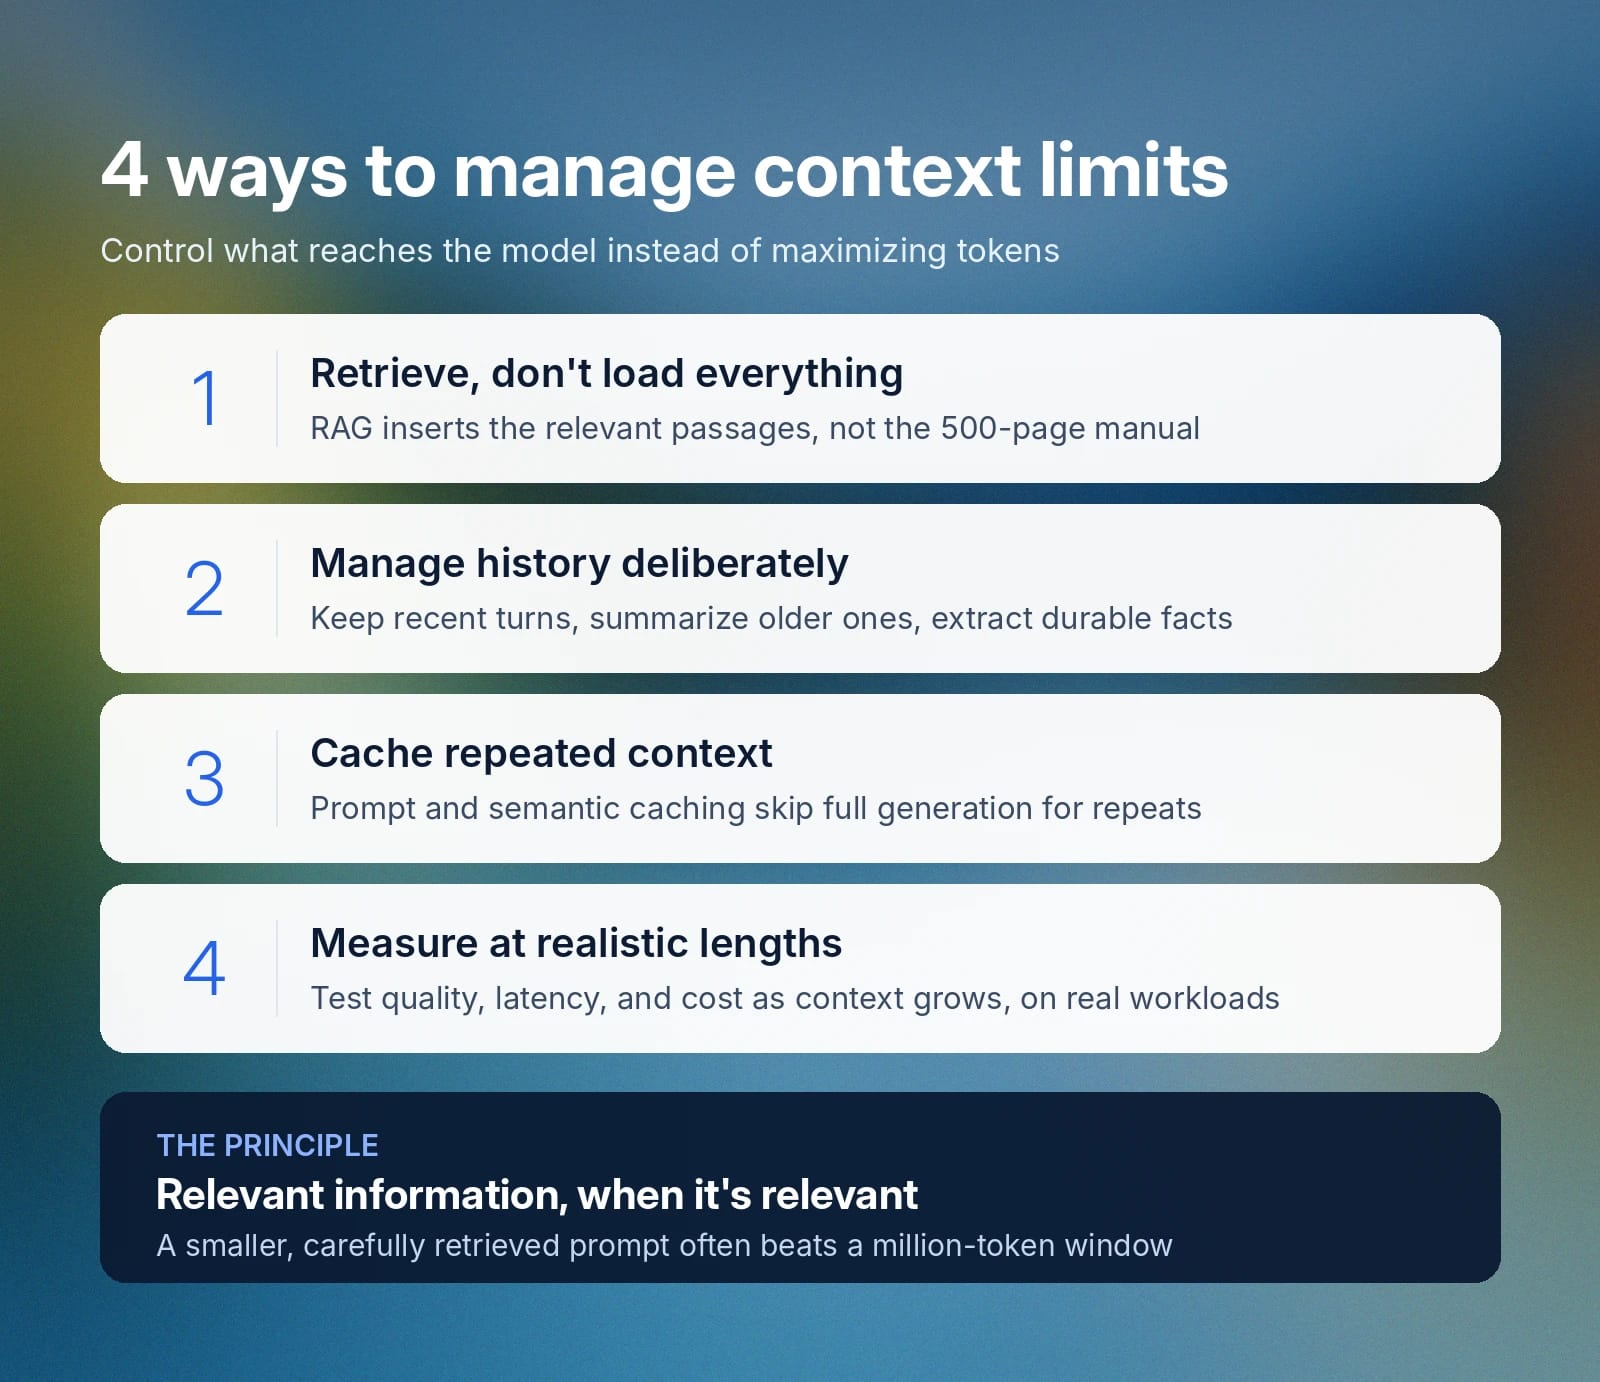
Dobre zarządzanie kontekstem oznacza kontrolowanie tego, co trafia do modelu: dostarczanie informacji istotnych dla zadania wtedy, gdy są potrzebne, zamiast prób maksymalizacji liczby tokenów w każdym żądaniu. Poniższe praktyki mogą pomóc deweloperom ograniczyć zbędny kontekst, poprawić jakość odpowiedzi oraz kontrolować koszty i opóźnienia.
1. Pobieraj istotne informacje zamiast ładować wszystko
Retrieval-augmented generation, czyli RAG, pozwala aplikacji przeszukiwać zewnętrzną bazę wiedzy i umieszczać w kontekście modelu tylko istotne fragmenty. Zamiast dodawać do każdego żądania obsługi klienta cały 500-stronicowy podręcznik, aplikacja pobiera kilka fragmentów najbliższych rzeczywistemu pytaniu klienta.
Zmniejsza to użycie tokenów i daje modelowi znacznie wyraźniejszy sygnał, co jest ważne. Jakość wyszukiwania nadal ma znaczenie: produkcyjne systemy RAG zwykle poprawiają wyniki przez staranny podział dokumentów na fragmenty, pobieranie kilku kandydatów, zmianę ich rankingu i odfiltrowanie nieistotnych treści przed zbudowaniem końcowego promptu. ElevenLabs na przykład przebudowało pipeline RAG , dodając przepisanie zapytań i równoległe wywołania modeli, co skróciło medianę opóźnienia wyszukiwania o połowę.
2. Celowo zarządzaj historią rozmowy
Aplikacje konwersacyjne szybko gromadzą kontekst. Dodawanie w nieskończoność każdej wcześniejszej wiadomości marnuje tokeny i może wprowadzać nieistotne szczegóły do kolejnych tur.
Aplikacje radzą sobie z tym, zachowując najnowsze tury, podsumowując starsze wymiany, wyodrębniając trwałe fakty do pamięci strukturalnej i pobierając starsze szczegóły tylko wtedy, gdy znów stają się istotne. Tworzy to użyteczny podział na krótkoterminowy kontekst rozmowy, którego model potrzebuje od razu, oraz długoterminową pamięć aplikacji, którą można później ponownie wykorzystać.
3. Używaj cache'a, gdy kontekst się powtarza
Wiele aplikacji wielokrotnie wysyła te same rozbudowane instrukcje lub odpowiada na pytania semantycznie podobne do już obsłużonych. Cache ogranicza ten narzut.
Cache'owanie promptów lub kontekstu pozwala efektywniej wykorzystywać ponownie powtarzające się dane wejściowe, a cache'owanie semantyczne idzie o krok dalej, rozpoznając, kiedy nowe pytanie znaczy mniej więcej to samo, co pytanie, na które system już odpowiedział. „Jaka jest wasza polityka zwrotów?” i „Ile mam czasu na zwrot produktu?” to różne ciągi znaków, które cache semantyczny może uznać za to samo pytanie, pomijając pełne wywołanie generowania i ograniczając zarówno opóźnienia, jak i koszty tokenów.
4. Mierz wydajność przy realistycznej długości kontekstu
Nie wybieraj strategii kontekstu wyłącznie na podstawie reklamowanego przez dostawcę modelu limitu tokenów. Testuj reprezentatywne obciążenia produkcyjne i mierz jakość odpowiedzi, trafność wyszukiwania, opóźnienia, użycie tokenów, koszty oraz współczynniki błędów wraz ze wzrostem długości kontekstu.
Porównuj strategie, takie jak dostarczanie większej ilości kontekstu, pobieranie mniejszej liczby fragmentów, podsumowywanie historii rozmowy lub łączenie wyszukiwania z podsumowywaniem. Model z oknem kontekstowym miliona tokenów może technicznie obsługiwać twoją aplikację, podczas gdy mniejszy, starannie przygotowany prompt zapewni szybsze i trafniejsze wyniki przy niższym koszcie.
Zacznij korzystać z ElevenAgents, aby skalować rozwiązania językowe
Zarządzanie kontekstem ma największe znaczenie w agentach konwersacyjnych, które muszą łączyć bieżącą wypowiedź z poprzednimi turami, instrukcjami biznesowymi, informacjami o kliencie, treścią bazy wiedzy i wynikami narzędzi, a jednocześnie odpowiadać na tyle szybko, by rozmowa wydawała się naturalna.
ElevenAgents łączy te elementy na jednej platformie do tworzenia i wdrażania głosowych agentów AI. Jego silnik orkiestracji koordynuje rozpoznawanie mowy, LLM i Text to Speech, a deweloperzy konfigurują prompty, bazy wiedzy, narzędzia, workflow i bazowy model językowy. Ekspresyjna wypowiedź, w tym sposób, w jaki agent przekazuje emocjonalny kontekst w mowie, zależy od tego samego kontekstu, który od początku kształtuje to, co mówi agent.
W zakresie zarządzania wiedzą ElevenAgents obsługuje zarówno dokumenty z pełnym kontekstem, jak i RAG, konfigurowany bezpośrednio na platformie. Małe dokumenty trafiają bezpośrednio do promptu agenta, więc ich treść pozostaje dostępna przez całą rozmowę. Większe bazy wiedzy są za to indeksowane, a RAG pobiera istotne fragmenty dla każdego zapytania zamiast ładować wszystko naraz do okna kontekstowego.
Zacznij, rejestrując się w ElevenAgents już dziś lub porozmawiaj z naszym zespołem, aby poznać opcje wdrożenia.