Czym jest prozodia i jak kształtuje język mówiony?
- Autor
- Jack Limebear
- Opublikowano
- Ostatnia aktualizacja
PosłuchajPosłuchaj tego artykułu
Prozodia to rytm, akcent i intonacja mowy — wzorce, które nadają słowom znaczenie wykraczające poza ich dosłowne definicje. Wysokość głosu, tempo mówienia i sposób akcentowania słów wpływają na to, jak komunikujemy się językiem i jak go rozumiemy.
Dawniej używana wyłącznie do opisu ludzkiej mowy, prozodia staje się dziś równie istotna dla narzędzi głosowych AI, które ją generują. W dużej mierze decyduje o tym, czy AI brzmi po ludzku, ponieważ nie chodzi już tylko o dobór właściwych słów we właściwej kolejności, lecz także o drobne niuanse intonacji, które przekazują znaczenie. Jest to szczególnie ważne w obsłudze klienta czy narracji audio, gdzie źle wypowiedziane słowo może osłabić cały przekaz.
W tym artykule wyjaśniamy, czym jest prozodia, podajemy przykłady i omawiamy jej znaczenie w modelach Text to Speech (TTS), aby pokazać, co sprawia, że AI brzmi i wydaje się bardziej ludzkie.
Podsumowanie
- Prozodia podczas czytania odzwierciedla rozumienie tekstu przez czytelnika i pomaga rozwijać płynność.
- To prozodia pozwala modelom Text to Speech zamieniać zwykły tekst w naturalnie brzmiące, ludzkie audio.
- Prozodię można dodać do głosów AI za pomocą narzędzi takich jak wybór głosu, tagi audio i interpunkcja.
Czym jest prozodia?
Prozodia odnosi się do wzorców wysokości głosu, rytmu i akcentowania w mowie. Obejmuje to sposób, w jaki coś brzmi (np. fonemy), a także emocjonalny wydźwięk słów — na przykład to, czy wypowiadasz polecenie, pytanie lub stwierdzenie, albo czy jesteś sarkastyczny.
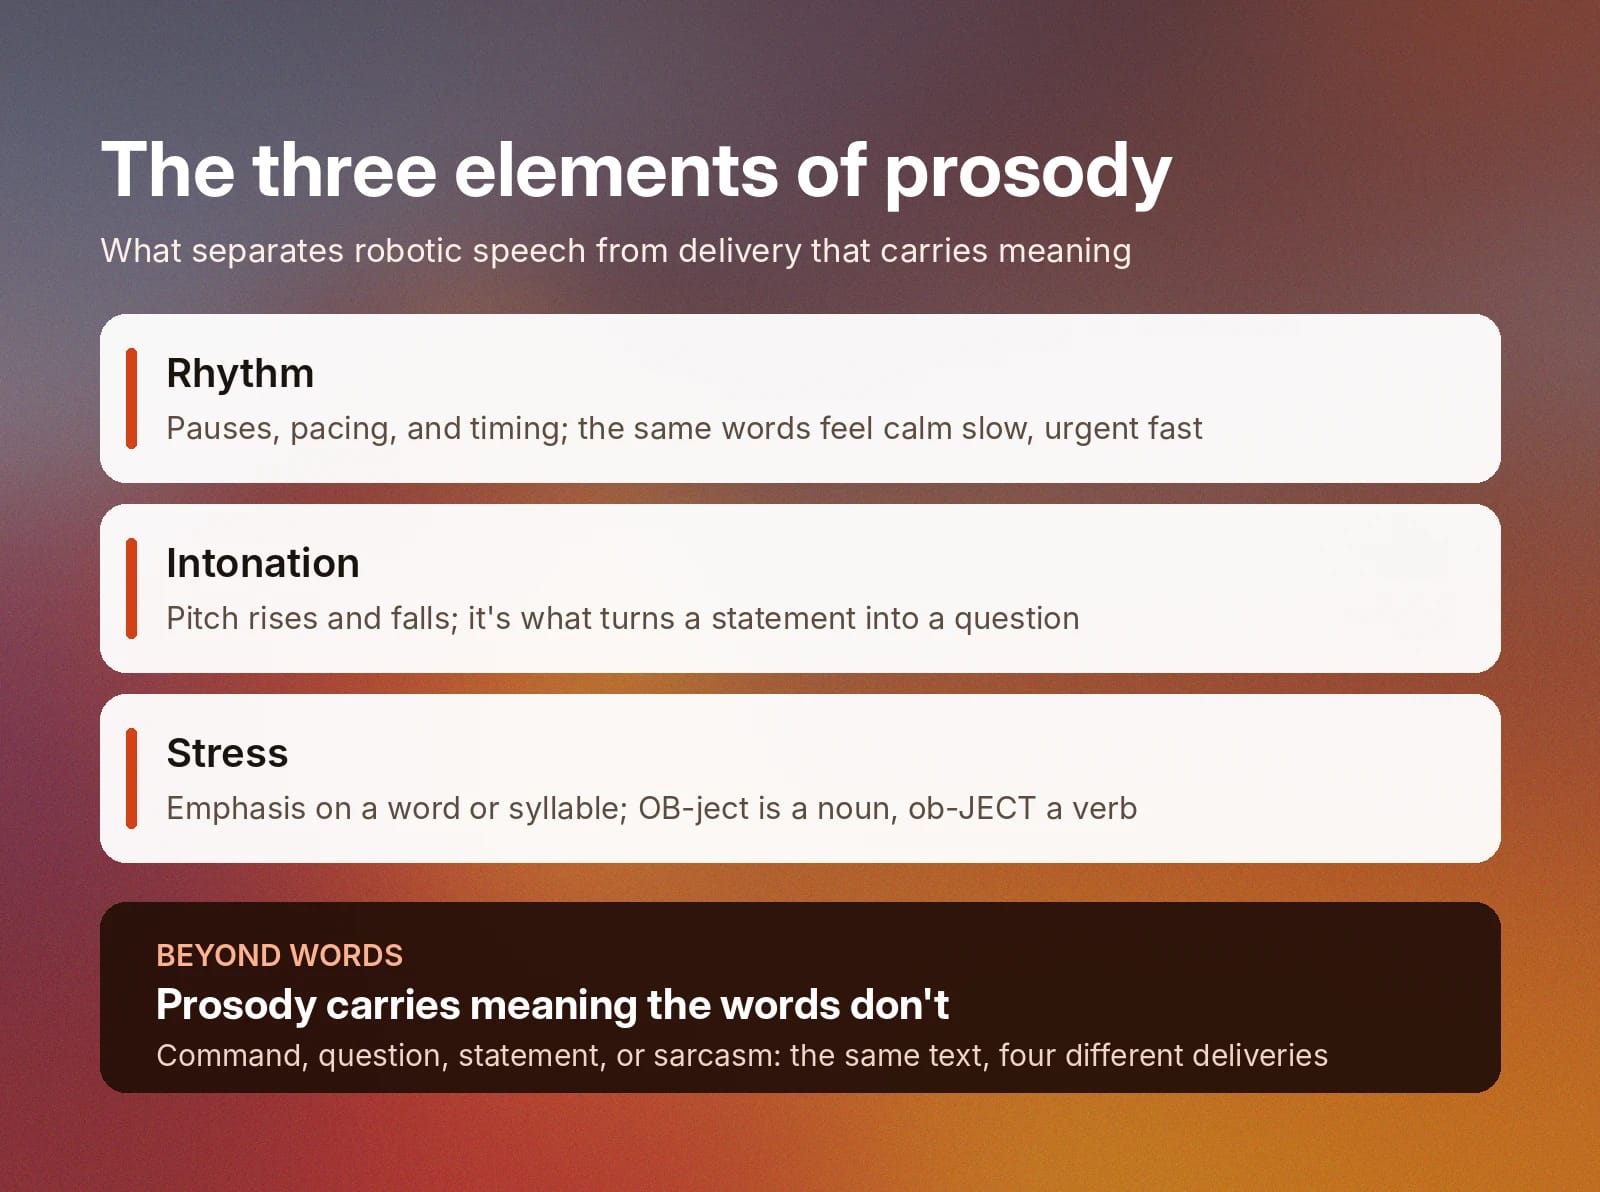
Przy analizie prozodii zwykle bierzemy pod uwagę trzy elementy:
- Rytm: sposób, w jaki czas i tempo mowy tworzą wzorce.
- Intonacja: sposób, w jaki wysokość głosu rośnie i opada w zdaniu.
- Akcent: sposób, w jaki konkretne słowa lub sylaby są podkreślane wysokością głosu, głośnością lub długością.
Umiejętność kontrolowania tych trzech elementów odróżnia robotyczną mowę od przekazu, który niesie znaczenie wykraczające poza same słowa.
Prozodia w mowie: rytm, intonacja i akcent
Choć mogą wydawać się proste, rytm, intonacja i akcent mają duże znaczenie dla przekazywania emocji kryjących się za słowami.
Przyjrzyjmy się bliżej temu, jak te trzy podstawowe elementy wpływają na mowę.
Rytm
Rytm kształtuje pauzy, tempo i czas trwania, które nadają mowie strukturę. Języki romańskie, takie jak francuski i hiszpański, zwykle poświęcają tyle samo czasu każdej sylabie, podczas gdy w angielskim i niemieckim czas oraz tempo wypowiadania słów są bardziej zróżnicowane.
Rytm może też zmienić odbiór zdania. Powiedziane powoli i równomiernie „Już jedziemy” brzmi uspokajająco. Wypowiedziane szybko te same słowa brzmią zbito i tworzą poczucie pilności.
Wolniejsze tempo
Intonacja
Intonacja to sposób, w jaki wysokość głosu rośnie i opada. Często to właśnie ona odróżnia pytanie od stwierdzenia.
Weźmy zdanie: „Jim wygrał mecz”. Gdy kończy się kropką, słowo „mecz” wypowiadamy na tej samej wysokości co resztę zdania. Aby jednak zaznaczyć, że to pytanie („Jim wygrał mecz?”), na końcu podnosisz głos.
Intonacja może też wyrażać emocje. Entuzjastyczne „Cześć!” będzie miało inną wysokość głosu niż rozczarowane lub obojętne „Cześć”.
Jim wygrał mecz
Akcent
Akcent to sposób, w jaki podkreślamy słowo lub jego część.
Na przykład angielskie słowo „object” ma dwa znaczenia. Z akcentem na pierwszej części („OB-ject”) oznacza rzeczownik. Akcent na drugiej części („ob-JECT”) zmienia je w czasownik.
W zdaniu akcent kieruje uwagę na dane słowo. Podkreślenie „ja” w zdaniu „Ja widziałem Jima na meczu” mówi słuchaczowi, że ważne jest, kto widział Jima na meczu. Z kolei podkreślenie słowa „meczu” wskazuje słuchaczowi, gdzie go widziano.
Jak prozodia wpływa na czytanie?
Prozodia podczas czytania nadaje słowom kontekst. Pomyśl o tym jak o czytaniu dziecku opowiadania na głos: bez zmiany głosów i tonów dziecku trudniej byłoby zrozumieć, co czuje postać lub co wyraża dana scena.
Prozodia jest też wiarygodnym wskaźnikiem płynności czytania. Osoby biegle posługujące się językiem potrafią dodać do zapisanych słów prozodyczny akcent, pokazując, że rozumieją nie tylko ich dosłowne znaczenie, ale też sens niewyrażony na stronie.
Ogólnie prozodia poprawia umiejętność czytania i płynność językową, bo nadaje słowom i zwrotom kontekst. Ogranicza też nieporozumienia, łącząc znaczenie słów z odbiorcą lub sytuacją, w której są wypowiadane.
Dlaczego prozodia jest ważna dla modeli Text to Speech?
Słowa, które model Text to Speech zamienia w audio — pobrane ze skryptu lub wygenerowane przez LLM — początkowo są zwykłym tekstem. Mogą być idealnie dobrane, ale sam tekst nie przekazuje tonu, akcentu ani emocji.
Pomyśl o klasycznym bocie IVR, który mówi: „Przepraszam. Nie zrozumiałem tego”. Taka kwestia jest zwykle wypowiadana płaską prozodią, więc większość słuchaczy nie uzna, że bot naprawdę żałuje niedogodności, które powoduje.
Porównajmy to z głosowym agentem AI obsługującym sfrustrowanego klienta, którego lot został odwołany.

Odpowiedź brzmi po ludzku, gdy agent AI mówi: „Rozumiem i bardzo mi przykro”, ponieważ nie jest monotonna. Zawiera lekkie westchnienie, pauzę na początku i niski ton — elementy, które równie mocno jak słowa wyrażają przeprosiny.
Dzięki właściwemu użyciu tych elementów prozodii agent może rozładować napiętą sytuację, zamiast potęgować frustrację.
Modele Text to Speech napędzają nie tylko agentów AI. Stoją też za narzędziami ElevenCreative do nałożonych głosów, narracji i treści marketingowych. Głos AI, który właściwie wykorzystuje prozodię, może pomóc ci w:
- Nałożonych głosach: tworzeniu reklam, filmów wyjaśniających i treści do mediów społecznościowych, które naprawdę angażują.
- Audiobookach: narracji z odpowiednim ładunkiem emocji, dzięki czemu strach, radość lub sarkazm postaci wybrzmiewają tak, jak przekazałby je ludzki narrator.
- Lokalizacji: zachowaniu emocjonalnego zamysłu oryginalnej treści w różnych językach.
- Marketingu i komunikacji marki: utrzymaniu odpowiedniego tonu audio, bez brzmienia poważnie tam, gdzie powinno być energicznie — i odwrotnie.
Prozodia to umożliwia. Zobaczmy teraz, jak modele Text to Speech faktycznie ją tworzą.
Jak modele TTS generują prozodię
Współczesne neuronowe modele Text to Speech (neural TTS) generują prozodię dzięki modelom głębokiego uczenia trenowanym na prawdziwej ludzkiej mowie. Zamiast kierować się ręcznie zapisanymi regułami fonetycznymi, model uczy się związku między tekstem a tym, jak faktycznie brzmi on po wypowiedzeniu na głos.
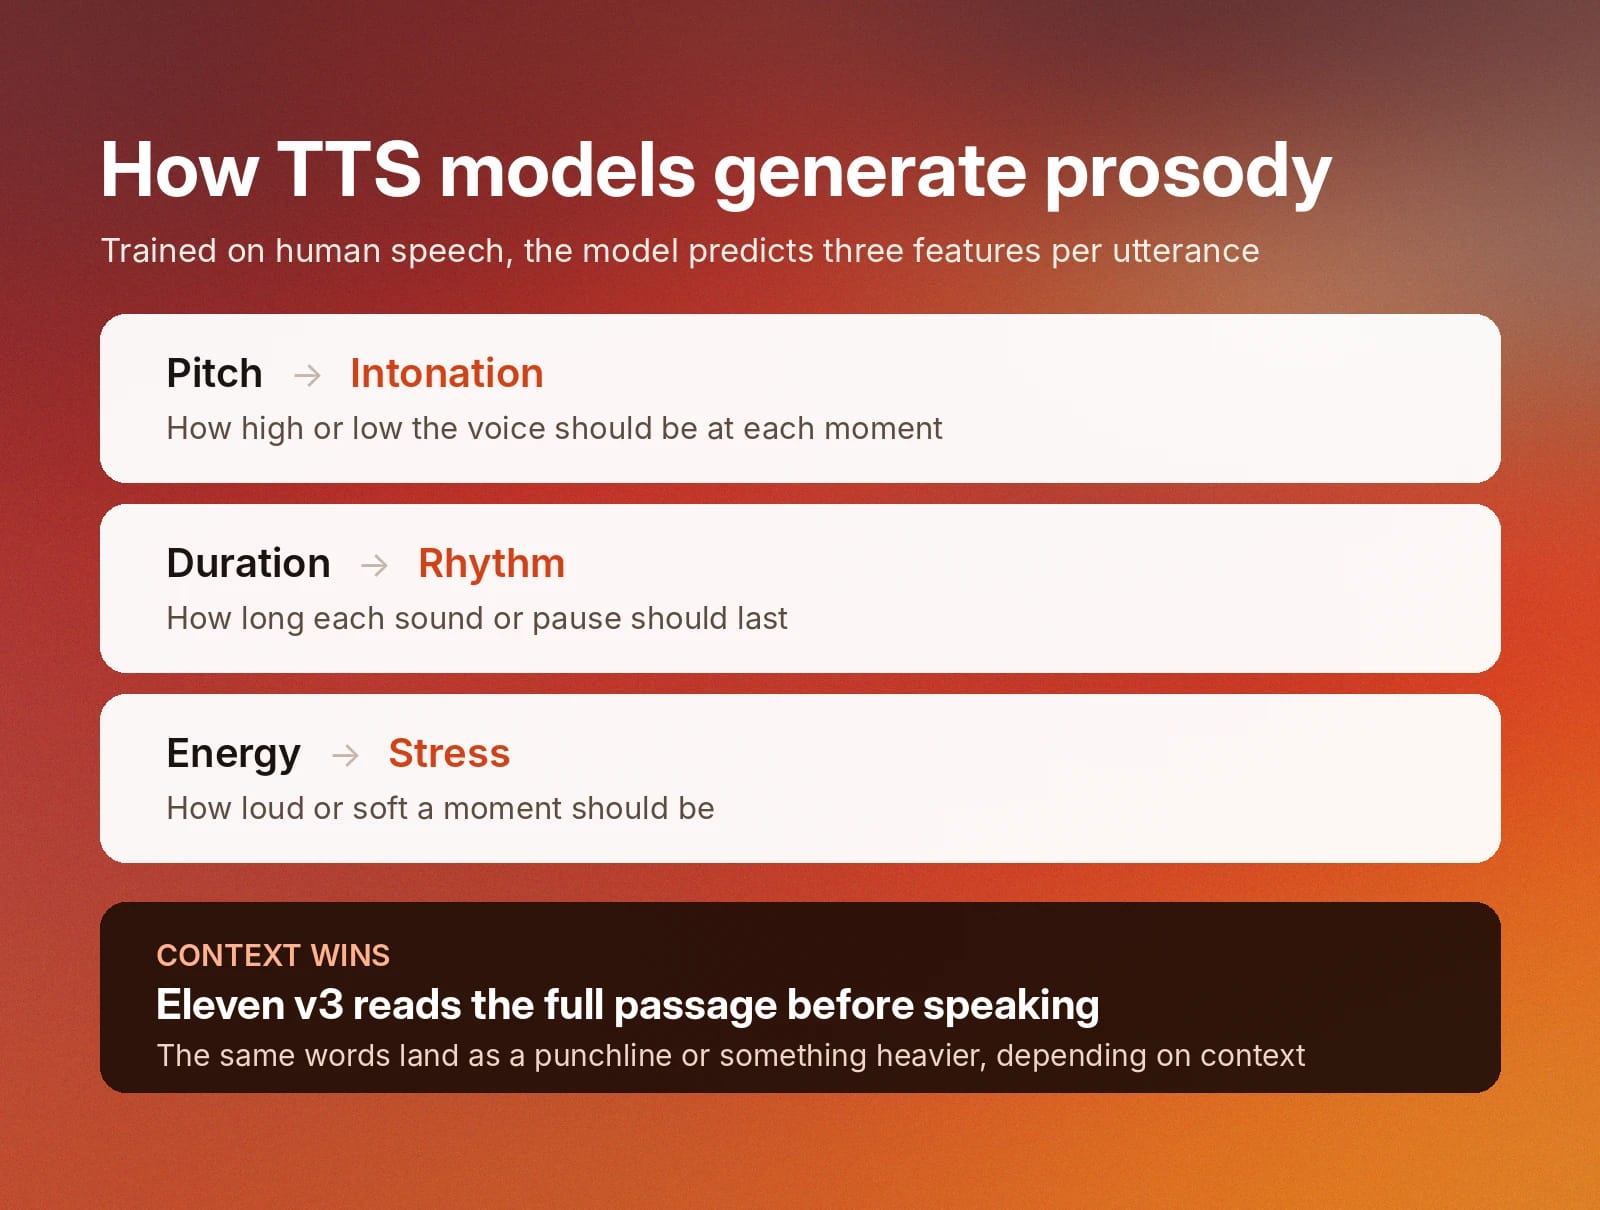
Ten proces treningowy pozwala modelowi TTS przewidywać trzy cechy wypowiedzi:
- Wysokość głosu: określa, jak wysoki lub niski ma być głos, tworząc intonację.
- Czas trwania: określa długość każdego dźwięku lub pauzy, tworząc rytm.
- Energia: określa, jak głośny lub cichy ma być dany moment, tworząc akcent i podkreślenie.
Na przykład model trenowany na tysiącach godzin ludzkiej mowy usłyszał niezliczone pytania wyrażające niedowierzanie, takie jak „Czekaj, co zrobiłeś?”, wypowiedziane z gwałtownym wzrostem wysokości głosu i przypływem energii w ostatnim słowie. Uczy się tego wzorca przez wielokrotny kontakt z nim, a potem stosuje podobne brzmienie, gdy napotyka zwrot wyrażający ten sam rodzaj niedowierzania.
To, z jak szerokiego kontekstu model może korzystać przy tworzeniu takiego brzmienia, zależy jednak również od architektury odpowiedzialnej za przewidywanie.
Starsze modele TTS działały w pipeline, przetwarzając tekst zdanie po zdaniu i przekazując prognozy między osobnymi sieciami, zanim wygenerowały audio. Nowsze modele oparte na transformatorach łączą ten pipeline w jeden proces end-to-end.
Zamiast czytać jedno zdanie w izolacji, model najpierw czyta cały fragment, a następnie wykorzystuje szerszy kontekst, by zdecydować, jak powinna brzmieć dana kwestia. Te same słowa mogą wybrzmieć jak puenta albo jako coś znacznie poważniejszego — zależnie od otaczającego je tekstu.
Modele takie jak Eleven v3 czytają cały fragment przed wygenerowaniem audio, aby brzmienie odzwierciedlało kontekst otaczającego tekstu.
Jak użytkownicy kontrolują prozodię w TTS
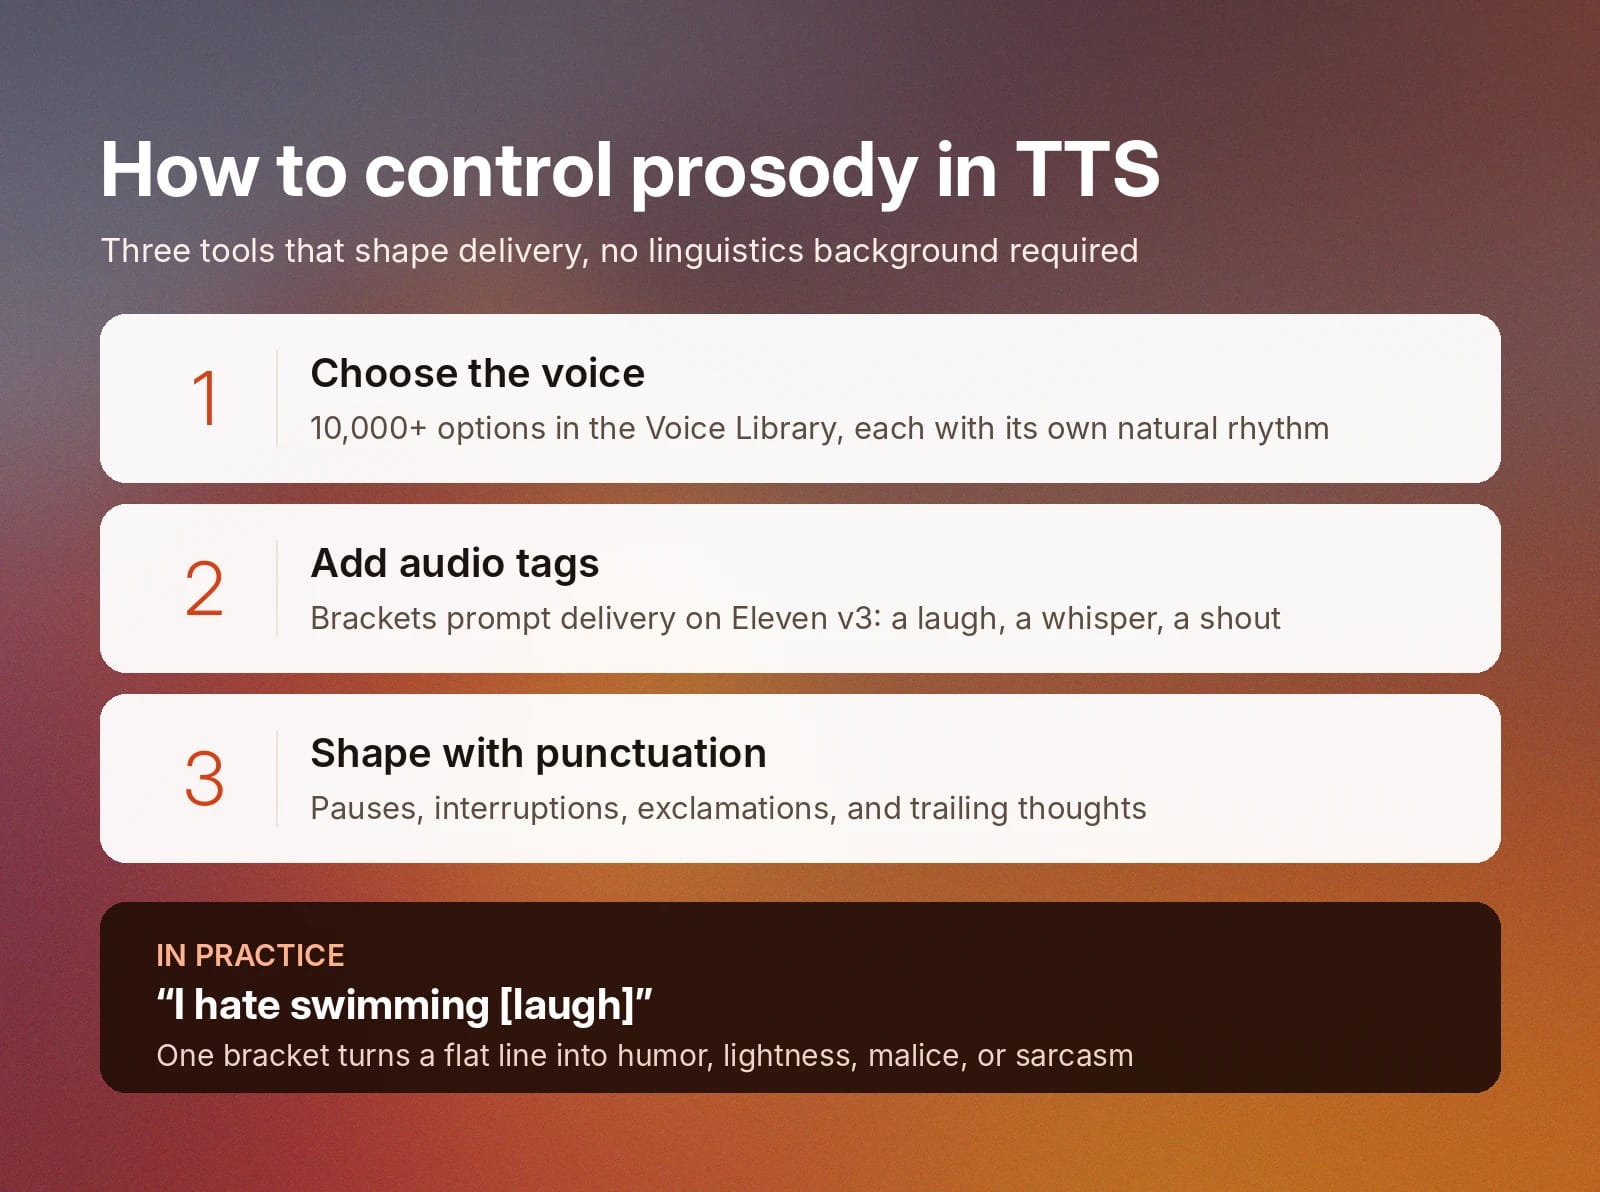
Użytkownicy mogą kontrolować prozodię w TTS, wybierając unikalne głosy AI i dodając emocjonalne tagi do skryptów. ElevenCreative zapewnia na przykład dostęp do Voice Library, gdzie możesz wybierać spośród ponad 10 000 głosów, aby znaleźć ten o szukanym naturalnym rytmie i intonacji.
Eleven v3, nasz najbardziej ekspresyjny model TTS, daje ci też możliwość dodawania tagów audio w nawiasach kwadratowych do tekstu, wskazując modelowi konkretny element prozodii. Możesz dodać śmiech między zdaniami, by wyrazić humor, lekkość, złośliwość lub sarkazm, albo sprawić, by model głosowy wyszeptał lub wykrzyczał słowo dla podkreślenia. Interpunkcja również może tworzyć pauzy, przerwania, wykrzyknienia, pytania czy urwane wypowiedzi.
Może to wyglądać tak:
- „[laughing] Nienawidzę pływać.”
- „[surprised] Nie mogę uwierzyć, że to zrobił! Jestem w szoku… i pod wrażeniem.”
- „[annoyed] Nie rób tego!”
Zobaczmy je w działaniu:
Dzięki tym narzędziom nie potrzebujesz wiedzy z językoznawstwa ani produkcji audio, by kontrolować prozodię. Każdy może kształtować brzmienie głosu AI, wybierając głos, dodając tag lub zmieniając interpunkcję.
Wzmocnij ekspresję głosów AI z ElevenCreative
Niezależnie od tego, czy tworzysz reklamy, publikujesz w mediach społecznościowych czy nagrywasz filmy, chcesz, by brzmiały tak, jakby stworzyła je i nagrała prawdziwa osoba.
ElevenCreative pozwala w kilka minut generować audio i materiały wizualne na dużą skalę. Platforma stworzona z myślą o AI potrafi zamienić tekst w ludzką mowę dopasowaną do kontekstu, emocji i intencji mówiącego. Dzięki ponad 70 językom dostępnym w Eleven v3 oraz ogromnej bibliotece głosów możesz mieć pewność, że trafisz z właściwym tonem do odbiorców.
Dowiedz się więcej o TTS w ElevenCreative lub zarejestruj się, aby zacząć i zobaczyć, jak głos AI z naturalną prozodią może zmienić twoje treści.