

Modificatore di Voce
Panoramica
Il Modificatore di Voce (in precedenza Speech-to-Speech) ti consente di convertire una voce (voce sorgente) in un’altra (voce clonata), preservando il tono e l’interpretazione della voce originale.
Puoi usare il Modificatore di Voce insieme a Text-to-Speech (TTS) per correggere errori di pronuncia o aggiungere quell’interpretazione speciale che desideri esprimere. Il Modificatore di Voce è particolarmente utile per riprodurre le caratteristiche sottili e peculiari della voce che rendono il risultato più emotivo e umano. Tra le funzionalità principali:
- Maggiore precisione con i sussurri
- Possibilità di creare sospiri, risate o pianti udibili
- Rilevamento di tono ed emozioni notevolmente migliorato
- Segue accuratamente il ritmo del parlato in input
- Conservazione della lingua e dell’accento
Guarda il Modificatore di Voce in azione
Guida
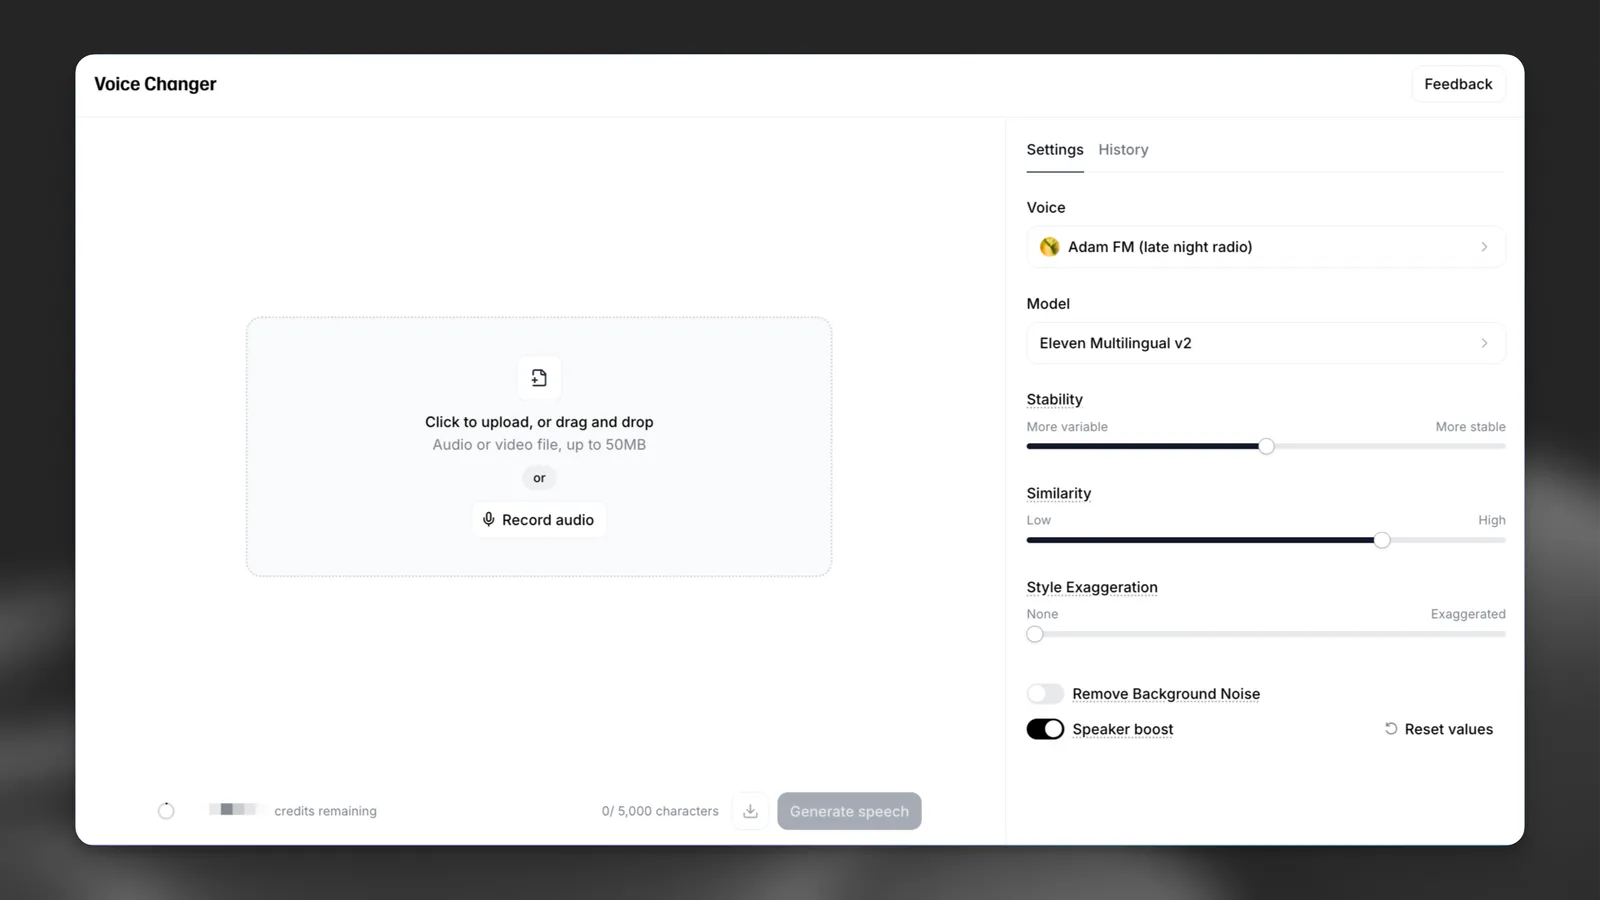
Puoi caricare l’audio direttamente da un file oppure registrarlo dal vivo con un microfono. Il file audio deve avere una dimensione inferiore a 50 MB e né il file audio né la registrazione dal vivo possono superare i 5 minuti.
Se hai materiale più lungo di 5 minuti, ti consigliamo di dividerlo in sezioni più piccole e generarle separatamente. Inoltre, se il file è troppo grande, potrebbe essere necessario comprimerlo o convertirlo in formato mp3.
File audio esistente
Per caricare un file audio esistente, fai clic sul riquadro dell’audio oppure trascina il file direttamente al suo interno.
Registra dal vivo
Premi il pulsante Registra audio nel riquadro dell’audio, quindi, quando sei pronto per iniziare a registrare, premi il pulsante Microfono. Al termine della registrazione, premi il pulsante Stop.
Vedrai quindi il file audio della registrazione, che potrai riprodurre per ascoltarlo: è utile per capire se sei soddisfatto della tua interpretazione o registrazione. Il costo in caratteri verrà mostrato nell’angolo in basso a sinistra e non ti verrà addebitata questa quota per le registrazioni: verrà addebitata solo quando premi “Genera”.
Il costo per una generazione con il Modificatore di Voce dipende esclusivamente dalla durata: 1000 caratteri al minuto.
Impostazioni
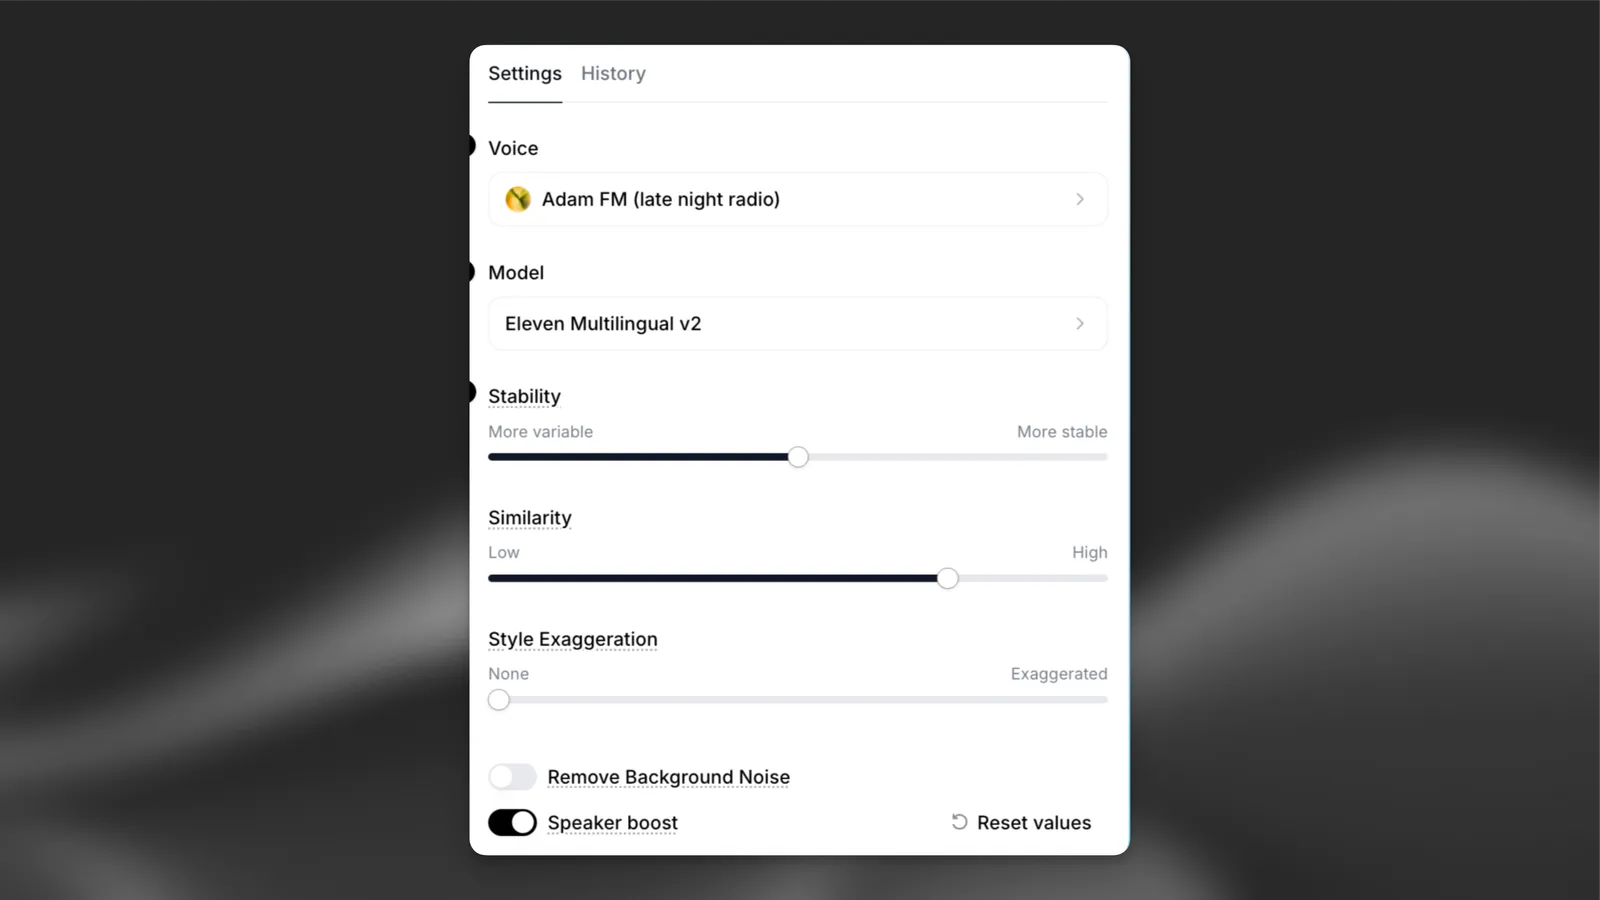
Scopri di più sulle diverse impostazioni vocali qui.
Il Modificatore di Voce aggiunge un’impostazione per rimuovere automaticamente il rumore di fondo dalla registrazione.
Lingue supportate
eleven_english_sts_v2
I nostri modelli multilingue v2 supportano 29 lingue:
inglese (Stati Uniti, Regno Unito, Australia, Canada), giapponese, cinese, tedesco, hindi, francese (Francia, Canada), coreano, portoghese (Brasile, Portogallo), italiano, spagnolo (Spagna, Messico), indonesiano, olandese, turco, filippino, polacco, svedese, bulgaro, rumeno, arabo (Arabia Saudita, Emirati Arabi Uniti), ceco, greco, finlandese, croato, malese, slovacco, danese, tamil, ucraino e russo.
Il modello eleven_english_sts_v2 supporta solo l’inglese.
Best practice
Il Modificatore di Voce eccelle nel preservare gli accenti e i ritmi naturali del parlato in varie voci di output. Ad esempio, se carichi un campione audio con un accento portoghese, l’output manterrà quella lingua e quell’accento. Il campione di input è fondamentale, poiché determina le caratteristiche dell’output. Se selezioni una voce britannica come “George” ma registri con un accento americano, il risultato sarà la voce di George con un accento americano.
- Espressività: esprimi le emozioni nelle registrazioni. Che tu urli, pianga o rida, il Modificatore di Voce riprodurrà accuratamente la tua interpretazione. Questo strumento è progettato per migliorare il realismo dell’IA e consentire l’espressione creativa.
- Guadagno del microfono: assicurati che il guadagno in input sia appropriato. Una registrazione troppo silenziosa può ostacolare il riconoscimento da parte dell’IA, mentre una troppo alta può causare clipping audio.
- Rumore di fondo: attiva l’opzione Rimuovi rumore di fondo per rimuoverlo automaticamente dalla registrazione.