

Modelli
Modelli di punta
Text to Speech
Speech to Text
Musica
Panoramica dei modelli
L’API di ElevenLabs offre una gamma di modelli audio ottimizzati per diversi casi d’uso, livelli di qualità e requisiti di prestazione.
Modelli deprecati
I modelli eleven_turbo_v2_5 e eleven_turbo_v2 sono funzionalmente equivalenti rispettivamente ai
modelli eleven_flash_v2_5 e eleven_flash_v2, tranne per il fatto che la latenza media dei modelli Flash
è inferiore. Consigliamo di usare i modelli Flash anziché i modelli Turbo in tutti i casi
d’uso.
Eleven v4
Eleven v4 è il nostro modello di sintesi vocale all’avanguardia, che offre audio della massima qualità, espressività e controllo sul modo in cui vengono interpretate le voci. Eleven v4 supporta la clonazione vocale ad alta fedeltà con una preservazione affidabile del parlante nelle generazioni di testi lunghi.
Questo modello funziona bene nei seguenti scenari:
- Voci fuori campo per personaggi: ideale per giochi e animazioni grazie alla sua gamma emotiva.
- Dialoghi emotivi: genera dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto.
- Produzione di audiolibri: perfetto per narrazioni di lunga durata con interpretazioni emotive complesse.
- Progetti multilingue: mantiene una qualità vocale costante quando si passa da una lingua all’altra.
Eleven v4 è disponibile tramite l’API Text to Dialogue.
Lingue supportate
La famiglia di modelli Eleven v4 supporta oltre 90 lingue, tra cui:
Afrikaans (afr), amarico (amh), arabo (ara), armeno (hye), assamese (asm), asturiano (ast), azero (aze), bielorusso (bel), bengalese (ben), bosniaco (bos), bulgaro (bul), birmano (mya), cantonese (yue), catalano (cat), cebuano (ceb), croato (hrv), ceco (ces), danese (dan), olandese (nld), inglese (eng), estone (est), filippino (fil), finlandese (fin), francese (fra), fula/pulaar (ful), galiziano (glg), georgiano (kat), tedesco (deu), greco (ell), gujarati (guj), hausa (hau), ebraico (heb), hindi (hin), ungherese (hun), islandese (isl), indonesiano (ind), italiano (ita), giapponese (jpn), giavanese (jav), kamba (kam), kannada (kan), kazako (kaz), coreano (kor), kirghiso (kir), lao (lao), lettone (lav), lingala (lin), lituano (lit), luganda (lug), lussemburghese (ltz), macedone (mkd), malese (msa), malayalam (mal), maltese (mlt), cinese mandarino (cmn), māori (mri), marathi (mar), mongolo (mon), nepalese (nep), bokmål norvegese (nob), occitano (oci), odia (ori), pashtu (pus), persiano (fas), polacco (pol), portoghese, Brasile (por), punjabi (pan), rumeno (ron), russo (rus), serbo (srp), shona (sna), sindhi (snd), slovacco (slk), sloveno (slv), somalo (som), curdo sorani (ckb), spagnolo, America Latina (spa), swahili (swa), svedese (swe), tagico (tgk), tamil (tam), telugu (tel), thailandese (tha), turco (tur), ucraino (ukr), urdu (urd), uzbeko (uzb), vietnamita (vie), gallese (cym), wolof (wol), zulu (zul).
Eleven v4 Turbo
Eleven v4 Turbo è il nostro modello all’avanguardia per la sintesi vocale in tempo reale, che offre audio di alta qualità, espressività e controllo sul modo in cui vengono interpretate le voci. Eleven v4 Turbo supporta la clonazione vocale ad alta fedeltà e fornisce risultati con una latenza mediana di inferenza di ~100 ms.
Questo modello funziona bene nei seguenti scenari:
- Agenti di assistenza: alimenta agenti vocali che risolvono le richieste dei clienti in tempo reale.
- Assistenti IA: genera dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto.
- Personaggi interattivi: eccellente per esperienze audio con personaggi espressivi.
Eleven v4 Turbo è disponibile tramite il WebSocket Text to Dialogue.
Lingue supportate
La famiglia di modelli Eleven v4 supporta oltre 90 lingue, tra cui:
Afrikaans (afr), amarico (amh), arabo (ara), armeno (hye), assamese (asm), asturiano (ast), azero (aze), bielorusso (bel), bengalese (ben), bosniaco (bos), bulgaro (bul), birmano (mya), cantonese (yue), catalano (cat), cebuano (ceb), croato (hrv), ceco (ces), danese (dan), olandese (nld), inglese (eng), estone (est), filippino (fil), finlandese (fin), francese (fra), fula/pulaar (ful), galiziano (glg), georgiano (kat), tedesco (deu), greco (ell), gujarati (guj), hausa (hau), ebraico (heb), hindi (hin), ungherese (hun), islandese (isl), indonesiano (ind), italiano (ita), giapponese (jpn), giavanese (jav), kamba (kam), kannada (kan), kazako (kaz), coreano (kor), kirghiso (kir), lao (lao), lettone (lav), lingala (lin), lituano (lit), luganda (lug), lussemburghese (ltz), macedone (mkd), malese (msa), malayalam (mal), maltese (mlt), cinese mandarino (cmn), māori (mri), marathi (mar), mongolo (mon), nepalese (nep), bokmål norvegese (nob), occitano (oci), odia (ori), pashtu (pus), persiano (fas), polacco (pol), portoghese, Brasile (por), punjabi (pan), rumeno (ron), russo (rus), serbo (srp), shona (sna), sindhi (snd), slovacco (slk), sloveno (slv), somalo (som), curdo sorani (ckb), spagnolo, America Latina (spa), swahili (swa), svedese (swe), tagico (tgk), tamil (tam), telugu (tel), thailandese (tha), turco (tur), ucraino (ukr), urdu (urd), uzbeko (uzb), vietnamita (vie), gallese (cym), wolof (wol), zulu (zul).
Eleven v3
Eleven v3 è il nostro modello di sintesi vocale della generazione precedente, che produce parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Con Eleven v3 arriva una nuova API Text to Dialogue, che ti consente di generare dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto in più lingue. Puoi anche usare Eleven v3 con l’API Text to Speech per generare parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Scopri di più sull’API Text to Dialogue qui.
Lingue supportate
Il modello Eleven v3 supporta oltre 70 lingue, tra cui:
Afrikaans (afr), arabo (ara), armeno (hye), assamese (asm), azero (aze), bielorusso (bel), bengalese (ben), bosniaco (bos), bulgaro (bul), catalano (cat), cebuano (ceb), chichewa (nya), croato (hrv), ceco (ces), danese (dan), olandese (nld), inglese (eng), estone (est), filippino (fil), finlandese (fin), francese (fra), galiziano (glg), georgiano (kat), tedesco (deu), greco (ell), gujarati (guj), hausa (hau), ebraico (heb), hindi (hin), ungherese (hun), islandese (isl), indonesiano (ind), irlandese (gle), italiano (ita), giapponese (jpn), giavanese (jav), kannada (kan), kazako (kaz), kirghiso (kir), coreano (kor), lettone (lav), lingala (lin), lituano (lit), lussemburghese (ltz), macedone (mkd), malese (msa), malayalam (mal), cinese mandarino (cmn), marathi (mar), nepalese (nep), norvegese (nor), pashtu (pus), persiano (fas), polacco (pol), portoghese (por), punjabi (pan), rumeno (ron), russo (rus), serbo (srp), sindhi (snd), slovacco (slk), sloveno (slv), somalo (som), spagnolo (spa), swahili (swa), svedese (swe), tamil (tam), telugu (tel), thailandese (tha), turco (tur), ucraino (ukr), urdu (urd), vietnamita (vie), gallese (cym).
Eleven v3 Conversational
Eleven v3 Conversational è il nostro modello della generazione precedente per la sintesi vocale in tempo reale. Produce parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Con Eleven v3 Conversational arriva un nuovo WebSocket Text to Dialogue, che ti consente di generare dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Con Eleven v3 Conversational arriva un nuovo WebSocket Text to Dialogue, che ti consente di generare dialoghi naturali e realistici con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Scopri di più sul WebSocket Text to Dialogue qui.
Lingue supportate
Il modello Eleven v3 supporta oltre 70 lingue, tra cui:
Afrikaans (afr), arabo (ara), armeno (hye), assamese (asm), azero (aze), bielorusso (bel), bengalese (ben), bosniaco (bos), bulgaro (bul), catalano (cat), cebuano (ceb), chichewa (nya), croato (hrv), ceco (ces), danese (dan), olandese (nld), inglese (eng), estone (est), filippino (fil), finlandese (fin), francese (fra), galiziano (glg), georgiano (kat), tedesco (deu), greco (ell), gujarati (guj), hausa (hau), ebraico (heb), hindi (hin), ungherese (hun), islandese (isl), indonesiano (ind), irlandese (gle), italiano (ita), giapponese (jpn), giavanese (jav), kannada (kan), kazako (kaz), kirghiso (kir), coreano (kor), lettone (lav), lingala (lin), lituano (lit), lussemburghese (ltz), macedone (mkd), malese (msa), malayalam (mal), cinese mandarino (cmn), marathi (mar), nepalese (nep), norvegese (nor), pashtu (pus), persiano (fas), polacco (pol), portoghese (por), punjabi (pan), rumeno (ron), russo (rus), serbo (srp), sindhi (snd), slovacco (slk), sloveno (slv), somalo (som), spagnolo (spa), swahili (swa), svedese (swe), tamil (tam), telugu (tel), thailandese (tha), turco (tur), ucraino (ukr), urdu (urd), vietnamita (vie), gallese (cym).
Multilingual v2
Eleven Multilingual v2 è un modello di sintesi vocale della generazione precedente sensibile alle emozioni. Produce parlato naturale e realistico con un’ampia gamma emotiva e comprensione del contesto in più lingue.
Il modello offre qualità e personalità vocale costanti in tutte le lingue supportate, mantenendo al contempo le caratteristiche uniche e l’accento del parlante.
Questo modello eccelle negli scenari che richiedono parlato di alta qualità con sfumature emotive:
- Voci fuori campo per personaggi: ideale per giochi e animazioni grazie alla sua gamma emotiva.
- Contenuti professionali: adatto a video aziendali e materiali di e-learning.
- Progetti multilingue: mantiene una qualità vocale costante quando si passa da una lingua all’altra.
- Qualità stabile: produce output audio costante e di alta qualità.
Pur avendo una latenza e un costo per carattere superiori rispetto ai modelli Flash, offre una qualità maggiore per i progetti in cui è importante un parlato realistico.
I nostri modelli multilingue v2 supportano 29 lingue:
inglese (Stati Uniti, Regno Unito, Australia, Canada), giapponese, cinese, tedesco, hindi, francese (Francia, Canada), coreano, portoghese (Brasile, Portogallo), italiano, spagnolo (Spagna, Messico), indonesiano, olandese, turco, filippino, polacco, svedese, bulgaro, rumeno, arabo (Arabia Saudita, Emirati Arabi Uniti), ceco, greco, finlandese, croato, malese, slovacco, danese, tamil, ucraino e russo.
Flash v2.5
Eleven Flash v2.5 è il nostro modello di sintesi vocale più veloce, progettato per applicazioni in tempo reale e Agents Platform. Offre parlato di alta qualità con latenza estremamente bassa (~75 ms†) in 32 lingue.
Il modello bilancia velocità e qualità, rendendolo ideale per le applicazioni interattive e mantenendo al contempo un output naturale e caratteristiche vocali coerenti tra le lingue.
Questo modello è particolarmente adatto per:
- Agents Platform: perfetto per agenti vocali e chatbot in tempo reale.
- Applicazioni interattive: ideale per giochi e applicazioni che richiedono una risposta immediata.
- Elaborazione su larga scala: efficiente per la conversione in blocco da testo a parlato.
Grazie al prezzo inferiore per le generazioni tramite API e alla latenza di 75 ms, Flash v2.5 è l’opzione conveniente per chiunque necessiti di una sintesi vocale veloce e affidabile in più lingue.
Flash v2.5 supporta 32 lingue: tutte le lingue dei modelli v2, più:
ungherese, norvegese e vietnamita
† Esclusa la latenza dell’applicazione e della reteConsiderazioni
Normalizzazione del testo con numeri
Quando usi Flash v2.5, i numeri non vengono normalizzati per impostazione predefinita nel modo che potresti aspettarti. Ad esempio, i numeri di telefono potrebbero essere letti in un modo poco chiaro per l’utente. Date e valute sono interessate in modo simile.
Per impostazione predefinita, la normalizzazione è disattivata per Flash v2.5 per mantenere la bassa latenza. Tuttavia, i clienti Enterprise possono ora abilitare la normalizzazione del testo per i modelli v2.5 impostando il parametro apply_text_normalization su “on” nella richiesta.
Il modello Multilingual v2 gestisce meglio la normalizzazione dei numeri, quindi consigliamo di usarlo per i numeri di telefono e altri casi in cui è importante normalizzare i numeri.
Per le applicazioni a bassa latenza o Agents Platform, la procedura consigliata è fare in modo che il tuo LLM normalizzi il testo prima di passarlo al modello TTS, oppure usare il parametro apply_text_normalization (solo piani Enterprise per i modelli v2.5).
Guida alla selezione del modello
Per indicazioni sul modello più adatto ai tuoi requisiti e al tuo caso d’uso, consulta la guida alla selezione del modello.
Requisiti
Caso d'uso
Limiti di caratteri
Il numero massimo di caratteri supportati in una singola richiesta text-to-speech varia in base al modello.
Scribe v2
Scribe v2 è il nostro modello di riconoscimento vocale all’avanguardia, progettato per trascrizioni accurate in oltre 90 lingue. Fornisce timestamp precisi a livello di parola e funzionalità avanzate come la diarizzazione dei parlanti e il tagging audio dinamico.
Questo modello eccelle negli scenari che richiedono una conversione accurata da voce a testo:
- Servizi di trascrizione: Perfetto per convertire contenuti audio/video in testo
- Documentazione delle riunioni: Ideale per acquisire e documentare le conversazioni
- Analisi dei contenuti: Adatto all’elaborazione e all’analisi di contenuti audio
- Riconoscimento multilingue: Supporta trascrizioni accurate in oltre 90 lingue
Funzionalità principali:
- Trascrizione accurata con timestamp a livello di parola
- Diarizzazione dei parlanti per audio con più persone
- Tagging audio dinamico per un contesto più ricco
- Supporto per oltre 90 lingue
- Rilevamento delle entità
- Prompting di termini chiave
- Modifica della trascrizione
Scopri di più su Scribe v2 qui.
Scribe v2 Realtime
Scribe v2 Realtime, il nostro modello di riconoscimento vocale in tempo reale più veloce e accurato, offre un’accuratezza all’avanguardia in oltre 90 lingue con una latenza ultra bassa di 150 ms.
Questo modello eccelle nei casi d’uso conversazionali:
- Trascrizione di riunioni in diretta: Perfetto per la trascrizione in tempo reale
- Agenti IA: Ideale per le conversazioni in diretta
- Riconoscimento multilingue: Supporta trascrizioni accurate in oltre 90 lingue con riconoscimento automatico della lingua
Funzionalità principali:
- Latenza ultra bassa: ricevi trascrizioni parziali in ~150 millisecondi
- Supporto dello streaming: invia l’audio in blocchi mentre ricevi le trascrizioni in tempo reale
- Più formati audio: supporto per PCM (da 8 kHz a 48 kHz) e codifica μ-law
- Rilevamento dell’attività vocale (VAD): segmentazione automatica del parlato basata sul rilevamento del silenzio
- Controllo manuale del commit: controllo completo su quando finalizzare i segmenti della trascrizione
- Rilevamento delle entità
- Modifica della trascrizione
Scopri di più su Scribe v2 Realtime qui.
Scribe v2 Medical
Scribe v2 Medical è un modello di riconoscimento vocale batch specializzato per audio medico e clinico. È un fine-tune di Scribe v2 che migliora il riconoscimento di nomi di farmaci, anatomia, patologia e dettatura clinica, mantenendo l’accuratezza di Scribe v2 nel parlato quotidiano. Utilizza la stessa API Speech to Text di Scribe v2 e viene fatturato alla stessa tariffa. Passa scribe_v2_medical come model_id.
Uso previsto
Scribe v2 Medical è un modello API Speech-to-Text batch destinato a sviluppatori e organizzazioni per l’integrazione in applicazioni che convertono audio clinico, incluse conversazioni tra medici e pazienti, dettature, chiamate di accettazione e coordinamento delle cure, in bozze di trascrizioni per la documentazione e i relativi workflow amministrativi. Il testo risultante è destinato alla revisione e correzione da parte di un professionista sanitario o di un altro utente autorizzato prima dell’uso. Scribe v2 Medical non è destinato a interpretare informazioni cliniche né a fornire diagnosi, raccomandazioni terapeutiche, decisioni cliniche o altre indicazioni cliniche.
Questo modello è particolarmente adatto per:
- Documentazione clinica: Incontri ambientali e note in cui i termini medici emergono nel corso della conversazione
- Dettatura: Sequenze dense di farmaci, dosaggi e risultati
- Chiamate di accettazione e coordinamento: Pazienti che descrivono le proprie condizioni, spesso al telefono
- Workflow di conformità normativa: Combinalo con il rilevamento delle entità per le categorie PHI
Funzionalità principali:
- Stessa struttura delle richieste di Scribe v2 (
keyterms,entity_detection,no_verbatim, diarizzazione, timestamp) - Migliore riconoscimento di nomi di farmaci e termini di anatomia e patologia
- Nessuna regressione nel parlato quotidiano rispetto a Scribe v2
- Supporto per oltre 90 lingue
- Diarizzazione dei parlanti per audio con più persone
- Tagging audio dinamico
- Rilevamento delle entità, incluse le categorie PHI
Scribe v2 Medical è un modello batch. Per la trascrizione in tempo reale, usa Scribe v2 Realtime.
Scribe v2 Medical è idoneo per HIPAA, con Business Associate Agreement disponibili per i clienti Enterprise e la modalità Zero Retention Mode (ZRM). Con ZRM abilitata, l’input audio e l’output di testo vengono eliminati immediatamente dopo il completamento di ogni richiesta. ElevenLabs non conserva nulla e la tua applicazione riceve la risposta API completa, mantenendo le trascrizioni sotto i tuoi controlli.
Le aziende che richiedono la conformità HIPAA devono contattare il team commerciale di ElevenLabs per firmare un Business Associate Agreement (BAA) prima di inviare informazioni sanitarie protette.
Scopri di più su Speech to Text qui.
Eleven Music
Eleven Music è il nostro modello di generazione musicale di qualità da studio. Ti consente di generare musica in qualsiasi stile usando prompt in linguaggio naturale.
Questo modello è eccellente per i seguenti scenari:
- Colonne sonore per giochi: Crea colonne sonore coinvolgenti per i giochi
- Musica di sottofondo per podcast: Arricchisci i podcast con musica professionale
- Marketing: Aggiungi musica di sottofondo ai reel pubblicitari
Funzionalità principali:
- Controllo completo su genere, stile e struttura
- Voce o solo strumentale
- Multilingue, tra cui inglese, spagnolo, tedesco, giapponese e altro
- Modifica il suono e il testo delle singole sezioni o dell’intero brano
Scopri di più su Eleven Music qui.
Concorrenza e priorità
Il tuo piano di abbonamento determina quante richieste possono essere elaborate contemporaneamente e il livello di priorità delle tue richieste nella coda. Speech to Text ha un limite di concorrenza più elevato. Una volta raggiunto il limite di concorrenza, le richieste successive vengono elaborate in una coda insieme a richieste con priorità più bassa. In pratica, questo aggiunge in genere solo ~50 ms di latenza.
Gli header della risposta includono current-concurrent-requests e maximum-concurrent-requests, che puoi usare per monitorare la concorrenza.
Richieste API al minuto e richieste simultanee
È importante capire che le richieste API al minuto e le richieste simultanee sono metriche diverse che dipendono dai tuoi pattern di utilizzo.
Le richieste API al minuto possono differire dalle richieste simultanee, poiché dipendono dalla durata di ogni richiesta e da come le richieste vengono raggruppate.
Esempio 1: Richieste distanziate Se avessi 180 richieste al minuto, ciascuna della durata di 1 secondo, e le inviassi a intervalli di 0,33 secondi, il numero massimo e medio di richieste simultanee sarebbe 3, poiché ce ne sarebbero sempre 3 in corso.
Esempio 2: Richieste in batch Tuttavia, se avessi un pattern di utilizzo diverso, ad esempio 180 richieste al minuto che richiedono ciascuna 3 secondi per essere completate ma vengono tutte avviate contemporaneamente, il numero massimo di richieste simultanee sarebbe 180 e la media sarebbe 9 (nei primi 3 secondi del minuto ci sarebbero 180 richieste contemporaneamente, negli ultimi 57 secondi 0 richieste).
Poiché il nostro sistema considera la concorrenza, le richieste al minuto contano meno della durata di ogni richiesta e del pattern con cui vengono inviate.
Il modo in cui vengono effettuate le richieste agli endpoint influisce sui limiti di concorrenza:
- Con HTTP, ogni richiesta conta singolarmente ai fini del limite di concorrenza.
- Con il WebSocket Text to Speech, solo il tempo in cui il nostro modello genera audio conta ai fini del limite di concorrenza. Ciò significa che, per la maggior parte del tempo, un websocket aperto non conta affatto ai fini del limite di concorrenza.
- I WebSocket Text to Dialogue funzionano in modo diverso: ogni connessione aperta riserva una sessione di dialogo da un pool separato per tutto il tempo in cui resta aperta, e l’audio generato sulla connessione non conta ai fini del limite di concorrenza standard. Questo approccio è pensato per essere più semplice da comprendere: una connessione equivale a una sessione, e i limiti delle sessioni di dialogo sono dimensionati per adattarsi a questa nuova metodologia di concorrenza. Vedi concorrenza Text to Dialogue.
Comprendere i limiti di concorrenza
Il limite di concorrenza associato al tuo piano non deve essere interpretato come il numero massimo di conversazioni simultanee, chiamate telefoniche, voci fuori campo di personaggi e così via che possono essere gestite contemporaneamente. Il numero effettivo dipende da diversi fattori, tra cui le specifiche voci IA utilizzate e le caratteristiche del caso d’uso.
Come regola generale, un limite di concorrenza pari a 5 può in genere supportare circa 100 trasmissioni audio simultanee.
Questo è dovuto alla velocità con cui viene generato l’audio rispetto al tempo necessario per elaborare la richiesta TTS. Il diagramma seguente mostra un esempio di come gestire 4 chiamate simultanee con utenti diversi raggiungendo solo 2 richieste simultanee.
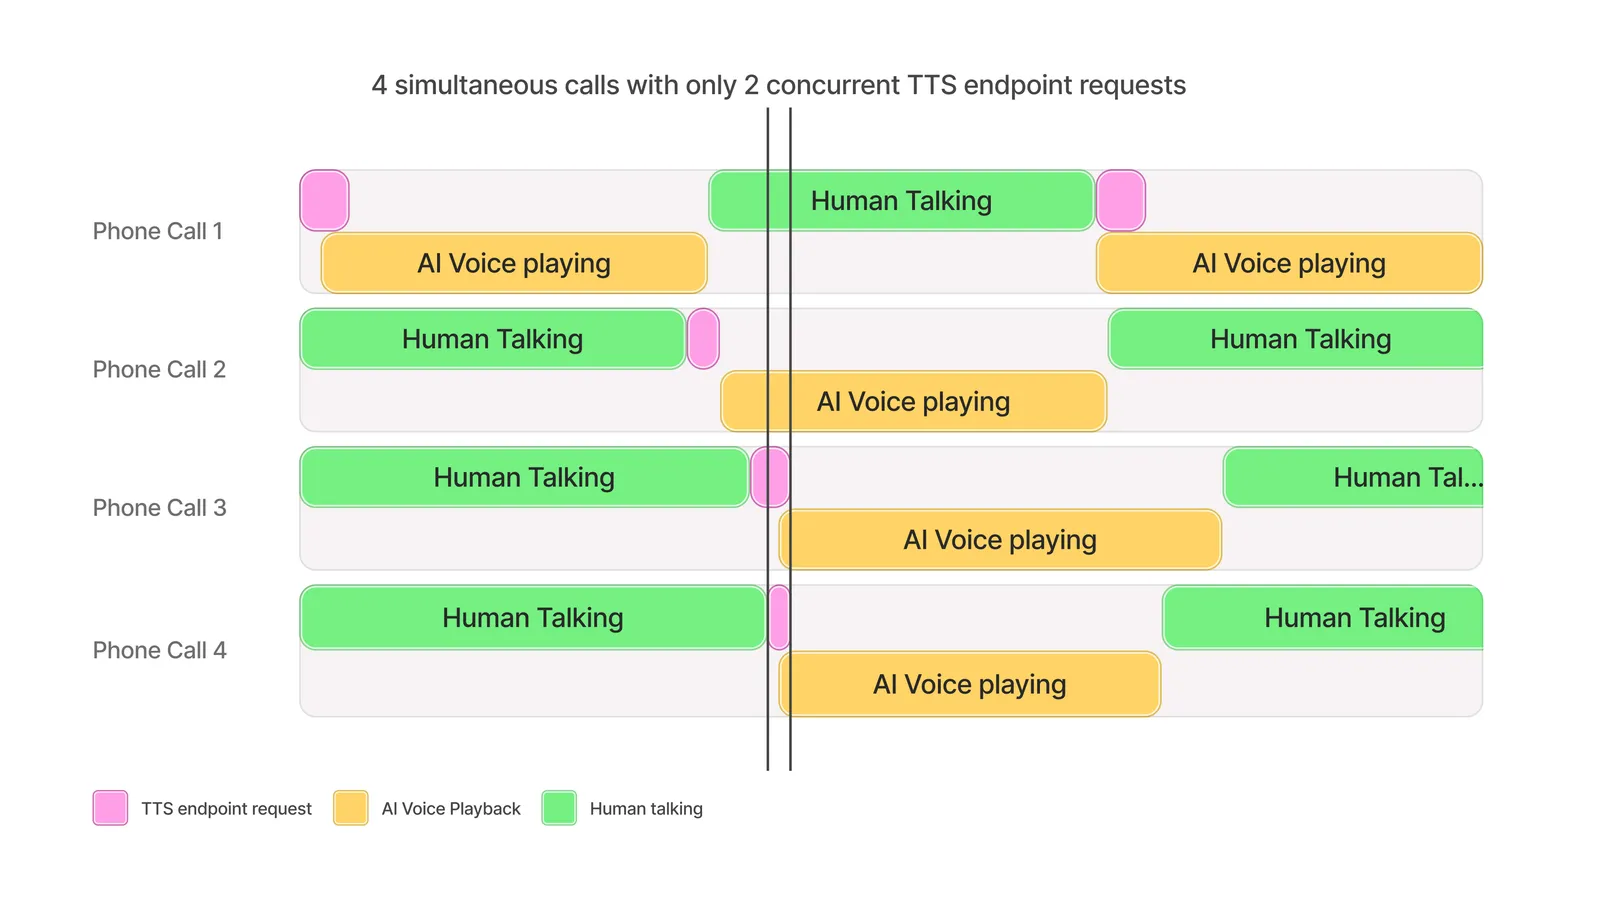
Creazione di agenti vocali IA
Quando il TTS viene usato per facilitare il dialogo, un limite di concorrenza pari a 5 può supportare circa 100 trasmissioni per conversazioni equilibrate tra agenti IA e partecipanti umani.
Per i casi d’uso in cui l’agente IA parla meno frequentemente dell’umano, come nelle interazioni con l’assistenza clienti, si possono supportare più di 100 conversazioni simultanee.
Voci fuori campo dei personaggi
In genere, con un limite di concorrenza pari a 5 si possono supportare più di 100 voci fuori campo di personaggi simultanee.
Il numero può variare in base alla frequenza dei dialoghi del personaggio, alla durata delle pause e alle azioni di gioco tra una battuta e l’altra.
Doppiaggio in diretta
Gli stream di doppiaggio simultanei seguono generalmente l’euristica fornita.
Se la trasmissione include periodi di pausa conversazionale (ad esempio a causa di una colonna sonora, scene visive e così via), potrebbero essere possibili più stream di doppiaggio simultanei rispetto a quanto suggerito.
Se in qualsiasi momento superi i limiti di concorrenza del tuo piano e hai il piano Enterprise, le richieste al modello potrebbero comunque riuscire, seppur più lentamente, in base alla capacità disponibile e secondo il principio del best effort.
Per aumentare il limite di concorrenza e la priorità in coda, passa a un piano di abbonamento superiore .
I clienti Enterprise possono richiedere un limite di concorrenza più elevato contattando il proprio account manager.
Concorrenza Text to Dialogue
Le richieste Text to Dialogue vengono misurate in due modi diversi, a seconda di come chiami l’API:
- Gli endpoint HTTP (Crea dialogo e Trasmetti dialogo) contano ai fini del limite di concorrenza standard del tuo piano mentre viene generato l’audio, come qualsiasi altra richiesta Text to Speech.
- Gli endpoint WebSocket, come il WebSocket Text to Dialogue, vengono misurati come sessioni di dialogo. Una connessione aperta occupa una sessione di dialogo per tutto il tempo in cui resta aperta, indipendentemente dal fatto che l’audio venga generato in quel momento.
La misurazione basata sulle sessioni semplifica la pianificazione della capacità: una connessione equivale a una sessione, quindi l’utilizzo non varia in base all’attività di generazione. Poiché una sessione viene mantenuta per l’intera connessione anziché solo durante la generazione dell’audio, i limiti delle sessioni di dialogo sono dimensionati per adattarsi a questa nuova metodologia di concorrenza.
Se apri una connessione mentre tutte le sessioni di dialogo del tuo workspace sono in uso, la nuova connessione viene rifiutata con un errore too_many_concurrent_requests. Per liberare le sessioni, chiudi le connessioni che non ti servono più: una connessione si chiude automaticamente anche dopo 20 secondi di inattività, a meno che tu non invii messaggi keep_alive.
Per monitorare le sessioni di dialogo, apri Sviluppatori in fondo alla barra laterale della dashboard, seleziona la scheda Analytics e visualizza la metrica Richieste simultanee nella vista Utilizzo. Le sessioni di dialogo vengono riportate come serie separata, Sessioni Websocket TTD, distinta dalle altre richieste simultanee.
Test di scalabilità dei limiti di concorrenza
I test di scalabilità possono essere utili per identificare problemi di scalabilità lato client e verificare che i limiti di concorrenza siano impostati correttamente per il tuo caso d’uso.
Consigliamo vivamente di testare workflow end-to-end il più possibile vicini all’utilizzo reale; la metodologia consigliata consiste nel simulare e misurare quanti utenti possono essere supportati. È importante:
- Simulare gli utenti, non le richieste grezze
- Simulare il comportamento tipico degli utenti, ad esempio attendere la riproduzione dell’audio, il parlato dell’utente o la fine della trascrizione prima di effettuare richieste
- Aumentare lentamente il numero di utenti nell’arco di alcuni minuti
- Introdurre casualità nelle tempistiche e nelle dimensioni delle richieste
- Acquisire le metriche di latenza e gli eventuali codici di errore restituiti dall’API
Ad esempio, per testare un sistema di agenti progettato per supportare 100 conversazioni simultanee, creeresti fino a 100 singoli “utenti”, ciascuno dei quali simula una conversazione. Le conversazioni consistono in genere in un ciclo ripetuto di ~10 secondi di parlato dell’utente, seguiti da una chiamata API TTS per ~150 caratteri, seguita da ~10 secondi di riproduzione audio per l’utente. Pertanto, ogni utente dovrebbe seguire il pattern di effettuare una chiamata API Text-to-Speech via websocket per 150 caratteri di testo ogni 20 secondi, introducendo una piccola quantità di casualità nel periodo di attesa e nel numero di caratteri richiesti. Il test consisterebbe nell’avviare un utente al secondo fino a raggiungere 100 utenti e poi eseguire il test per un totale di 10 minuti, per verificare la stabilità complessiva.
Esempio di script per test di scalabilità
Questo esempio usa locust come framework di test con chiamate API dirette all’API ElevenLabs.
Segue l’esempio riportato sopra, testando un sistema di agenti conversazionali in cui ogni utente invia 1 richiesta ogni 20 secondi.