

Modele
Modele flagowe
Text to Speech
Speech to Text
Muzyka
Przegląd modeli
API ElevenLabs oferuje wiele modeli audio zoptymalizowanych pod różne zastosowania, poziomy jakości i wymagania dotyczące wydajności.
Wycofane modele
Modele eleven_turbo_v2_5 i eleven_turbo_v2 są funkcjonalnie równoważne odpowiednio modelom
eleven_flash_v2_5 i eleven_flash_v2, z wyjątkiem tego, że modele Flash mają średnio niższe
opóźnienie. We wszystkich przypadkach zalecamy używać modeli Flash zamiast Turbo.
Eleven v4
Eleven v4 to nasz najnowocześniejszy model syntezy mowy, oferujący najwyższą jakość audio, ekspresję i kontrolę nad sposobem wypowiadania głosu. Eleven v4 obsługuje klonowanie głosu w wysokiej jakości z niezawodnym zachowaniem cech mówcy w długich generacjach tekstu.
Model sprawdza się w tych scenariuszach:
- Głosy postaci: Idealny do gier i animacji dzięki szerokiemu zakresowi emocji.
- Emocjonalne dialogi: Generuj naturalne, realistyczne dialogi o szerokim zakresie emocji i rozumieniu kontekstu.
- Produkcja audiobooków: Doskonały do długiej narracji o złożonym przekazie emocjonalnym.
- Projekty wielojęzyczne: Utrzymuje spójną jakość głosu przy zmianie języka.
Eleven v4 jest dostępny przez API Text to Dialogue.
Obsługiwane języki
Rodzina modeli Eleven v4 obsługuje ponad 90 języków, w tym:
Afrykanerski (afr), amharski (amh), arabski (ara), armeński (hye), asamski (asm), asturyjski (ast), azerski (aze), białoruski (bel), bengalski (ben), bośniacki (bos), bułgarski (bul), birmański (mya), kantoński (yue), kataloński (cat), cebuański (ceb), chorwacki (hrv), czeski (ces), duński (dan), niderlandzki (nld), angielski (eng), estoński (est), filipiński (fil), fiński (fin), francuski (fra), fula/pulaar (ful), galicyjski (glg), gruziński (kat), niemiecki (deu), grecki (ell), gudżaracki (guj), hausa (hau), hebrajski (heb), hindi (hin), węgierski (hun), islandzki (isl), indonezyjski (ind), włoski (ita), japoński (jpn), jawajski (jav), kamba (kam), kannada (kan), kazachski (kaz), koreański (kor), kirgiski (kir), laotański (lao), łotewski (lav), lingala (lin), litewski (lit), luganda (lug), luksemburski (ltz), macedoński (mkd), malajski (msa), malajalam (mal), maltański (mlt), mandaryński chiński (cmn), maoryski (mri), marathi (mar), mongolski (mon), nepalski (nep), norweski bokmål (nob), oksytański (oci), odia (ori), paszto (pus), perski (fas), polski (pol), portugalski, Brazylia (por), pendżabski (pan), rumuński (ron), rosyjski (rus), serbski (srp), shona (sna), sindhi (snd), słowacki (slk), słoweński (slv), somalijski (som), kurdyjski sorani (ckb), hiszpański, Ameryka Łacińska (spa), suahili (swa), szwedzki (swe), tadżycki (tgk), tamilski (tam), telugu (tel), tajski (tha), turecki (tur), ukraiński (ukr), urdu (urd), uzbecki (uzb), wietnamski (vie), walijski (cym), wolof (wol), zulu (zul).
Eleven v4 Turbo
Eleven v4 Turbo to nasz najnowocześniejszy model syntezy mowy w czasie rzeczywistym, oferujący wysoką jakość audio, ekspresję i kontrolę nad sposobem wypowiadania głosu. Eleven v4 Turbo obsługuje klonowanie głosu w wysokiej jakości i zapewnia wyniki przy medianie opóźnienia inferencji wynoszącej ~100 ms.
Model sprawdza się w tych scenariuszach:
- Agenci wsparcia: Twórz agentów głosowych, którzy w czasie rzeczywistym rozwiązują pytania klientów.
- Asystenci AI: Generuj naturalne, realistyczne dialogi o szerokim zakresie emocji i rozumieniu kontekstu.
- Interaktywne postaci: Świetny do doświadczeń audio z ekspresyjnymi postaciami.
Eleven v4 Turbo jest dostępny przez WebSocket Text to Dialogue.
Obsługiwane języki
Rodzina modeli Eleven v4 obsługuje ponad 90 języków, w tym:
Afrykanerski (afr), amharski (amh), arabski (ara), armeński (hye), asamski (asm), asturyjski (ast), azerski (aze), białoruski (bel), bengalski (ben), bośniacki (bos), bułgarski (bul), birmański (mya), kantoński (yue), kataloński (cat), cebuański (ceb), chorwacki (hrv), czeski (ces), duński (dan), niderlandzki (nld), angielski (eng), estoński (est), filipiński (fil), fiński (fin), francuski (fra), fula/pulaar (ful), galicyjski (glg), gruziński (kat), niemiecki (deu), grecki (ell), gudżaracki (guj), hausa (hau), hebrajski (heb), hindi (hin), węgierski (hun), islandzki (isl), indonezyjski (ind), włoski (ita), japoński (jpn), jawajski (jav), kamba (kam), kannada (kan), kazachski (kaz), koreański (kor), kirgiski (kir), laotański (lao), łotewski (lav), lingala (lin), litewski (lit), luganda (lug), luksemburski (ltz), macedoński (mkd), malajski (msa), malajalam (mal), maltański (mlt), mandaryński chiński (cmn), maoryski (mri), marathi (mar), mongolski (mon), nepalski (nep), norweski bokmål (nob), oksytański (oci), odia (ori), paszto (pus), perski (fas), polski (pol), portugalski, Brazylia (por), pendżabski (pan), rumuński (ron), rosyjski (rus), serbski (srp), shona (sna), sindhi (snd), słowacki (slk), słoweński (slv), somalijski (som), kurdyjski sorani (ckb), hiszpański, Ameryka Łacińska (spa), suahili (swa), szwedzki (swe), tadżycki (tgk), tamilski (tam), telugu (tel), tajski (tha), turecki (tur), ukraiński (ukr), urdu (urd), uzbecki (uzb), wietnamski (vie), walijski (cym), wolof (wol), zulu (zul).
Eleven v3
Eleven v3 to nasz model syntezy mowy poprzedniej generacji, który tworzy naturalną, realistyczną mowę o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach.
Eleven v3 oferuje nowe API Text to Dialogue, które pozwala generować naturalne, realistyczne dialogi o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach. Eleven v3 można też używać z API Text to Speech, aby generować naturalną, realistyczną mowę o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach.
Więcej o API Text to Dialogue przeczytasz tutaj.
Obsługiwane języki
Model Eleven v3 obsługuje ponad 70 języków, w tym:
Afrykanerski (afr), arabski (ara), armeński (hye), asamski (asm), azerski (aze), białoruski (bel), bengalski (ben), bośniacki (bos), bułgarski (bul), kataloński (cat), cebuański (ceb), cziczewa (nya), chorwacki (hrv), czeski (ces), duński (dan), niderlandzki (nld), angielski (eng), estoński (est), filipiński (fil), fiński (fin), francuski (fra), galicyjski (glg), gruziński (kat), niemiecki (deu), grecki (ell), gudżaracki (guj), hausa (hau), hebrajski (heb), hindi (hin), węgierski (hun), islandzki (isl), indonezyjski (ind), irlandzki (gle), włoski (ita), japoński (jpn), jawajski (jav), kannada (kan), kazachski (kaz), kirgiski (kir), koreański (kor), łotewski (lav), lingala (lin), litewski (lit), luksemburski (ltz), macedoński (mkd), malajski (msa), malajalam (mal), mandaryński chiński (cmn), marathi (mar), nepalski (nep), norweski (nor), paszto (pus), perski (fas), polski (pol), portugalski (por), pendżabski (pan), rumuński (ron), rosyjski (rus), serbski (srp), sindhi (snd), słowacki (slk), słoweński (slv), somalijski (som), hiszpański (spa), suahili (swa), szwedzki (swe), tamilski (tam), telugu (tel), tajski (tha), turecki (tur), ukraiński (ukr), urdu (urd), wietnamski (vie), walijski (cym).
Eleven v3 Conversational
Eleven v3 Conversational to nasz model syntezy mowy w czasie rzeczywistym poprzedniej generacji. Tworzy naturalną, realistyczną mowę o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach.
Eleven v3 Conversational oferuje nowy WebSocket Text to Dialogue, który pozwala generować naturalne, realistyczne dialogi o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach.
Eleven v3 Conversational oferuje nowy WebSocket Text to Dialogue, który pozwala generować naturalne, realistyczne dialogi o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach.
Więcej o WebSocket Text to Dialogue przeczytasz tutaj.
Obsługiwane języki
Model Eleven v3 obsługuje ponad 70 języków, w tym:
Afrykanerski (afr), arabski (ara), armeński (hye), asamski (asm), azerski (aze), białoruski (bel), bengalski (ben), bośniacki (bos), bułgarski (bul), kataloński (cat), cebuański (ceb), cziczewa (nya), chorwacki (hrv), czeski (ces), duński (dan), niderlandzki (nld), angielski (eng), estoński (est), filipiński (fil), fiński (fin), francuski (fra), galicyjski (glg), gruziński (kat), niemiecki (deu), grecki (ell), gudżaracki (guj), hausa (hau), hebrajski (heb), hindi (hin), węgierski (hun), islandzki (isl), indonezyjski (ind), irlandzki (gle), włoski (ita), japoński (jpn), jawajski (jav), kannada (kan), kazachski (kaz), kirgiski (kir), koreański (kor), łotewski (lav), lingala (lin), litewski (lit), luksemburski (ltz), macedoński (mkd), malajski (msa), malajalam (mal), mandaryński chiński (cmn), marathi (mar), nepalski (nep), norweski (nor), paszto (pus), perski (fas), polski (pol), portugalski (por), pendżabski (pan), rumuński (ron), rosyjski (rus), serbski (srp), sindhi (snd), słowacki (slk), słoweński (slv), somalijski (som), hiszpański (spa), suahili (swa), szwedzki (swe), tamilski (tam), telugu (tel), tajski (tha), turecki (tur), ukraiński (ukr), urdu (urd), wietnamski (vie), walijski (cym).
Multilingual v2
Eleven Multilingual v2 to model syntezy mowy poprzedniej generacji, rozpoznający emocje. Tworzy naturalną, realistyczną mowę o szerokim zakresie emocji i rozumieniu kontekstu w wielu językach.
Model zapewnia spójną jakość i osobowość głosu we wszystkich obsługiwanych językach, zachowując unikalne cechy i akcent mówcy.
Ten model świetnie sprawdza się tam, gdzie potrzebna jest wysokiej jakości mowa z niuansami emocjonalnymi:
- Głosy postaci: Idealny do gier i animacji dzięki szerokiemu zakresowi emocji.
- Profesjonalne treści: Dobrze nadaje się do filmów firmowych i materiałów e-learningowych.
- Projekty wielojęzyczne: Utrzymuje spójną jakość głosu przy zmianie języka.
- Stabilna jakość: Tworzy spójne audio wysokiej jakości.
Ma wyższe opóźnienie i koszt na znak niż modele Flash, ale zapewnia lepszą jakość w projektach, gdzie ważna jest realistyczna mowa.
Nasze wielojęzyczne modele v2 obsługują 29 języków:
angielski (USA, Wielka Brytania, Australia, Kanada), japoński, chiński, niemiecki, hindi, francuski (Francja, Kanada), koreański, portugalski (Brazylia, Portugalia), włoski, hiszpański (Hiszpania, Meksyk), indonezyjski, niderlandzki, turecki, filipiński, polski, szwedzki, bułgarski, rumuński, arabski (Arabia Saudyjska, ZEA), czeski, grecki, fiński, chorwacki, malajski, słowacki, duński, tamilski, ukraiński i rosyjski.
Flash v2.5
Eleven Flash v2.5 to nasz najszybszy model syntezy mowy, stworzony do aplikacji czasu rzeczywistego i Agents Platform. Oferuje wysokiej jakości mowę z ultraniskim opóźnieniem (~75ms†) w 32 językach.
Model równoważy szybkość i jakość, więc idealnie nadaje się do aplikacji interaktywnych, zachowując naturalne brzmienie i spójne cechy głosu w różnych językach.
Ten model szczególnie dobrze nadaje się do:
- Agents Platform: Idealny do agentów głosowych i chatbotów działających w czasie rzeczywistym.
- Aplikacji interaktywnych: Idealny do gier i aplikacji wymagających natychmiastowej odpowiedzi.
- Przetwarzania na dużą skalę: Wydajny przy masowej zamianie tekstu na mowę.
Dzięki niższej cenie generowania przez API i opóźnieniu 75 ms Flash v2.5 jest opłacalną opcją dla każdego, kto potrzebuje szybkiej i niezawodnej syntezy mowy w wielu językach.
Flash v2.5 obsługuje 32 języki — wszystkie języki z modeli v2 oraz:
węgierski, norweski i wietnamski
† Bez opóźnień aplikacji i sieciUwagi
Normalizacja tekstu z liczbami
W Flash v2.5 liczby domyślnie nie są normalizowane tak, jak możesz się spodziewać. Na przykład numery telefonów mogą być odczytywane w sposób niejasny dla użytkownika. Podobnie jest z datami i walutami.
Domyślnie normalizacja jest wyłączona w Flash v2.5, aby zachować niskie opóźnienie. Klienci Enterprise mogą jednak włączyć normalizację tekstu dla modeli v2.5, ustawiając w żądaniu parametr apply_text_normalization na „on”.
Model Multilingual v2 lepiej normalizuje liczby, dlatego zalecamy go do numerów telefonów i innych przypadków, w których normalizacja liczb jest ważna.
W aplikacjach o niskim opóźnieniu lub Agents Platform warto, aby LLM znormalizował tekst przed przekazaniem go do modelu TTS, albo użyć parametru apply_text_normalization (tylko plany Enterprise dla modeli v2.5).
Przewodnik wyboru modelu
Aby dowiedzieć się, który model najlepiej pasuje do twoich wymagań i zastosowania, zobacz przewodnik wyboru modelu.
Wymagania
Zastosowanie
Limity znaków
Maksymalna liczba znaków obsługiwana w pojedynczym żądaniu zamiany tekstu na mowę zależy od modelu.
Scribe v2
Scribe v2 to nasz najnowocześniejszy model rozpoznawania mowy, zaprojektowany do dokładnej transkrypcji w ponad 90 językach. Zapewnia precyzyjne znaczniki czasu na poziomie słów oraz zaawansowane funkcje, takie jak diarizacja mówców i dynamiczne tagowanie audio.
Ten model sprawdza się w sytuacjach wymagających dokładnej zamiany mowy na tekst:
- Usługi transkrypcji: Idealny do zamiany treści audio/wideo na tekst
- Dokumentacja spotkań: Ułatwia rejestrowanie i dokumentowanie rozmów
- Analiza treści: Dobrze nadaje się do przetwarzania i analizy treści audio
- Rozpoznawanie wielu języków: Obsługuje dokładną transkrypcję w ponad 90 językach
Najważniejsze funkcje:
- Dokładna transkrypcja ze znacznikami czasu na poziomie słów
- Diarizacja mówców w nagraniach z wieloma osobami
- Dynamiczne tagowanie audio dla lepszego kontekstu
- Obsługa ponad 90 języków
- Wykrywanie encji
- Podpowiadanie kluczowych terminów
- Edycja transkrypcji
Więcej o Scribe v2 przeczytasz tutaj.
Scribe v2 Realtime
Scribe v2 Realtime, nasz najszybszy i najdokładniejszy model rozpoznawania mowy na żywo, zapewnia najwyższą dokładność w ponad 90 językach przy bardzo niskim opóźnieniu 150 ms.
Ten model świetnie sprawdza się w rozmowach:
- Transkrypcja spotkań na żywo: Idealny do transkrypcji w czasie rzeczywistym
- Agenci AI: Idealny do rozmów na żywo
- Rozpoznawanie wielu języków: Obsługuje dokładną transkrypcję w ponad 90 językach z automatycznym wykrywaniem języka
Najważniejsze funkcje:
- Bardzo niskie opóźnienie: częściową transkrypcję otrzymasz w około 150 milisekund
- Obsługa streamingu: wysyłaj audio w fragmentach i odbieraj transkrypcje w czasie rzeczywistym
- Wiele formatów audio: obsługa PCM (od 8 kHz do 48 kHz) i kodowania μ-law
- Voice Activity Detection (VAD): automatyczne dzielenie mowy na segmenty na podstawie wykrywania ciszy
- Ręczne zatwierdzanie: pełna kontrola nad tym, kiedy finalizować segmenty transkrypcji
- Wykrywanie encji
- Edycja transkrypcji
Więcej o Scribe v2 Realtime przeczytasz tutaj.
Scribe v2 Medical
Scribe v2 Medical to wsadowy model rozpoznawania mowy wyspecjalizowany w nagraniach medycznych i klinicznych. To wersja Finetune Scribe v2, która lepiej rozpoznaje nazwy leków, anatomię, patologię i dyktowanie kliniczne, zachowując dokładność Scribe v2 dla codziennej mowy. Korzysta z tego samego API zamiany mowy na tekst co Scribe v2 i jest rozliczany w tej samej stawce. Przekaż scribe_v2_medical jako model_id.
Przeznaczenie
Scribe v2 Medical to wsadowy model Speech-to-Text API dla deweloperów i organizacji, które chcą zintegrować go z aplikacjami zamieniającymi nagrania kliniczne, w tym rozmowy lekarz-pacjent, dyktowanie, rozmowy przy przyjęciu i koordynacji opieki, w robocze transkrypcje do dokumentacji i powiązanych procesów administracyjnych. Powstały tekst wymaga weryfikacji i korekty przez pracownika ochrony zdrowia lub innego upoważnionego użytkownika przed użyciem. Scribe v2 Medical nie służy do interpretacji informacji klinicznych ani udzielania diagnoz, zaleceń terapeutycznych, podejmowania decyzji klinicznych czy innych wskazówek klinicznych.
Ten model dobrze nadaje się do:
- Dokumentacji klinicznej: Wizyt i notatek, w których terminy medyczne pojawiają się w trakcie rozmowy
- Dyktowania: Gęstych sekwencji nazw leków, dawek i ustaleń
- Rozmów przy przyjęciu i koordynacji opieki: Pacjenci opisują własne dolegliwości, często przez telefon
- Procesów zgodności: Połącz z wykrywaniem encji, aby wykrywać kategorie PHI
Najważniejsze funkcje:
- Taki sam format żądania jak w Scribe v2 (
keyterms,entity_detection,no_verbatim, diarizacja, znaczniki czasu) - Lepsze rozpoznawanie nazw leków oraz terminów anatomicznych i patologicznych
- Bez pogorszenia wyników dla codziennej mowy względem Scribe v2
- Obsługa ponad 90 języków
- Diarizacja mówców w nagraniach z wieloma osobami
- Dynamiczne tagowanie audio
- Wykrywanie encji, w tym kategorii PHI
Scribe v2 Medical to model wsadowy. Do transkrypcji na żywo użyj Scribe v2 Realtime.
Scribe v2 Medical kwalifikuje się do HIPAA. Klienci Enterprise mogą podpisać Business Associate Agreement oraz korzystać z Zero Retention Mode (ZRM). Po włączeniu ZRM wejściowe audio i wyjściowy tekst są usuwane natychmiast po zakończeniu każdego żądania. ElevenLabs niczego nie przechowuje, a twoja aplikacja otrzymuje pełną odpowiedź API i przechowuje transkrypcje pod własną kontrolą.
Firmy wymagające zgodności z HIPAA muszą skontaktować się z działem sprzedaży ElevenLabs Sales, aby podpisać Business Associate Agreement (BAA), zanim prześlą chronione informacje zdrowotne.
Więcej o zamianie mowy na tekst przeczytasz tutaj.
Eleven Music
Eleven Music to nasz model generowania muzyki o jakości studyjnej. Pozwala tworzyć muzykę w dowolnym stylu na podstawie poleceń w języku naturalnym.
Ten model świetnie sprawdza się w tych sytuacjach:
- Ścieżki dźwiękowe do gier: Twórz wciągające ścieżki dźwiękowe do gier
- Tło do podcastów: Wzbogać podcasty profesjonalną muzyką
- Marketing: Dodaj muzykę w tle do rolek reklamowych
Najważniejsze funkcje:
- Pełna kontrola nad gatunkiem, stylem i strukturą
- Wokal lub sama muzyka instrumentalna
- Wiele języków, w tym angielski, hiszpański, niemiecki, japoński i inne
- Edytuj brzmienie i tekst pojedynczych części lub całego utworu
Więcej o Eleven Music przeczytasz tutaj.
Współbieżność i priorytet
Twój plan subskrypcji określa, ile żądań może być przetwarzanych jednocześnie oraz jaki priorytet mają twoje żądania w kolejce. Speech to Text ma wyższy limit współbieżności. Po osiągnięciu limitu współbieżności kolejne żądania są przetwarzane w kolejce razem z żądaniami o niższym priorytecie. W praktyce zwykle dodaje to tylko około 50 ms opóźnienia.
Nagłówki odpowiedzi zawierają current-concurrent-requests i maximum-concurrent-requests, których możesz używać do monitorowania współbieżności.
Żądania API na minutę a żądania współbieżne
Ważne, by rozumieć, że żądania API na minutę i żądania współbieżne to różne metryki, które zależą od sposobu użycia.
Liczba żądań API na minutę może różnić się od liczby żądań współbieżnych, ponieważ zależy od czasu trwania każdego żądania i sposobu ich grupowania.
Przykład 1: Żądania rozłożone w czasie Jeśli masz 180 żądań na minutę, z których każde trwa 1 sekundę, i wysyłasz je co 0,33 sekundy, maksymalna i średnia liczba żądań współbieżnych wyniesie 3, ponieważ zawsze będą przetwarzane 3 żądania.
Przykład 2: Żądania grupowane Jeśli jednak masz inny schemat użycia, na przykład 180 żądań na minutę, z których każde trwa 3 sekundy, ale wszystkie są wysyłane naraz, maksymalna liczba żądań współbieżnych wyniesie 180, a średnia 9 (w pierwszych 3 sekundach minuty było naraz 180 żądań, a przez ostatnie 57 sekund 0 żądań).
Ponieważ nasz system uwzględnia współbieżność, liczba żądań na minutę ma mniejsze znaczenie niż czas trwania każdego żądania i schemat ich wysyłania.
Sposób wysyłania żądań do endpointów wpływa na limity współbieżności:
- W HTTP każde żądanie liczy się osobno do limitu współbieżności.
- W WebSocket Text to Speech do limitu współbieżności liczy się tylko czas, w którym nasz model generuje audio. Oznacza to, że przez większość czasu otwarty websocket w ogóle nie liczy się do limitu współbieżności.
- WebSockety Text to Dialogue działają inaczej: każde otwarte połączenie rezerwuje jedną sesję dialogową z oddzielnej puli, tak długo jak pozostaje otwarte, a audio generowane przez połączenie nie liczy się do standardowego limitu współbieżności. Ułatwia to planowanie: jedno połączenie to jedna sesja, a limity sesji dialogowych są dostosowane do tej nowej metody współbieżności. Zobacz współbieżność Text to Dialogue.
Jak rozumieć limity współbieżności
Limit współbieżności związany z twoim planem nie oznacza maksymalnej liczby jednoczesnych rozmów, połączeń telefonicznych, nałożonych głosów postaci itd., które można obsłużyć naraz. Rzeczywista liczba zależy od kilku czynników, w tym użytych głosów AI i charakterystyki przypadku użycia.
Ogólnie limit współbieżności 5 zwykle pozwala obsłużyć około 100 jednoczesnych transmisji audio.
Wynika to z szybkości generowania audio względem czasu przetwarzania żądania TTS. Poniższy diagram pokazuje przykład obsługi 4 równoczesnych połączeń z różnymi użytkownikami przy zaledwie 2 współbieżnych żądaniach.
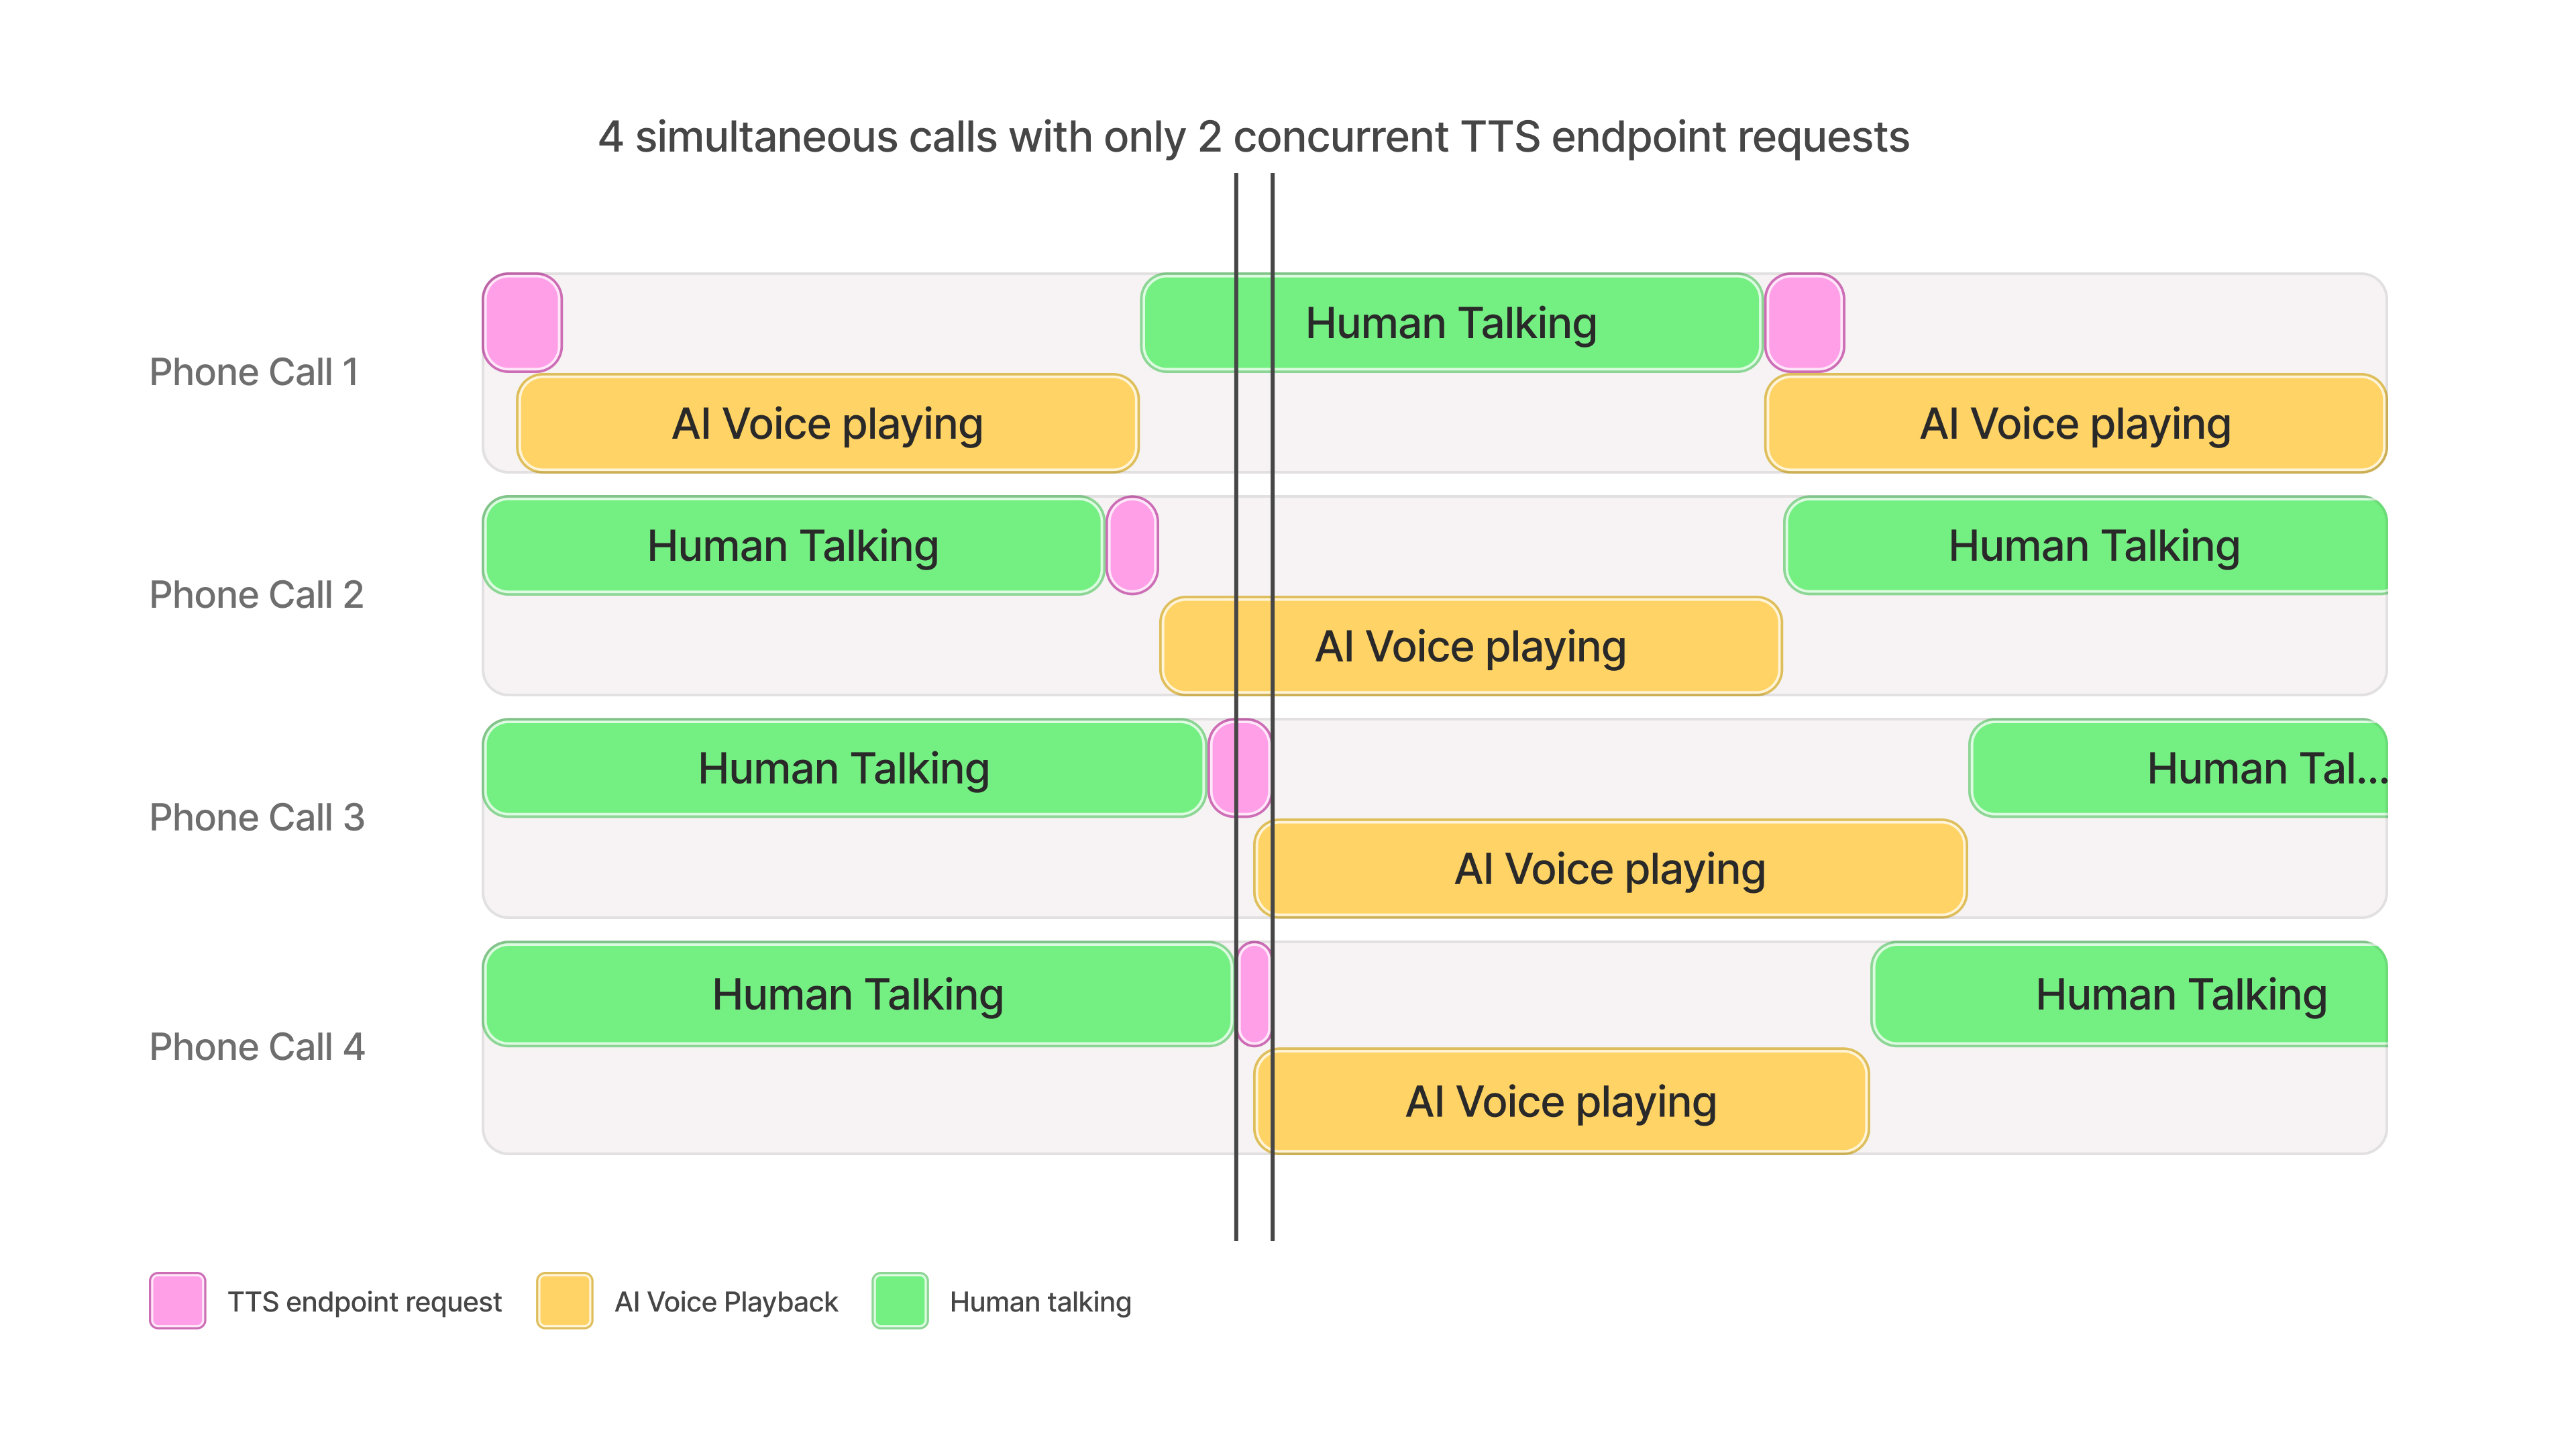
Tworzenie agentów głosowych AI
Gdy TTS służy do prowadzenia dialogu, limit współbieżności 5 może obsłużyć około 100 transmisji przy zrównoważonych rozmowach między agentami AI a ludźmi.
W przypadkach, gdy agent AI mówi rzadziej niż człowiek, takich jak interakcje z obsługą klienta, można obsłużyć ponad 100 jednoczesnych rozmów.
Nałożone głosy postaci
Ogólnie limit współbieżności 5 pozwala obsłużyć ponad 100 jednoczesnych nałożonych głosów postaci.
Liczba może się różnić zależnie od częstotliwości wypowiedzi postaci, długości pauz i działań w grze między kwestiami.
Dubbing na żywo
Równoczesne strumienie dubbingu zwykle odpowiadają podanej zasadzie.
Jeśli transmisja obejmuje okresy pauz w rozmowie (np. z powodu ścieżki dźwiękowej, scen wizualnych itp.), możliwa może być większa liczba jednoczesnych strumieni dubbingu niż sugerowana.
Jeśli w dowolnym momencie przekroczysz limity współbieżności swojego planu i korzystasz z planu Enterprise, żądania modelu mogą nadal się powieść, choć wolniej, w miarę dostępnej pojemności.
Aby zwiększyć limit współbieżności i priorytet w kolejce, ulepsz swój plan subskrypcji.
Klienci Enterprise mogą poprosić o wyższy limit współbieżności, kontaktując się ze swoim opiekunem konta.
Współbieżność Text to Dialogue
Żądania Text to Dialogue są rozliczane na dwa różne sposoby, zależnie od tego, jak wywołujesz API:
- Endpointy HTTP (Utwórz dialog i Streamuj dialog) liczą się do standardowego limitu współbieżności twojego planu podczas generowania audio, jak każde inne żądanie Text to Speech.
- Endpointy WebSocket, takie jak WebSocket Text to Dialogue, są rozliczane jako sesje dialogowe. Otwarte połączenie zajmuje sesję dialogową, dopóki pozostaje otwarte, niezależnie od tego, czy audio jest aktualnie generowane.
Rozliczanie oparte na sesjach ułatwia planowanie pojemności: jedno połączenie to jedna sesja, więc wykorzystanie nie zmienia się wraz z aktywnością generowania. Ponieważ sesja jest zajęta przez cały czas połączenia, a nie tylko podczas generowania audio, limity sesji dialogowych są dostosowane do tej nowej metody współbieżności.
Jeśli otworzysz połączenie, gdy wszystkie sesje dialogowe w twoim workspace są używane, nowe połączenie zostanie odrzucone z błędem too_many_concurrent_requests. Aby zwolnić sesje, zamknij niepotrzebne połączenia — połączenie zamyka się też automatycznie po 20 sekundach bezczynności, chyba że wysyłasz komunikaty keep_alive.
Aby monitorować sesje dialogowe, otwórz Developers na dole paska bocznego panelu, wybierz kartę Analytics i sprawdź metrykę Concurrent requests w widoku Usage. Sesje dialogowe są raportowane jako osobna seria, TTD Websocket Sessions, niezależnie od pozostałych współbieżnych żądań.
Testowanie limitów współbieżności na skalę
Testowanie na skalę może pomóc wykryć problemy ze skalowaniem po stronie klienta i sprawdzić, czy limity współbieżności są poprawnie ustawione dla twojego przypadku użycia.
Zdecydowanie zalecamy testowanie workflow end-to-end jak najbliżej rzeczywistego użycia. Zalecaną metodą jest symulowanie i mierzenie liczby obsługiwanych użytkowników. Ważne, aby:
- Symulować użytkowników, a nie same żądania
- Symulować typowe zachowania użytkowników, takie jak czekanie na odtworzenie audio, wypowiedź użytkownika lub zakończenie transkrypcji przed wysłaniem żądania
- Powoli zwiększać liczbę użytkowników przez kilka minut
- Wprowadzać losowość w czasie wysyłania i rozmiarze żądań
- Rejestrować metryki opóźnień oraz wszelkie kody błędów zwracane przez API
Na przykład, aby przetestować system agentów zaprojektowany do obsługi 100 jednoczesnych rozmów, utwórz do 100 osobnych „użytkowników”, z których każdy symuluje rozmowę. Rozmowy zwykle składają się z powtarzalnego cyklu: około 10 sekund mówienia użytkownika, potem wywołanie TTS API dla około 150 znaków, a następnie około 10 sekund odtwarzania audio użytkownikowi. Dlatego każdy użytkownik powinien co 20 sekund wykonywać wywołanie API Text-to-Speech przez websocket dla 150 znaków tekstu, z niewielką losowością w czasie oczekiwania i liczbie żądanych znaków. Test polegałby na uruchamianiu jednego użytkownika na sekundę, aż będzie ich 100, a następnie na testowaniu przez łącznie 10 minut, aby sprawdzić ogólną stabilność.
Przykładowy skrypt testowania na skalę
Ten przykład używa locust jako frameworka testowego z bezpośrednimi wywołaniami API ElevenLabs.
Jest zgodny z powyższym przykładem i testuje system agenta konwersacyjnego, w którym każdy użytkownik wysyła 1 żądanie co 20 sekund.