

रिट्रीवल-ऑगमेंटेड जेनरेशन
रिट्रीवल-ऑगमेंटेड जेनरेशन
RAG का इस्तेमाल करके बड़े नॉलेज बेस से अपने एजेंट को बेहतर बनाएं।
अवलोकन
रिट्रीवल-ऑगमेंटेड जेनरेशन (RAG) आपके एजेंट को बातचीत के दौरान बड़े नॉलेज बेस तक पहुंचने और उनका इस्तेमाल करने देता है। पूरे दस्तावेज़ों को कॉन्टेक्स्ट विंडो में लोड करने के बजाय, RAG हर यूज़र क्वेरी के लिए सिर्फ़ सबसे प्रासंगिक जानकारी रिट्रीव करता है, जिससे आपका एजेंट:
- किसी प्रॉम्प्ट में समा सकने वाले नॉलेज बेस से कहीं बड़े नॉलेज बेस तक पहुंच सकता है
- ज़्यादा सटीक, जानकारी पर आधारित जवाब दे सकता है
- स्रोत सामग्री का संदर्भ देकर हैलुसिनेशन कम कर सकता है
- कई विशेष एजेंट बनाए बिना जानकारी को स्केल कर सकता है
RAG उन एजेंट्स के लिए आदर्श है जिन्हें बड़े दस्तावेज़ों, तकनीकी मैनुअल या विस्तृत नॉलेज बेस का संदर्भ देना होता है, जो पारंपरिक प्रॉम्प्टिंग की कॉन्टेक्स्ट विंडो सीमाओं से अधिक हों। RAG आपके एजेंट के रिस्पॉन्स टाइम में लगभग 250ms की हल्की देरी जोड़ता है।
यह वीडियो डैशबोर्ड के पुराने वर्शन के साथ रिकॉर्ड किया गया था। RAG कॉन्फ़िगरेशन के चरण वही हैं, लेकिन इंटरफ़ेस के कुछ एलिमेंट्स अलग दिख सकते हैं।
RAG कैसे काम करता है
RAG सक्षम होने पर, आपका एजेंट इन चरणों के ज़रिए यूज़र क्वेरी प्रोसेस करता है:
- क्वेरी प्रोसेसिंग: यूज़र के सवाल का विश्लेषण किया जाता है और बेहतर रिट्रीवल के लिए उसे फिर से तैयार किया जाता है।
- एम्बेडिंग जनरेशन: प्रोसेस की गई क्वेरी को एक वेक्टर एम्बेडिंग में बदला जाता है, जो यूज़र के सवाल को दर्शाती है।
- रिट्रीवल: सिस्टम आपके नॉलेज बेस से अर्थ के हिसाब से सबसे मिलता-जुलता कॉन्टेंट खोजता है।
- रिस्पॉन्स जनरेशन: एजेंट बातचीत के कॉन्टेक्स्ट और रिट्रीव की गई जानकारी, दोनों का इस्तेमाल करके जवाब तैयार करता है।
यह प्रक्रिया सुनिश्चित करती है कि यूज़र की क्वेरी से संबंधित जानकारी तथ्यात्मक रूप से सही जवाब बनाने के लिए LLM को भेजी जाए।
गाइड
ज़रूरी शर्तें
- एक ElevenLabs अकाउंट
- कॉन्फ़िगर किया गया ElevenLabs कन्वर्सेशनल एजेंट
- आपके एजेंट के नॉलेज बेस में जोड़ा गया कम से कम एक दस्तावेज़
अपने एजेंट के लिए RAG सक्षम करें
डैशबोर्ड से अपडेट करें
CLI से अपडेट करें
API से अपडेट करें
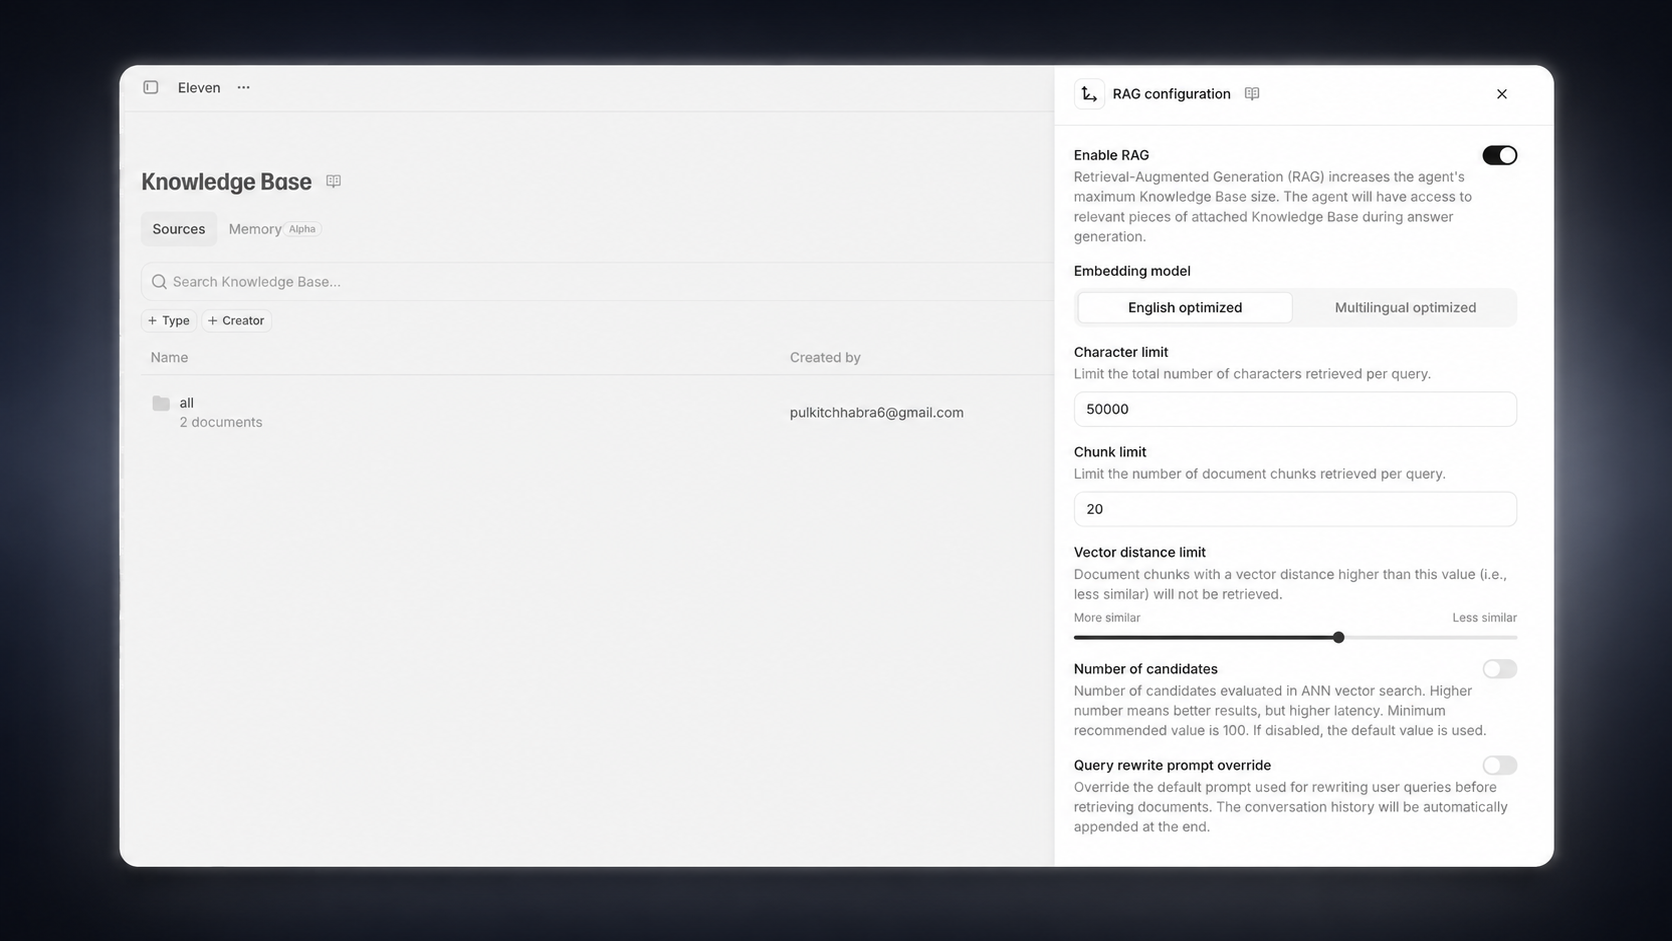
अपने एजेंट की सेटिंग्स में Knowledge Base सेक्शन पर जाएं और Use RAG विकल्प को चालू करें। ज़रूरत के अनुसार Advanced टैब में एम्बेडिंग मॉडल, अधिकतम डॉक्यूमेंट चंक्स और अधिकतम वेक्टर डिस्टेंस कॉन्फ़िगर करें।
नॉलेज बेस इंडेक्सिंग
आपके नॉलेज बेस के हर दस्तावेज़ को RAG के साथ इस्तेमाल करने से पहले इंडेक्स करना होगा। यह प्रक्रिया RAG सक्षम एजेंट में दस्तावेज़ जोड़ने पर अपने-आप होती है।
बड़े दस्तावेज़ों की इंडेक्सिंग में कुछ मिनट लग सकते हैं। आप इंडेक्सिंग स्टेटस को नॉलेज बेस सूची में देख सकते हैं।
दस्तावेज़ उपयोग मोड कॉन्फ़िगर करें (वैकल्पिक)
अपने नॉलेज बेस के हर दस्तावेज़ के लिए, आप चुन सकते हैं कि उसका इस्तेमाल कैसे हो:
- Auto (डिफ़ॉल्ट): दस्तावेज़ सिर्फ़ क्वेरी से संबंधित होने पर रिट्रीव किया जाता है
- Prompt: प्रासंगिकता की परवाह किए बिना दस्तावेज़ को हमेशा सिस्टम प्रॉम्प्ट में शामिल किया जाता है
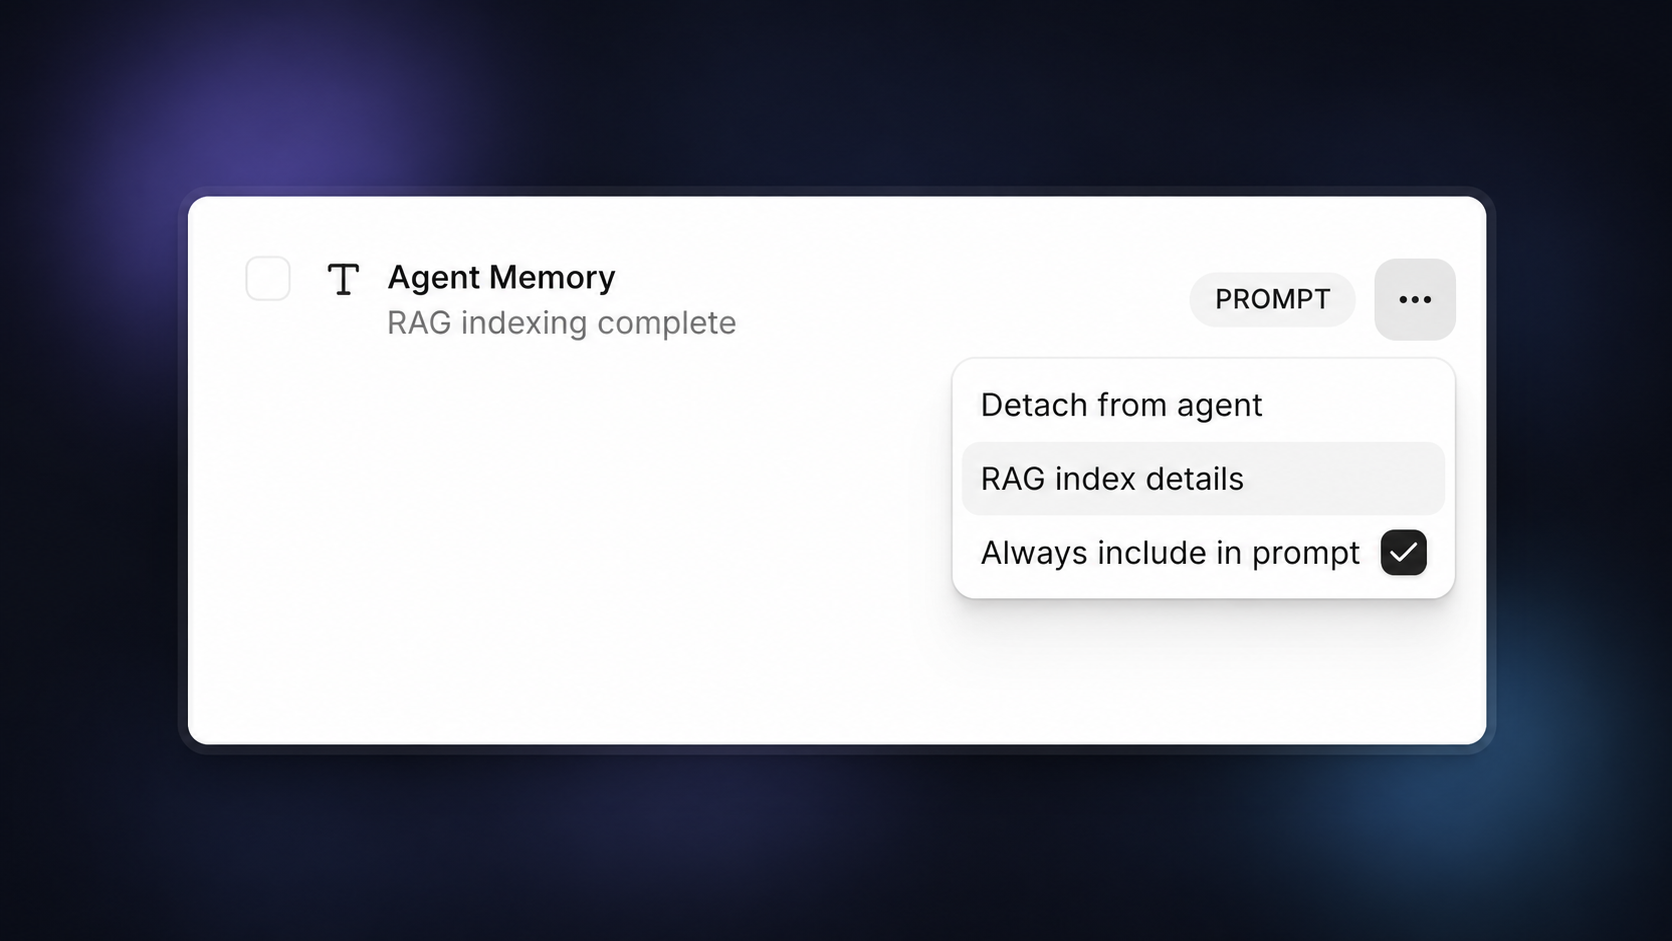
बहुत ज़्यादा दस्तावेज़ों को “Prompt” मोड पर सेट करने से कॉन्टेक्स्ट सीमाएं पार हो सकती हैं। इस विकल्प का इस्तेमाल महत्वपूर्ण जानकारी के लिए सीमित रूप से करें।
अपने RAG-सक्षम एजेंट का परीक्षण करें
कॉन्फ़िगरेशन सेव करने के बाद, अपने नॉलेज बेस से जुड़े सवाल पूछकर अपने एजेंट का परीक्षण करें। अब एजेंट आपके दस्तावेज़ों से विशेष जानकारी रिट्रीव और संदर्भित कर पाएगा।
उपयोग सीमाएं
संसाधनों का निष्पक्ष आवंटन सुनिश्चित करने के लिए, ElevenLabs सब्सक्रिप्शन टियर के आधार पर हर वर्कस्पेस के लिए RAG हेतु इंडेक्स किए जा सकने वाले दस्तावेज़ों के कुल आकार की सीमा लागू करता है।
सीमाएं इस प्रकार हैं:
नोट:
- ये सीमाएं RAG के लिए इंडेक्स किए गए दस्तावेज़ों के कुल मूल फ़ाइल आकार पर लागू होती हैं, न कि RAG इंडेक्स के आंतरिक स्टोरेज आकार पर (जो काफ़ी बड़ा हो सकता है)।
- 500 बाइट्स से छोटे दस्तावेज़ों को RAG के लिए इंडेक्स नहीं किया जा सकता और उनके बजाय उन्हें अपने-आप प्रॉम्प्ट में इस्तेमाल किया जाएगा।
API इम्प्लीमेंटेशन
आप API के ज़रिए भी RAG इम्प्लीमेंट कर सकते हैं: