

オーディオブック
オーディオブック
エンドツーエンドのワークフローで、書かれたコンテンツをスタジオ品質のオーディオに変換
概要
オーディオブックは、書かれたコンテンツをスタジオ品質のオーディオに変換するためのエンドツーエンドのワークフローを提供します。
原稿を貼り付けるかアップロードし、ElevenLabsの音声を使って自然なナレーションを生成し、チャプターでプロジェクトを構成できます。音楽やサウンドエフェクトでオーディオブックを強化し、エディターでナレーションを直接編集・調整できます。
キャラクターキャスティングは原稿内の登場人物を検出し、それぞれに音声を提案して、本の実際のセリフでプレビューできます。登場人物の音声を変更すると、その人物のすべてのセリフが本全体で更新されます。
完成後は、オーディオブックをエクスポートするか、ElevenReaderや提携マーケットプレイスなどのリスニングプラットフォームに直接公開できます。
オーディオブックはダイナミックナレーションにも対応しています。このモードでは、リスナーが再生中に好みの音声を選択できます。
ガイド
ファイルをアップロードして基本設定を選択
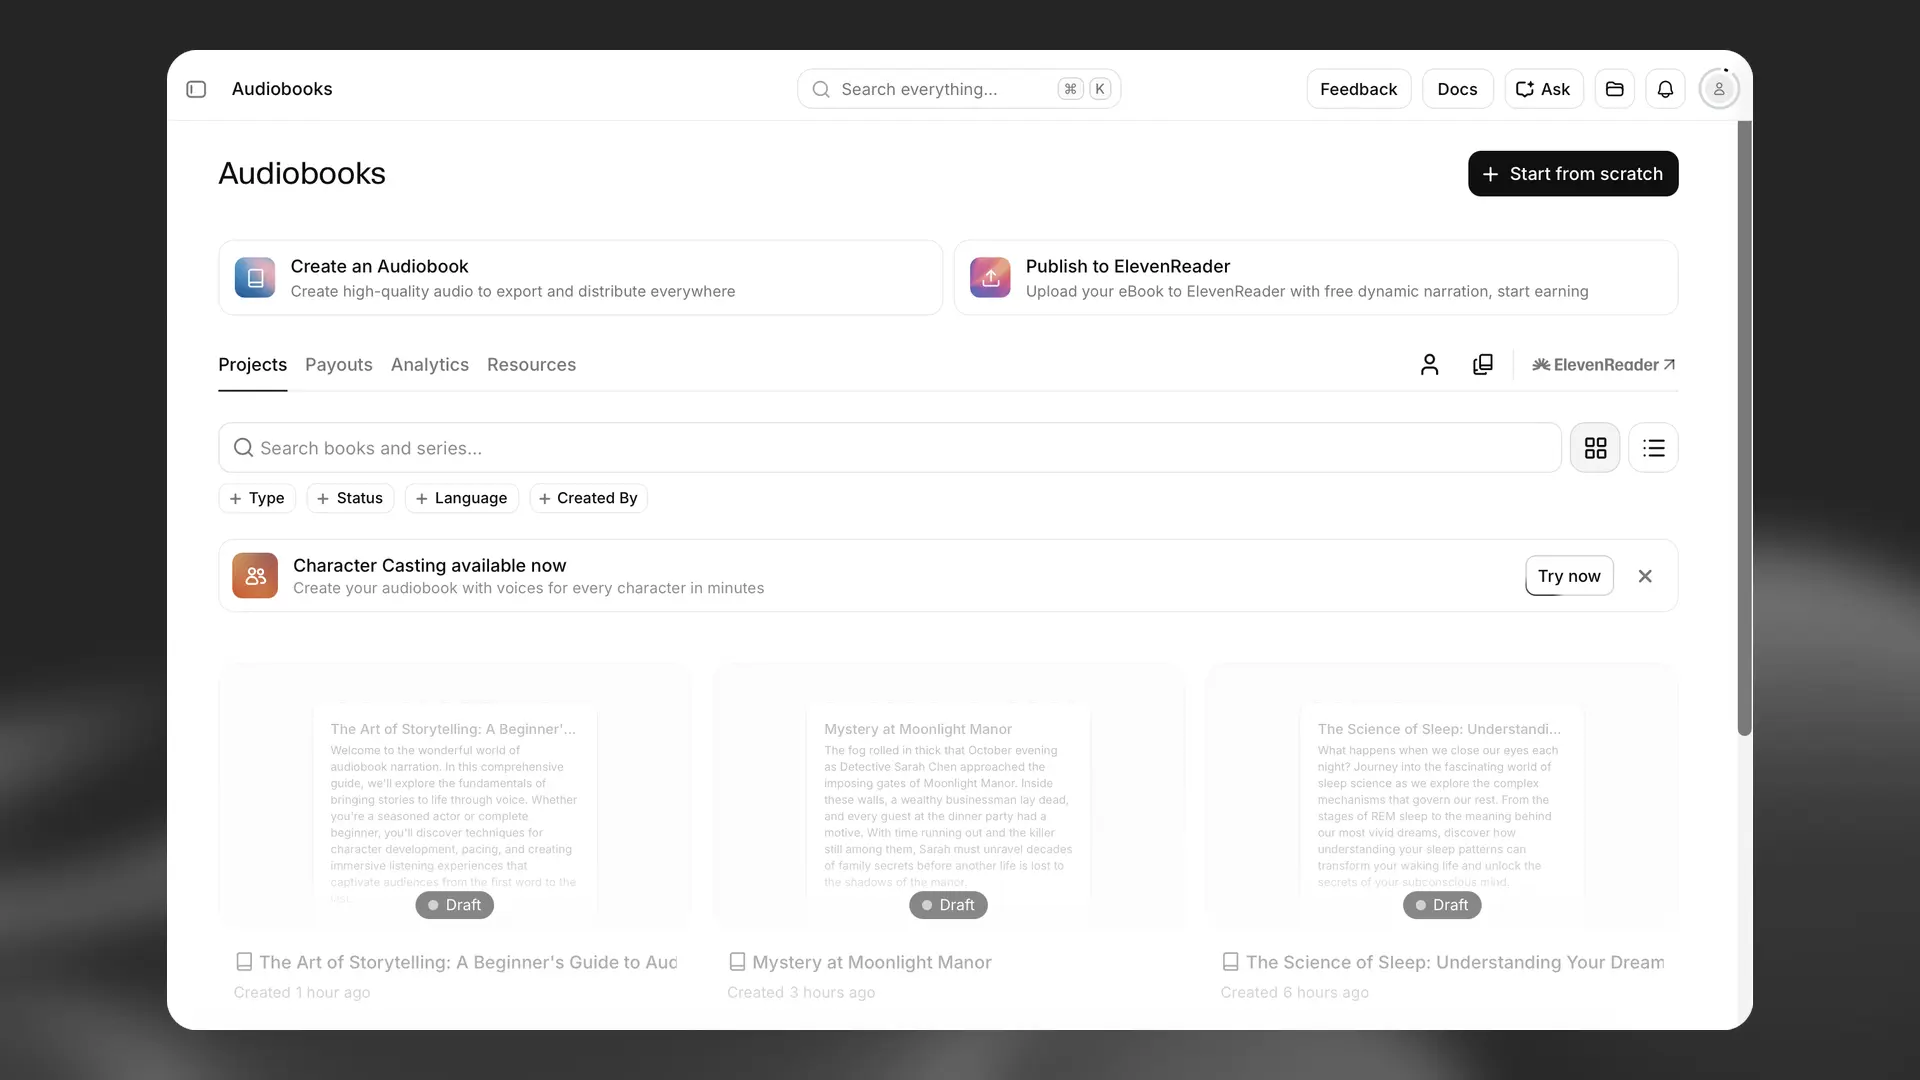
オーディオブックページで Create an Audiobook を選択し、新しいプロジェクトを開始します。
原稿をアップロード
原稿をアップロードエリアにドラッグ&ドロップするか、デバイスを参照してファイルを選択します。現在、オーディオブックでは以下をサポートしています。
- EPUB
ナレーションスタイルを選択
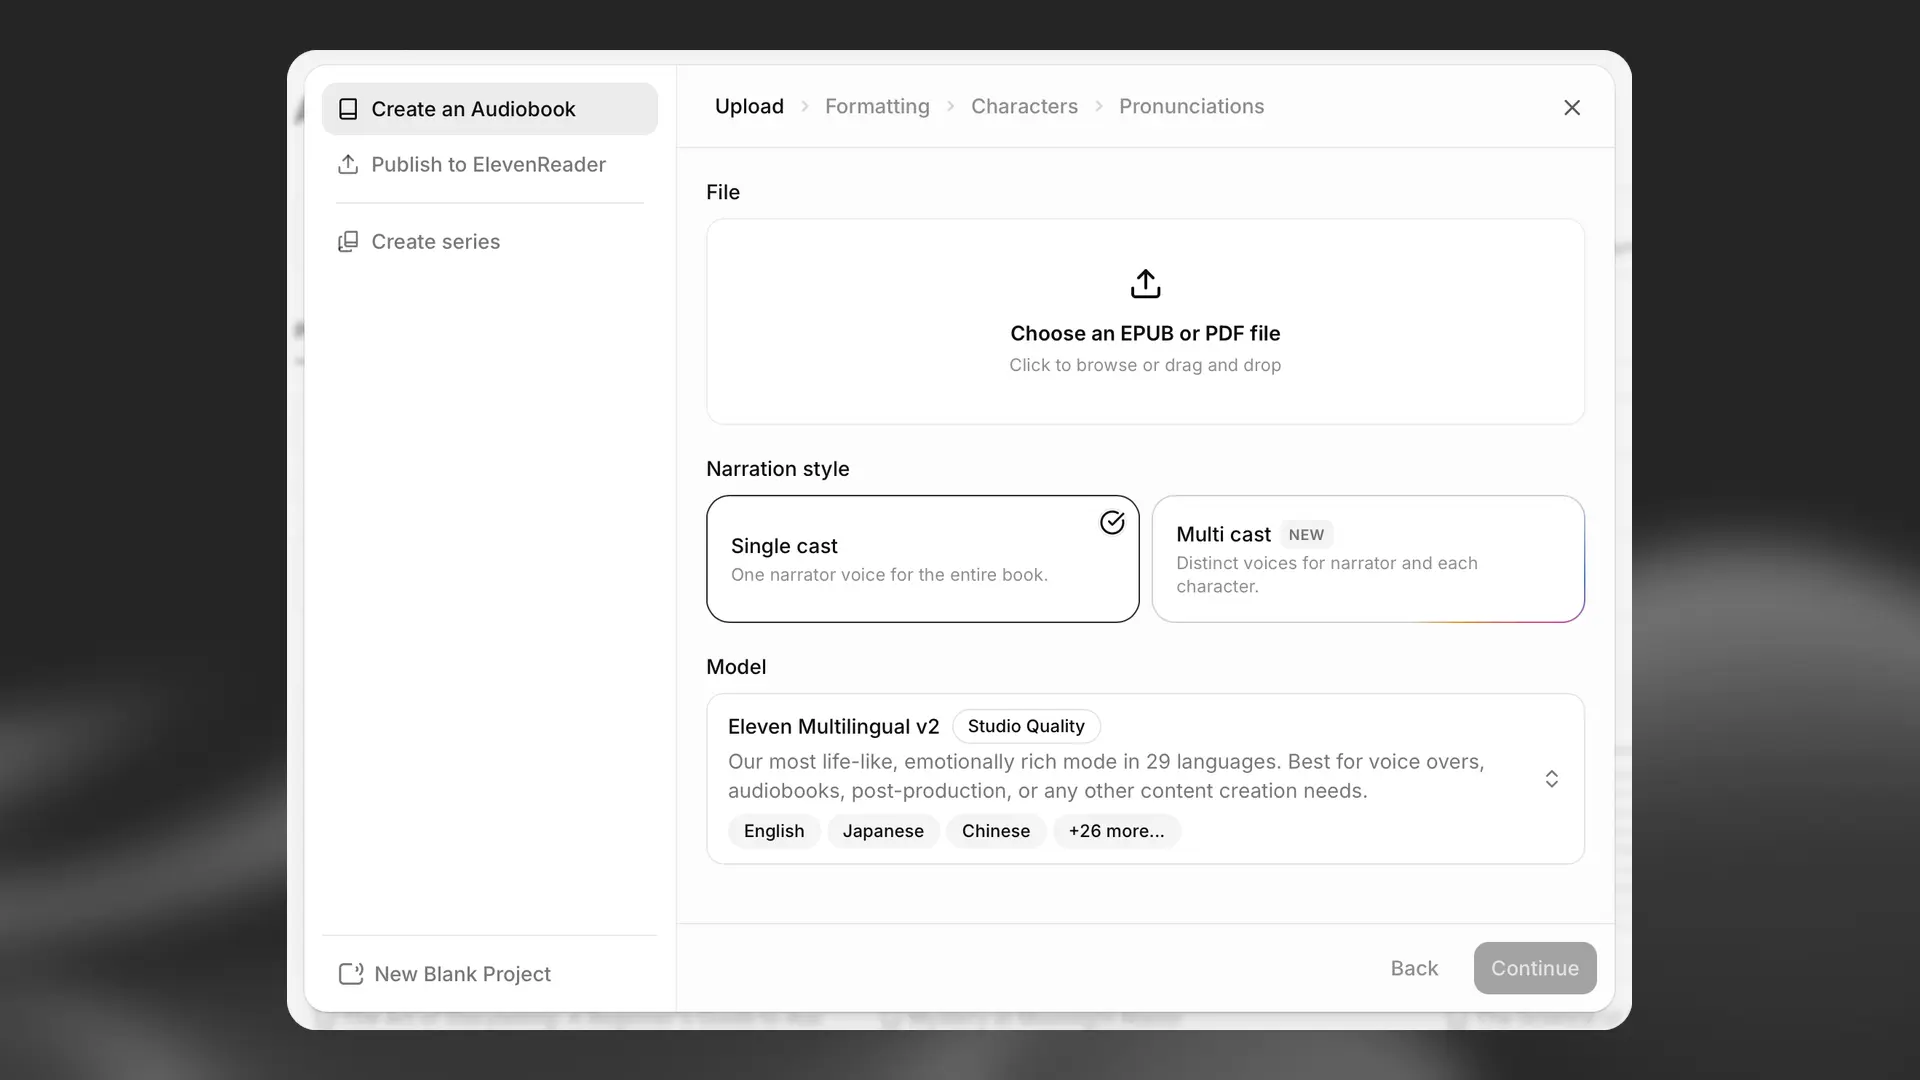
オーディオブックのナレーション方法を選択します。
- シングルキャスト — 1人のナレーター音声が本全体を読み上げます
- マルチキャスト — ナレーターと、原稿内で検出された登場人物にそれぞれ異なる音声を割り当てます
1つの音声で本全体をナレーションする場合は シングルキャスト を選択します。ナレーターと登場人物に別々の音声を使用する、より演劇的な制作にしたい場合は マルチキャスト を選択します。
モデルを選択
オーディオブックに使用するAIモデルを選択します。自然で感情豊かな結果を得るには、長編ボイスオーバーやオーディオブック向けの Eleven Multilingual v2(スタジオ品質) をおすすめします。29言語に対応しています。
Continue を選択して、原稿の処理を開始します。
原稿を解析して書式設定
Continue を選択すると、ElevenLabsがファイルを自動的に解析します。システムがドキュメントを分析し、メタデータ、チャプター、書式を抽出します。
解析が完了すると、Formatting 画面が表示されます。
表紙画像を確認
EPUBまたはPDFに表紙が含まれている場合、システムが自動的に抽出し、オーディオブックのアートワークとして表示します。以下の操作ができます。
- 表紙を置き換える
- 表紙を削除する
- 抽出した表紙を保持する
検出されたセクションを確認
ElevenLabsは、原稿内の次のような構造的なセクションを識別します。
- 著作権表示
- 献辞
- 序章
- チャプター
- 終章
- その他の書式設定されたセクション
チェックボックスを使用して、オーディオブックに含めるセクションを選択または選択解除します。
続行する前に、検出された構造を慎重に確認してください。原稿の書式はさまざまであり、システムが意図どおりにセクションを識別できない場合があります。
音声を選択して登場人物をキャスティング
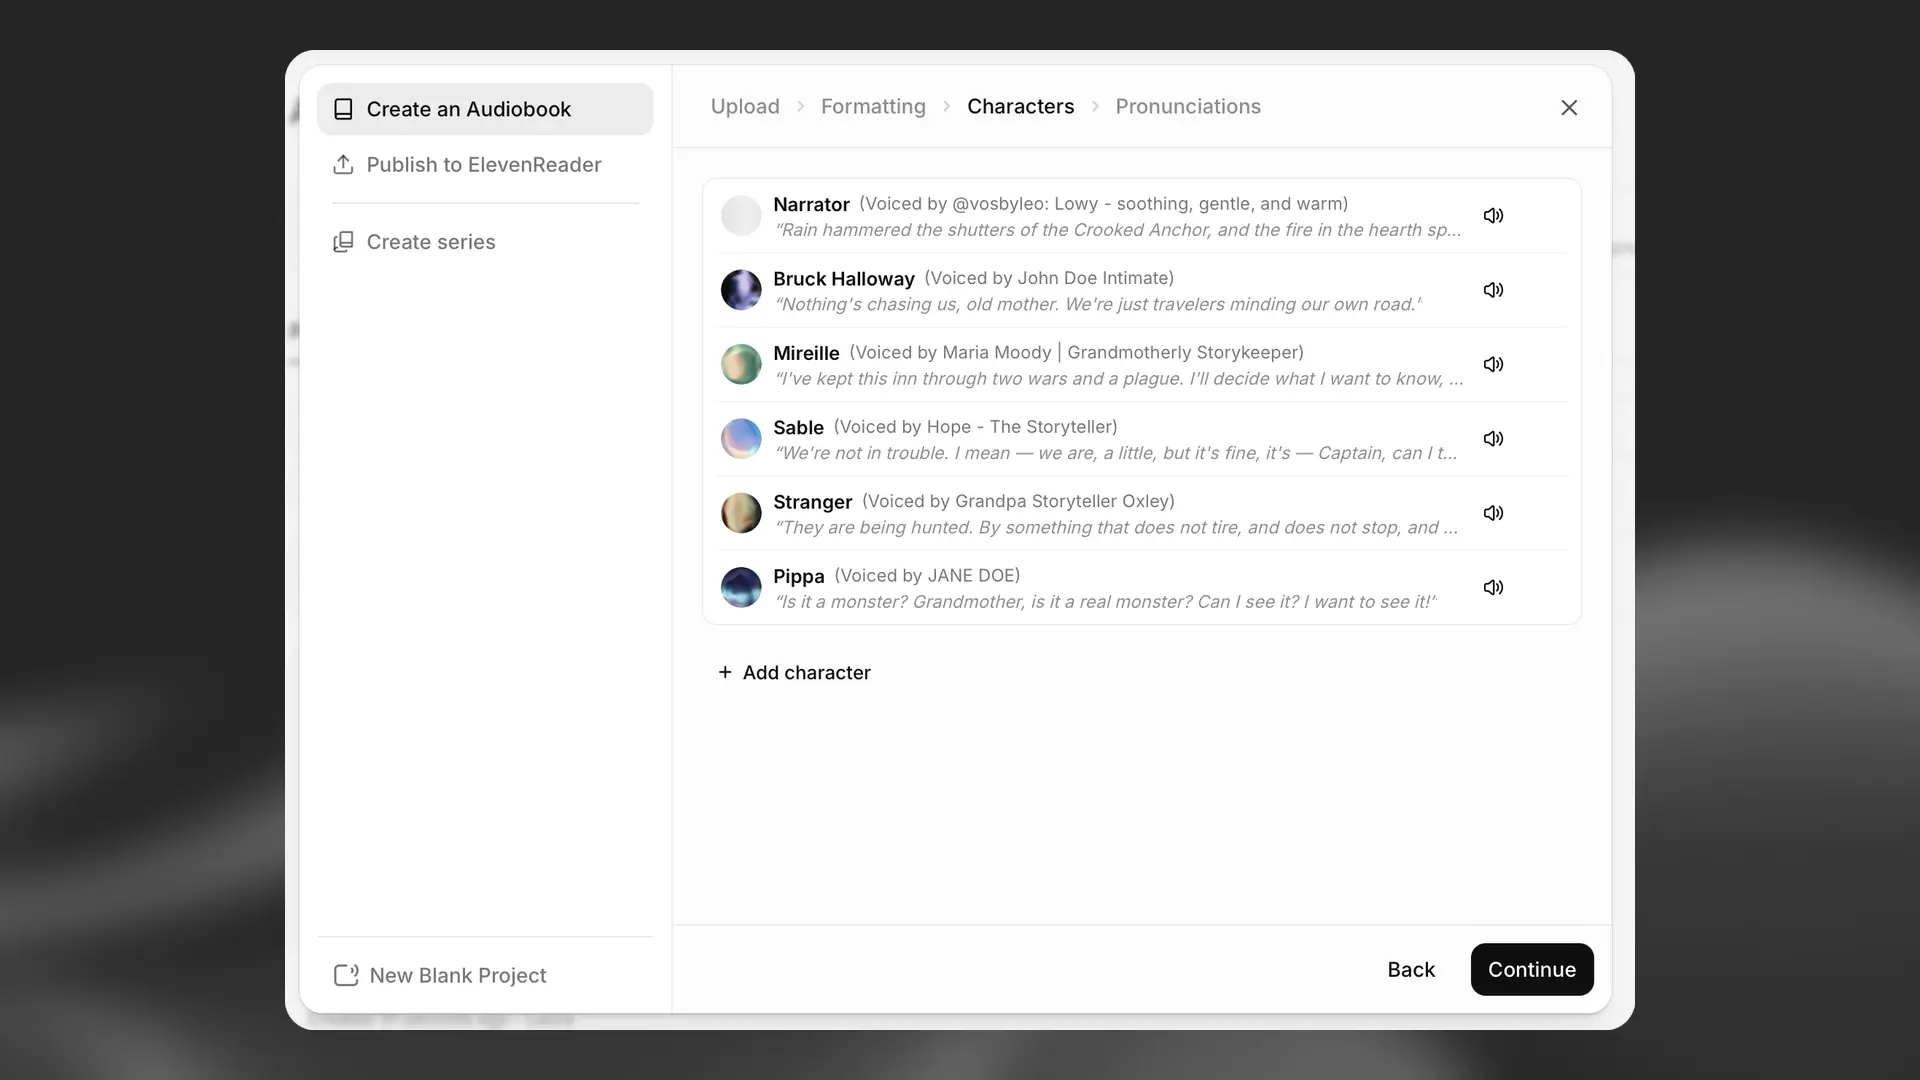
Characters ステップでは、オーディオブックに使用する音声を選択します。
マルチキャストのオーディオブックをキャスティング
マルチキャスト を選択した場合、ElevenLabsが原稿を分析し、物語の中で発話していると判断した登場人物を検出します。その後、以下に固有の音声を割り当てられます。
- メインナレーター
- 検出された各登場人物
- 原稿内で識別されたその他の話者
キャラクター検出はAIによって生成されるため、出発点として扱ってください。特に脇役、名前のない登場人物、周囲のナレーションと区別しにくい話者については、すべての登場人物を識別できない場合があります。
検出された登場人物リストを確認し、必要に応じてキャストを調整します。最終的なキャストが原稿に合うよう、音声の割り当てを追加、変更、または削除してください。
ボイスライブラリを探索
利用可能なスタジオ品質の音声を閲覧するか、検索とフィルターを使用して適切な音声を見つけます。フィルターには以下があります。
- 言語
- アクセント
- カテゴリー
- 性別
- 年齢
割り当てる前に音声をプレビューできます。
発音ルールを確認して追加
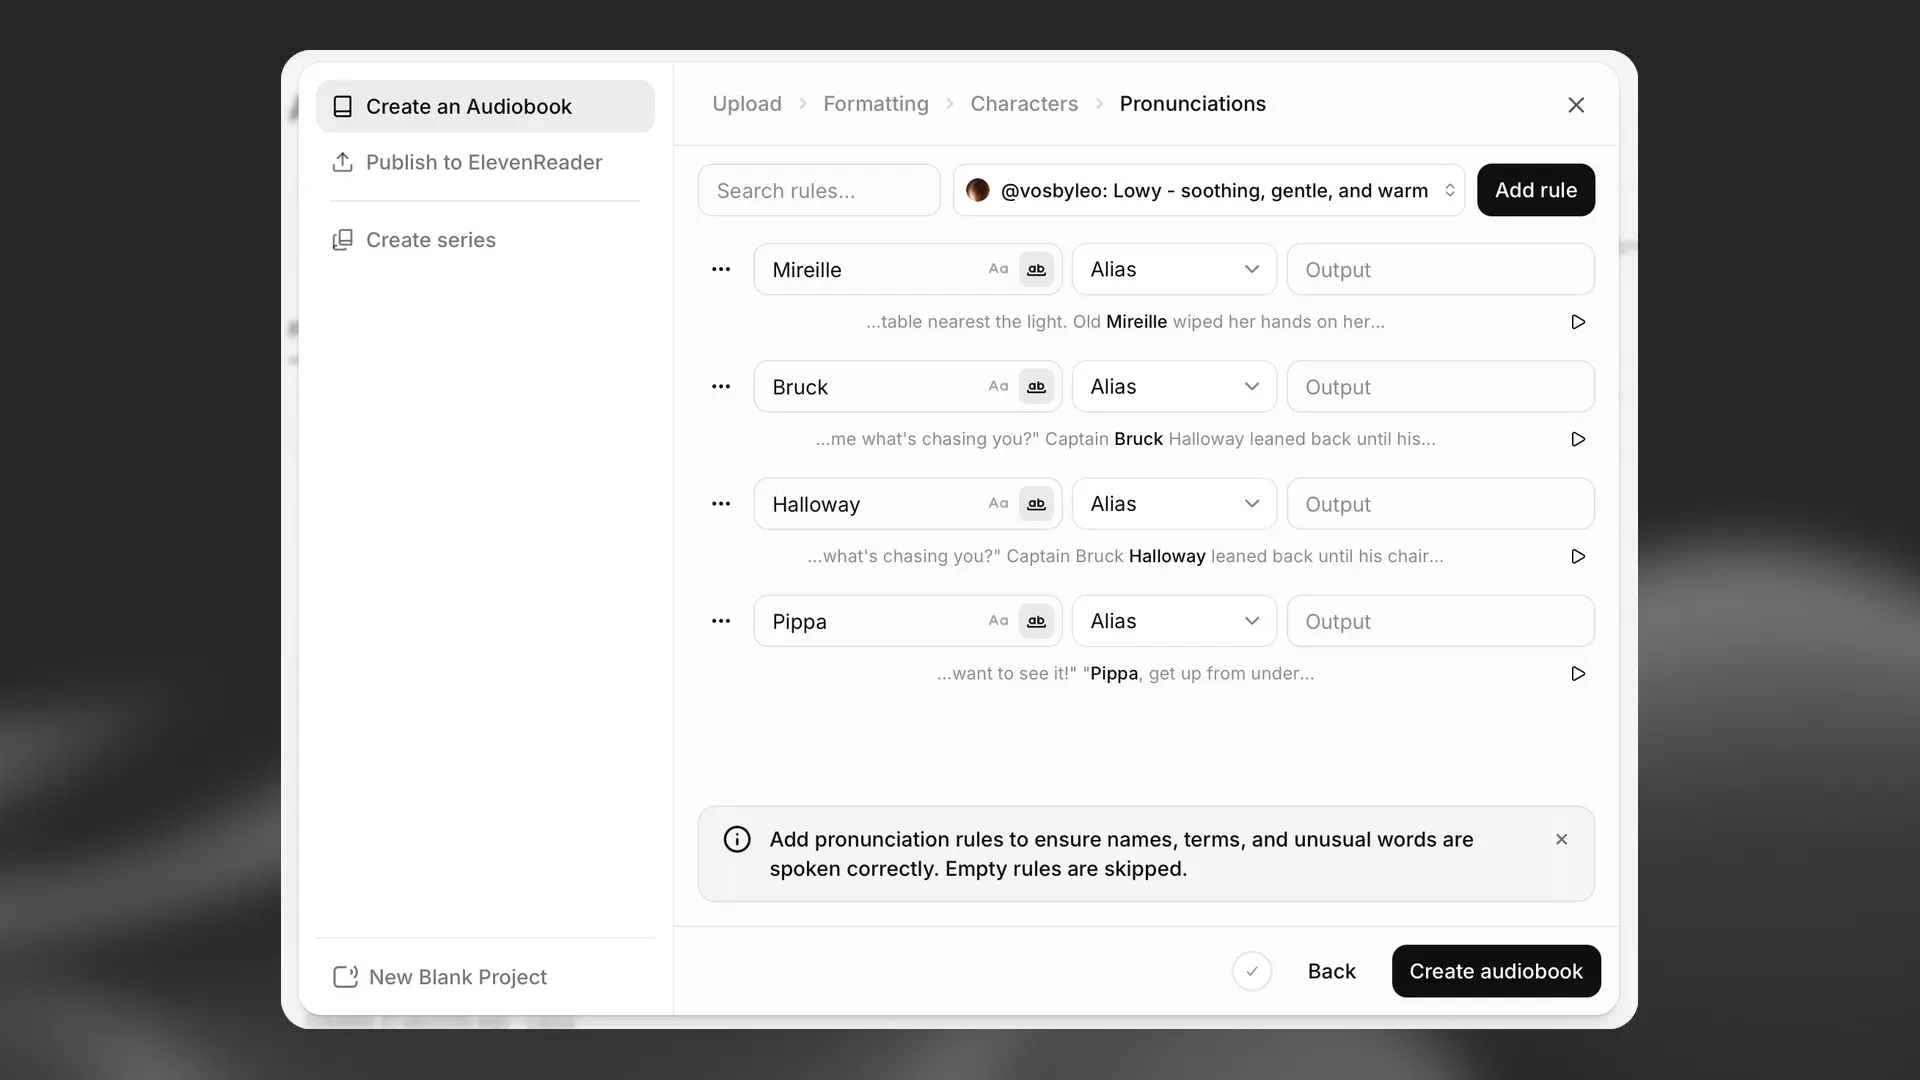
Pronunciations ステップでは、名前、場所、造語、その他の特殊な用語の読み方を制御できます。
自動検出された用語を確認
ElevenLabsが原稿をスキャンし、発音ルールが必要になる可能性のある用語を提案します。これには、登場人物の名前、地名、または架空の用語が含まれる場合があります。
提案は自動生成されるため、本で重要なすべての単語が含まれるとは限りません。リストを確認し、特別な処理が必要な重要な用語にはルールを追加してください。
発音ルールを追加
各用語に対して、Alias などのルールを作成し、希望する Output を入力できます。出力は、その用語をどのように発音するかをモデルに伝えます。
右上の Add rule を選択して、単語を手動で検索し、発音を定義することもできます。
文脈内で発音をプレビュー
ルールの横にある Play アイコンを選択すると、選択した音声が原稿内でその用語を含む文を読むのを聞けます。
文脈の中で聞くことで、以下を確認できます。
- 発音
- リズム
- 前後の文
- 割り当てた音声でルールが機能するかどうか
空のルールはスキップされ、それらの用語にはモデルのデフォルトの発音が使用されます。
編集と再生
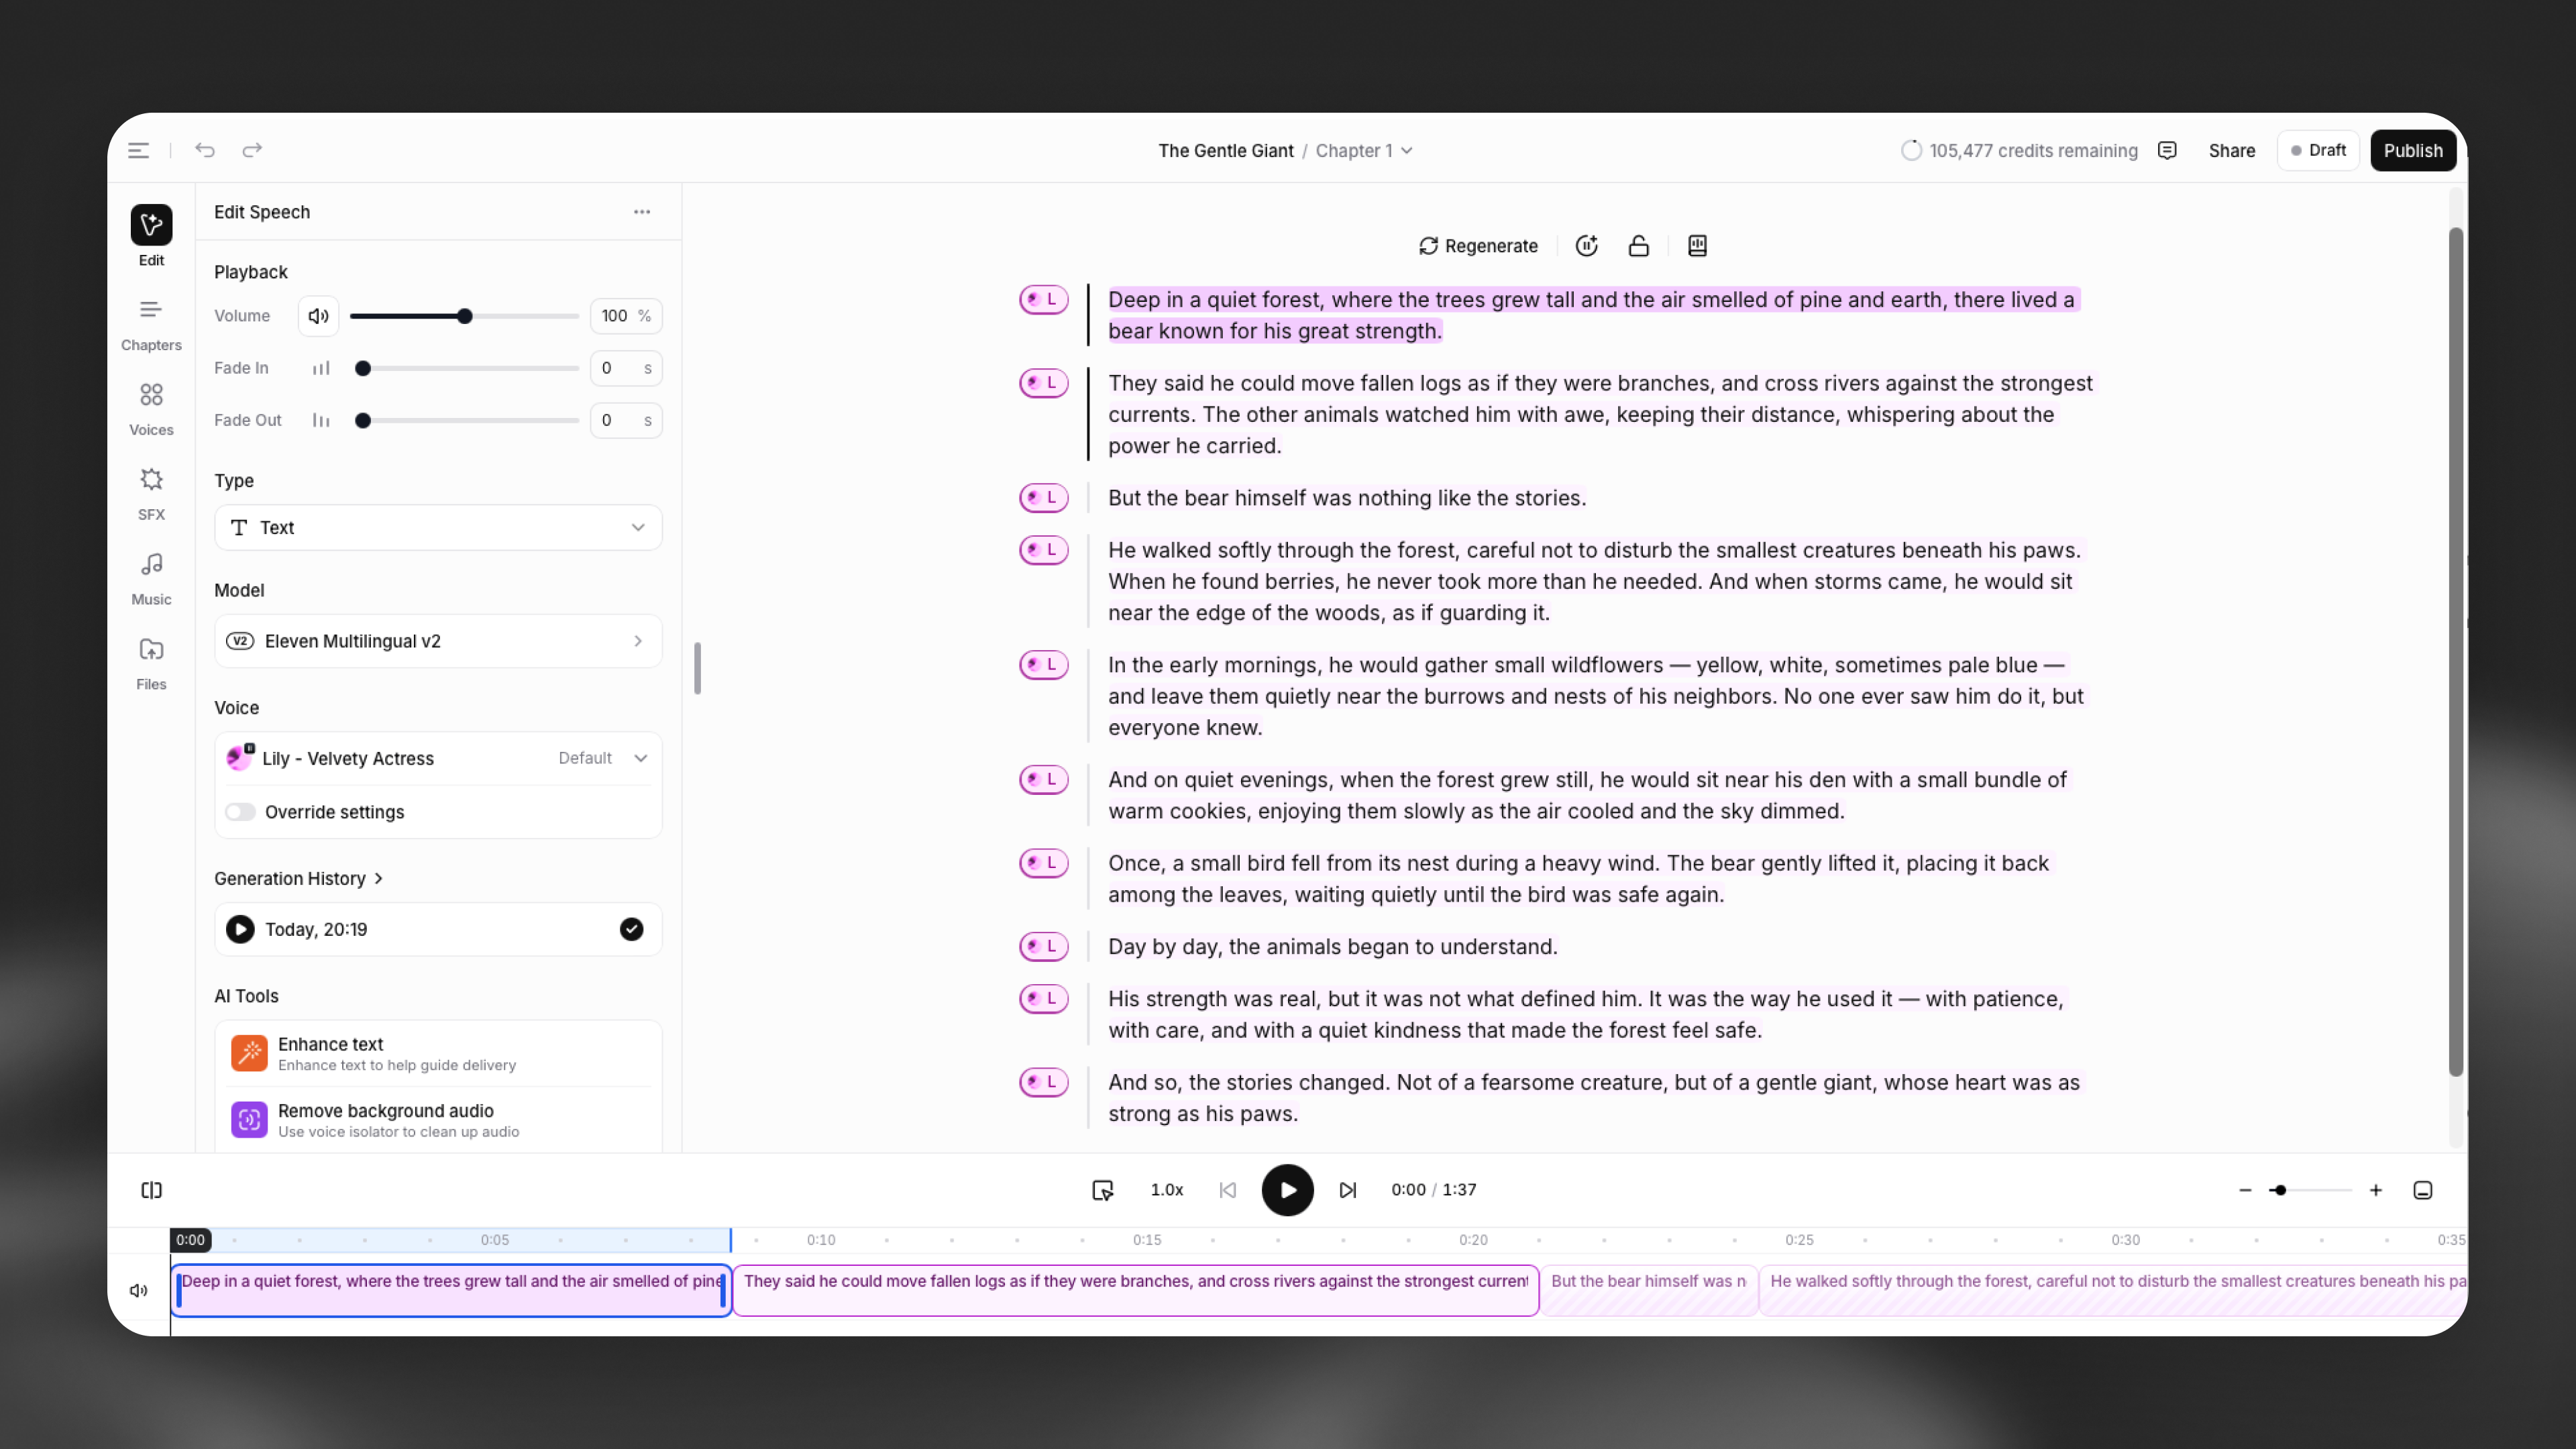
オーディオブックを作成した後は、エディターで調整・強化できます。
ナレーションの生成とプレビュー
コンテンツを追加すると、エディターで直接ナレーションを生成・プレビューできます。
- Play ボタンを使用して、ナレーションを生成するか、すでに生成されたオーディオを再生します
- 生成は各チャプター内の段落レベルで行われます
各段落のステータスは、テキストの左側にあるバーで表示されます。
- 濃いバー — ナレーションが生成済みです
- 薄いグレーのバー — ナレーションはまだ生成されていません
再生モード
Playボタンの左にあるモードセレクターを使用して、再生と生成の動作を選択できます。
- Selection — 選択した段落のオーディオのみを再生または生成します
- Until end(1つずつ生成) — 選択した段落からチャプターの終わりまで再生し、1段落ずつ生成します
- Until end(先行してクリップを生成) — 選択した段落からチャプターの終わりまで再生し、複数の段落を先行して生成することで、よりスムーズに再生します
すでに生成されたオーディオの再生ではクレジットを消費しません。クレジットが使用されるのは、新しいナレーションを生成する場合のみです。
オーディオブックを編集
テキストの編集、音声設定の調整、タイミングの変更を行い、必要に応じて特定のセクションを再生成できます。
タイムラインでは、ナレーション、音楽、サウンドエフェクトがどのように一緒に再生されるかを確認し、エクスポート前に調整できます。
オーディオブックを強化
追加のオーディオレイヤーを使用して、オーディオブックを充実させることができます。
- 音声 — ナレーション音声を選択または更新します
- サウンドエフェクト(SFX) — ライブラリからエフェクトを追加するか、カスタムサウンドを生成します
- 音楽 — Music Marketplaceから選択するか、新しいトラックを生成します
音楽またはサウンドエフェクトを追加するには、次の手順を行います。
- + アイコンをクリックしてプロジェクトにインポートします
- タイムライン上では別々のトラックとして表示され、ナレーションと一緒に再生されます
音声とモデルの設定
エディターのサイドバーとプロジェクト設定にある 音声とモデルの設定 を使って、オーディオブックのサウンドをカスタマイズできます。
音声とモデルの選択
- 音声 — オーディオブックで使用するナレーターを選択します
- モデル — 音声品質、表現力、対応言語を決定します
設定は次の2か所で変更できます。
- エディターのサイドバー — 選択した段落またはセクションに設定を適用します
- プロジェクト設定 — プロジェクト全体のデフォルト音声とモデルを設定します
プロジェクトレベルの設定にアクセスするには、左上のメニューを開き、プロジェクト設定 を選択してください。
利用可能なモデル
ElevenLabsは、それぞれに異なる強みを持つ複数の音声モデルをサポートしています。
- Eleven v4 — 最新モデル。最高品質と幅広い言語サポートを提供します
- Eleven v3 — 従来の表現力豊かなモデル(より細かなプロンプト制御が必要です)
- Eleven Multilingual v2 — 高品質で自然なナレーション(ほとんどのオーディオブック用途のデフォルト)
- Eleven Flashモデル — 高速化と低レイテンシーに最適化されています
モデルはいつでも切り替えられます。ただし、次の点に注意してください。
モデルを変更しても、すでに生成されたオーディオは更新されません。影響を受ける段落を再生成する必要があり、クレジットが使用されます。
デフォルト設定
新しいオーディオブックを作成する場合:
- デフォルトモデルは Eleven Multilingual v2 です
- デフォルト音声は自動的に選択されます(いつでも変更できます)
- デフォルト言語は 自動検出 に設定されます
音声設定(選択ごと)
エディター内では、特定の段落の音声設定を上書きできます。サイドバーで 設定を上書き を有効にすると、プロジェクト全体に影響を与えずに話し方を調整できます。
再生コントロール
コンテキストサイドバーには、ナレーションを細かく調整するための再生コントロールがあります。
- 音量 — 音量を調整します
- フェードイン/フェードアウト — オーディオの開始と終了を調整します
これらの設定は、選択した段落に適用されます。
AIツール
サイドバーには、オーディオブックを改善するAI搭載ツールもあります。
- テキストを改善 — 話し方と明瞭さを向上させるためにテキストを調整します
- バックグラウンドオーディオを削除 — 音声分離を使用してオーディオをクリーンアップします
- ボイスチェンジャーを使用 — 既存オーディオの音声を変更します
- 自分の声で話し方を指示 — 参照用オーディオを録音して話し方をガイドします(Actor Mode)
品質とエクスポートの設定
オーディオ品質はサブスクリプションプランとプロジェクト設定によって自動的に決まり、クレジット使用量には影響しません。
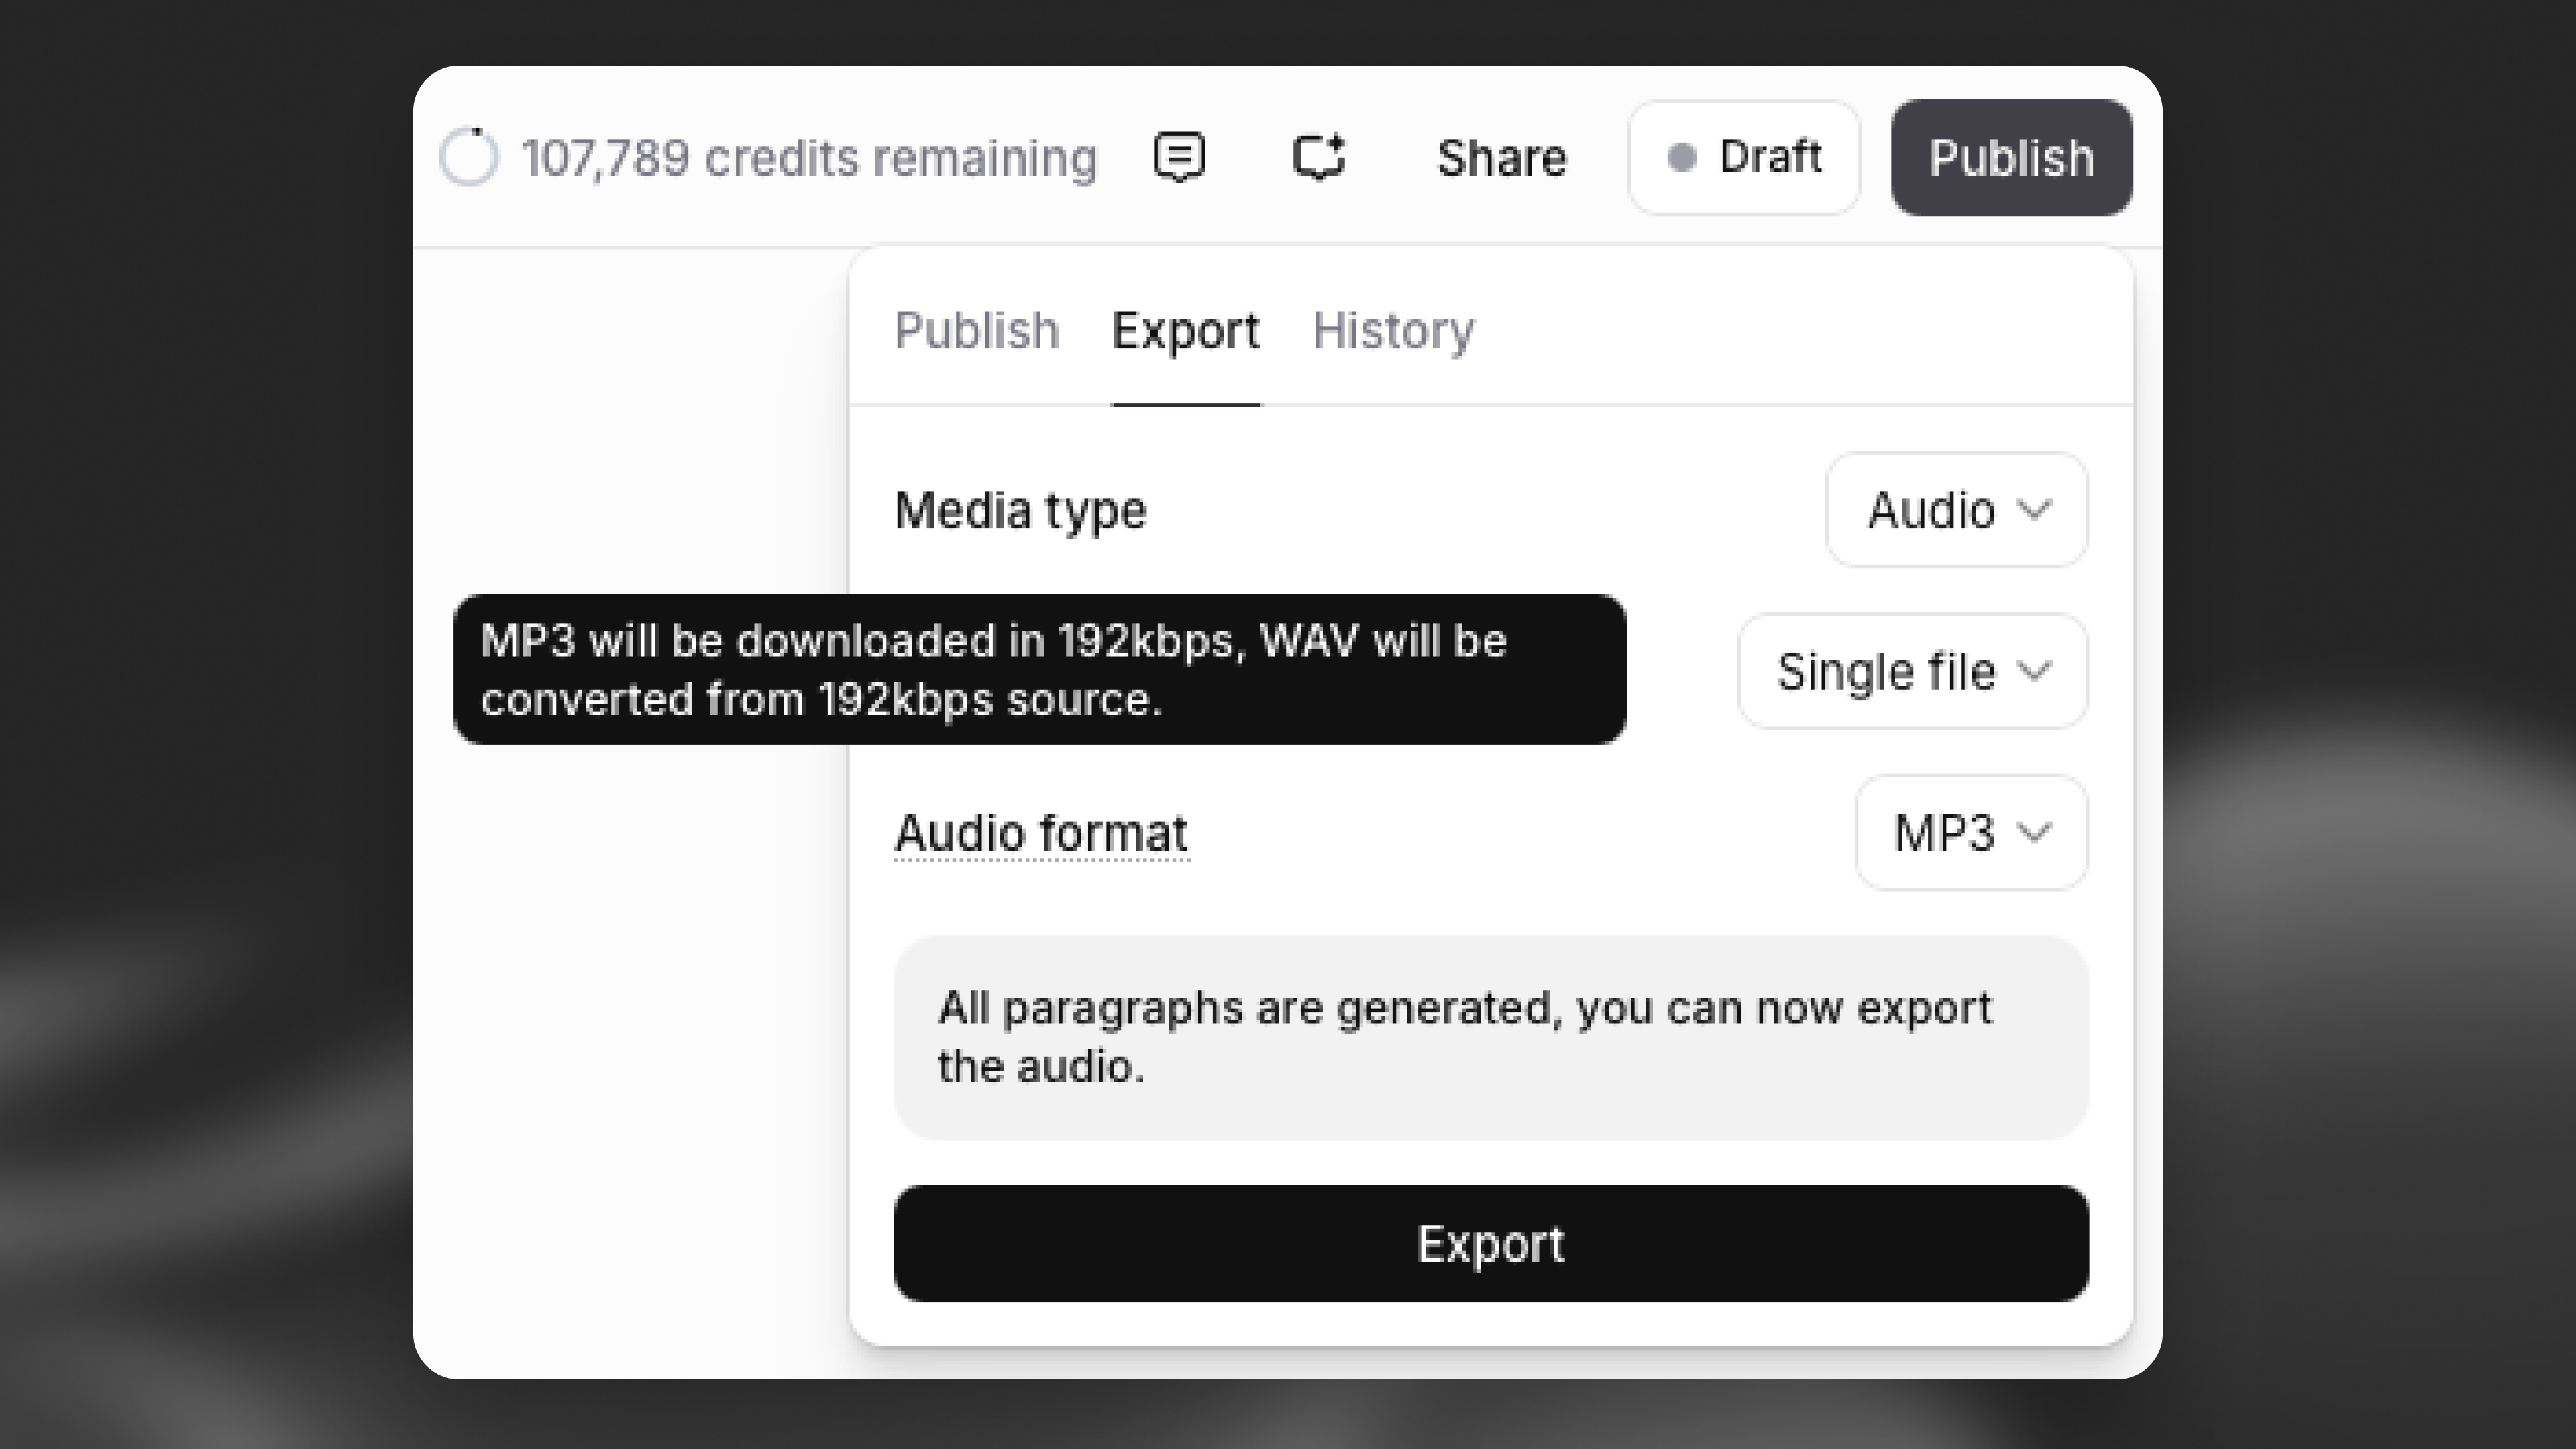
プロジェクトの正確な出力品質を確認するには、右上の 公開 をクリックし、エクスポート タブを開いて、オーディオ形式 フィールドにカーソルを合わせます。ビットレートやサンプルレートなどの詳細を確認できます。
重要な動作
オーディオ生成後に音声またはモデルの設定を変更した場合:
- 既存の段落は自動的に更新されません
- 変更を反映するにはオーディオを再生成する必要があり、クレジットが使用されます
コンテキストサイドバー
コンテキストサイドバーは、プロジェクト内で選択した内容に応じて更新されます。
ナレーションでは、次の機能を利用できます。
- 再生コントロール
- 音声とモデルの選択
- 設定の上書き
- 生成履歴
- AIツール
これにより、ナレーションを非常に細かいレベルで調整・改善できます。
発音辞書
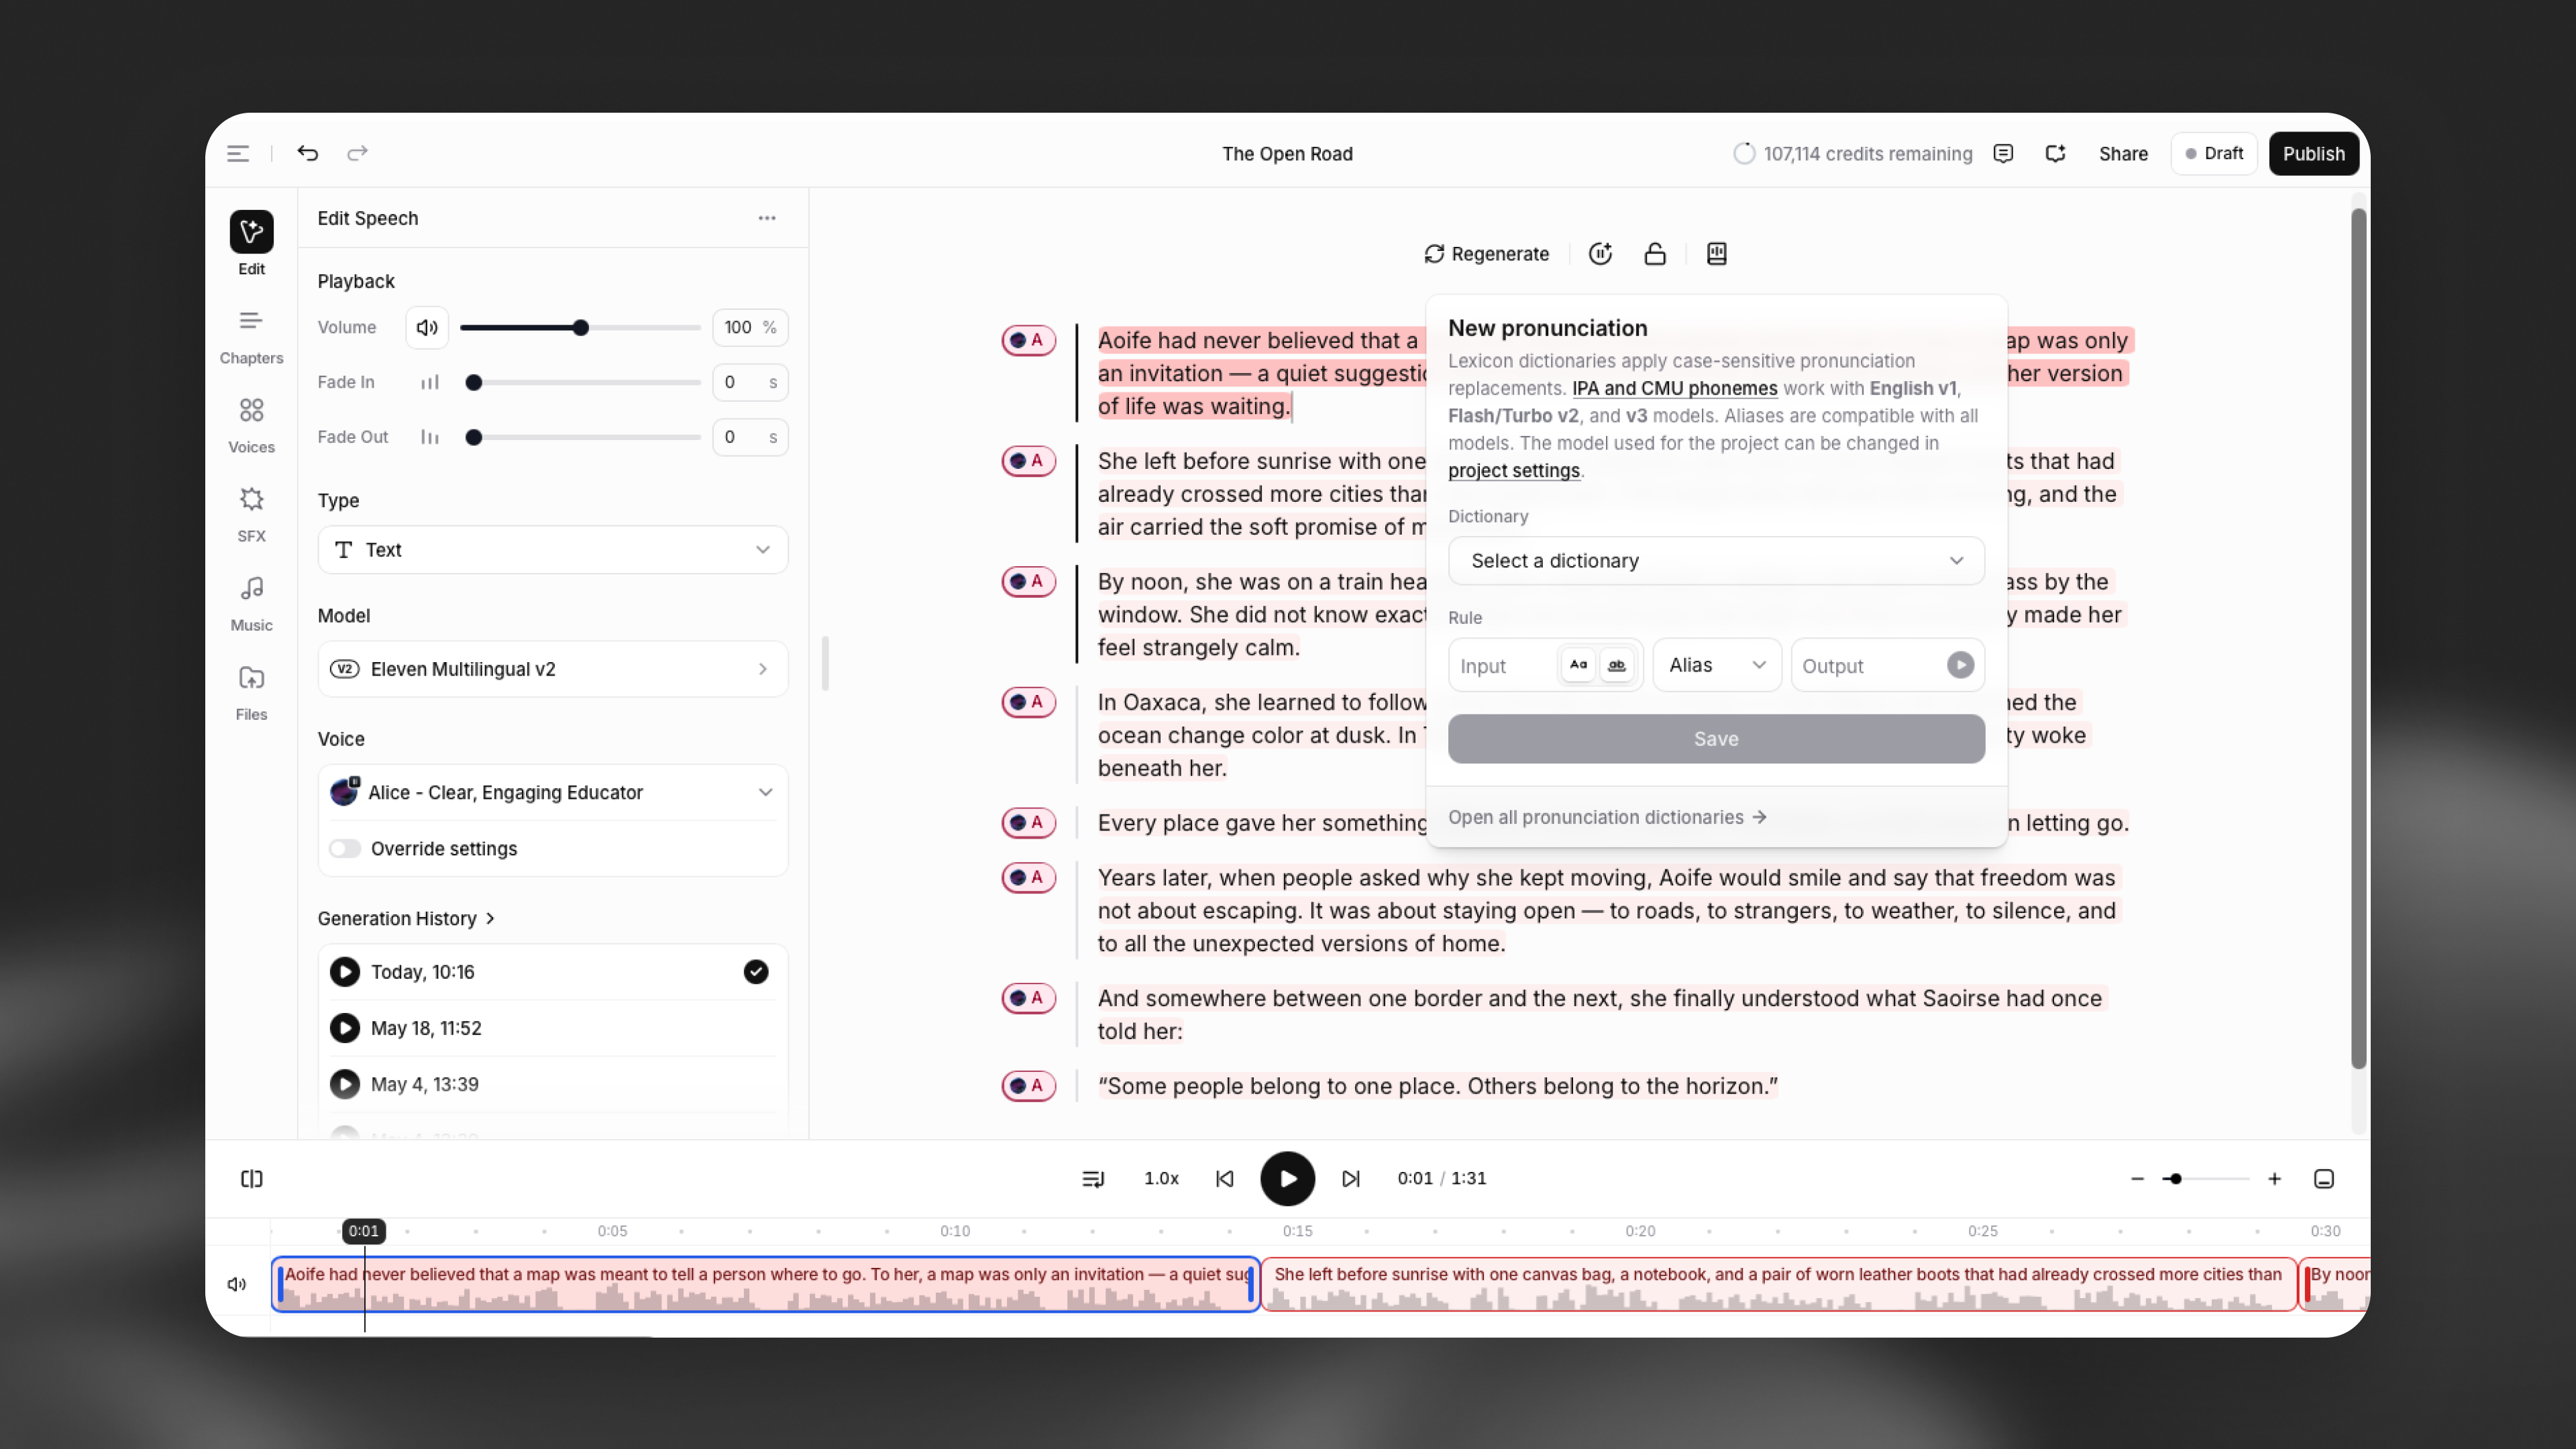
発音辞書を使用すると、特定の単語の発音を制御できます。
次のような場合に便利です。
- 登場人物の名前
- ブランド名
- 頭字語
- 珍しい単語や曖昧な単語
発音辞書では、次の方法で単語の読み方を定義できます。
- 音素ルール — 音声表記を使用して発音を指定します
- エイリアス — 目的の発音になる別のスペルに単語を置き換えます
テキスト内の単語が接続済みの辞書のルールに一致すると、定義した発音が使用されます。
発音辞書の使い方
- ツールバーから 発音エディター を開きます
- 新しい辞書を作成するか、既存の辞書を選択します
- 制御したい単語のエントリーを追加します
- 接続 をクリックして、辞書をプロジェクトに適用します
辞書ファイルをアップロードしたり、発音エディターからすべての辞書を管理したりすることもできます。
重要な注意事項
- 辞書は順番に適用され、最初に一致したルールが使用されます
- 変更は新たに生成されるオーディオにのみ適用されます。更新内容を聞くには、段落を再生成 する必要があります
- 音素ルールは、Flash v2などの英語モデルでのみサポートされています
発音辞書は、長いオーディオブック全体で一貫性を保つのに特に役立ちます。
キャラクターキャスティング
キャラクターキャスティングでは、本の登場人物に音声を割り当てられます。原稿をアップロードすると、Audiobooksが登場人物を検出し、それぞれに音声を提案します。実際に本で使われているセリフでプレビューすることもできます。
生成後に登場人物を更新する
オーディオ生成後に登場人物の音声を変更すると、その登場人物の以前のオーディオは削除されます。新しい音声を使用してオーディオを再生成する必要があり、クレジットが使用されます。続行前に変更の確認が求められます。
登場人物のすべてのセリフが、本全体で更新されます。個々の段落や章を手動で再割り当てする必要はありません。影響を受けるすべての段落のオーディオを自動的に再生成するには、オーディオブックの新しいバージョンをエクスポートしてください。再生成が必要な段落に対してのみクレジットが請求されます。
ボイスライブラリ
Audiobooksは、10,000種類以上の音声ライブラリを使用し、90以上の言語でのナレーションに対応しています。自分でナレーションを担当したい場合や登場人物の声を提供したい場合は、数秒で自分の声をクローンすることもできます。
ベストプラクティス
解析ステップを進める前に、書式を確認してください。セクションの検出が正しくないと、最終的なオーディオブックに影響することがあります。
複数キャストのプロジェクトでは、検出された各登場人物と音声の割り当てを確認してください。名前のない登場人物や脇役はシステムが正しく識別しにくい場合があるため、特に注意してください。
書かれたルールだけに頼らず、文脈の中で発音プレビューを聞いてください。単独で正しく聞こえる発音でも、文全体の中では調整が必要になる場合があります。
エクスポートまたは公開する前に、生成されたオーディオブックを確認してください。Audiobooksは制作プロセスの大部分を自動化できますが、完成度の高い仕上がりには編集と品質チェックが不可欠です。
章
オーディオブックは章で構成されます。章は手動で作成することも、ドキュメントのインポート時に自動検出することもできます。
できること:
- + ボタンを使用して新しい章を追加
- 章の名前変更や並べ替え
- 章ごとのナレーション生成
章を使うと、長いコンテンツを整理しやすくなり、エクスポートの柔軟性も高まります。
ナレーションモード
Audiobooksでは、目的に応じて2つの異なるナレーション方法を利用できます。
オリジナルオーディオ
選択した音声を使用してオーディオを事前に生成し、すべてのリスナーに対して固定された状態になります。
次の項目を完全に制御したい場合に最適です。
- 音声の選択
- タイミングと話し方
- 音楽とサウンドデザイン
ダイナミックナレーション
固定された音声を使用する代わりに、ダイナミックナレーションでは、リスナーが再生中に好みの音声を選択できます。
次の用途に最適です。
- アクセシビリティ
- パーソナライズ
- リスナーの好み
ダイナミックナレーションの再生には、音楽、サウンドエフェクト、外部オーディオは含まれません。
エクスポートと公開
エクスポートオプション
オーディオブックをエクスポートするには、右上の 公開 をクリックし、エクスポート タブを開きます。
Audiobooksでは、コンテンツの利用方法に応じて柔軟なエクスポートオプションを利用できます。
エクスポート範囲
- プロジェクト全体
- 個別の章
メディアタイプ
- オーディオ
- タイムラインデータ(AAF)
- 字幕
ファイル構造
- 単一ファイル
- 章ごとのZIP
オーディオ形式
- MP3
- WAV
まだ生成されていないセクションがある場合は、エクスポート中に自動的に完了し、クレジットが使用されます。
公開と配信
オーディオブックを配信するには、右上の 公開 をクリックし、公開 タブを開いたままにします。
次の場所に直接公開できます。
- ElevenReader — アプリ内での視聴と配信用
- SpotifyやInAudioなどのパートナープラットフォーム
- 追加形式向けの ElevenLabs Video または オーディオネイティブ
公開すると、リスナーとオーディオブックを共有できます。また、ElevenReaderなどの対応プラットフォームでは、配信による収益化を開始できます。
ElevenReaderへの公開
ElevenReaderに公開する場合、オーディオブックを配信向けに準備するための申請フローを進めます。
内容は次のとおりです。
- 著者プロフィールの作成または選択
- 書籍メタデータ(タイトル、サブタイトル、表紙画像)の追加
- 配信詳細の入力
- 支払いと契約の設定
- オーディオブックの確認と提出
提出後、ElevenReaderアプリで利用可能になる前にオーディオブックが審査されます。
シリーズでオーディオブックを整理する
複数のオーディオブックをシリーズにまとめることで、関連コンテンツを整理し、見つけやすさを向上させることができます。
シリーズを作成するには:
- 本棚 に移動します
- シリーズを作成 ボタン(右上)をクリックします
- 次の項目を入力します。
- シリーズ名
- 説明
- 著者プロフィール
- 言語
- 必要に応じて、既存の本をシリーズに追加します
- シリーズを作成 をクリックします