

Eigenes Modell integrieren
Mit Custom LLM können Sie Ihre Gespräche über einen externen Endpunkt mit Ihrem eigenen LLM verbinden. ElevenLabs unterstützt auch nativ integrierte LLMs
Mit benutzerdefinierten LLMs können Sie Ihren eigenen OpenAI-API-Schlüssel verwenden oder einen vollständig benutzerdefinierten LLM-Server betreiben.
Überblick
Standardmäßig verwenden wir unsere eigenen internen Anmeldedaten für beliebte Modelle wie OpenAI. Um einen benutzerdefinierten LLM-Server zu verwenden, muss dieser einer der folgenden OpenAI-kompatiblen Anfrage-/Antwortstrukturen entsprechen:
- Chat Completions API (
/v1/chat/completions) - Responses API (
/v1/responses)
Die Responses API ist das neuere API-Format von OpenAI und unterstützt zusätzliche Funktionen. Beide API-Formate werden vollständig für die Integration benutzerdefinierter LLMs unterstützt.
Die folgenden Anleitungen behandeln beide Anwendungsfälle:
- Eigenen OpenAI-Schlüssel verwenden: Verwenden Sie Ihren eigenen OpenAI-API-Schlüssel mit unserer Plattform.
- Benutzerdefinierter LLM-Server: Hosten und verbinden Sie Ihre eigene LLM-Serverimplementierung.
Sie erfahren, wie Sie:
- Ihren OpenAI-API-Schlüssel in ElevenLabs speichern
- einen Server hosten, der den Chat Completions- oder Responses-Endpunkt von OpenAI nachbildet
- ElevenLabs auf Ihren benutzerdefinierten Endpunkt verweisen
- bei Bedarf zusätzliche Parameter an Ihr LLM übergeben
Zusammenfassung der Begründung
Ihr Endpunkt muss die Begründung getrennt von der endgültigen Antwort zurückgeben. ElevenLabs generiert die Begründung nicht aus der endgültigen Antwort.
Um eine Begründung von einem unterstützten Endpunkt anzufordern, aktivieren Sie Zusammenfassung der Begründung in den LLM-Einstellungen des Agenten oder setzen Sie enable_reasoning_summary über die API.
Begründung zurückgeben
Verwenden Sie das Format, das zu Ihrem Endpunkt passt:
Chat Completions API
Responses API
Streamen Sie die Begründung im Feld reasoning oder reasoning_content jedes Antwort-Deltas.
Für Gemini-kompatible Endpunkte fordert ElevenLabs Gedanken mit
google.thinking_config.include_thoughts an und liest Inhalte mit der Markierung
extra_content.google.thought.
Weitere Informationen zu Speicherung, Bereitstellung und Einschränkungen finden Sie unter Zusammenfassung der Begründung.
Eigenen OpenAI-Schlüssel verwenden
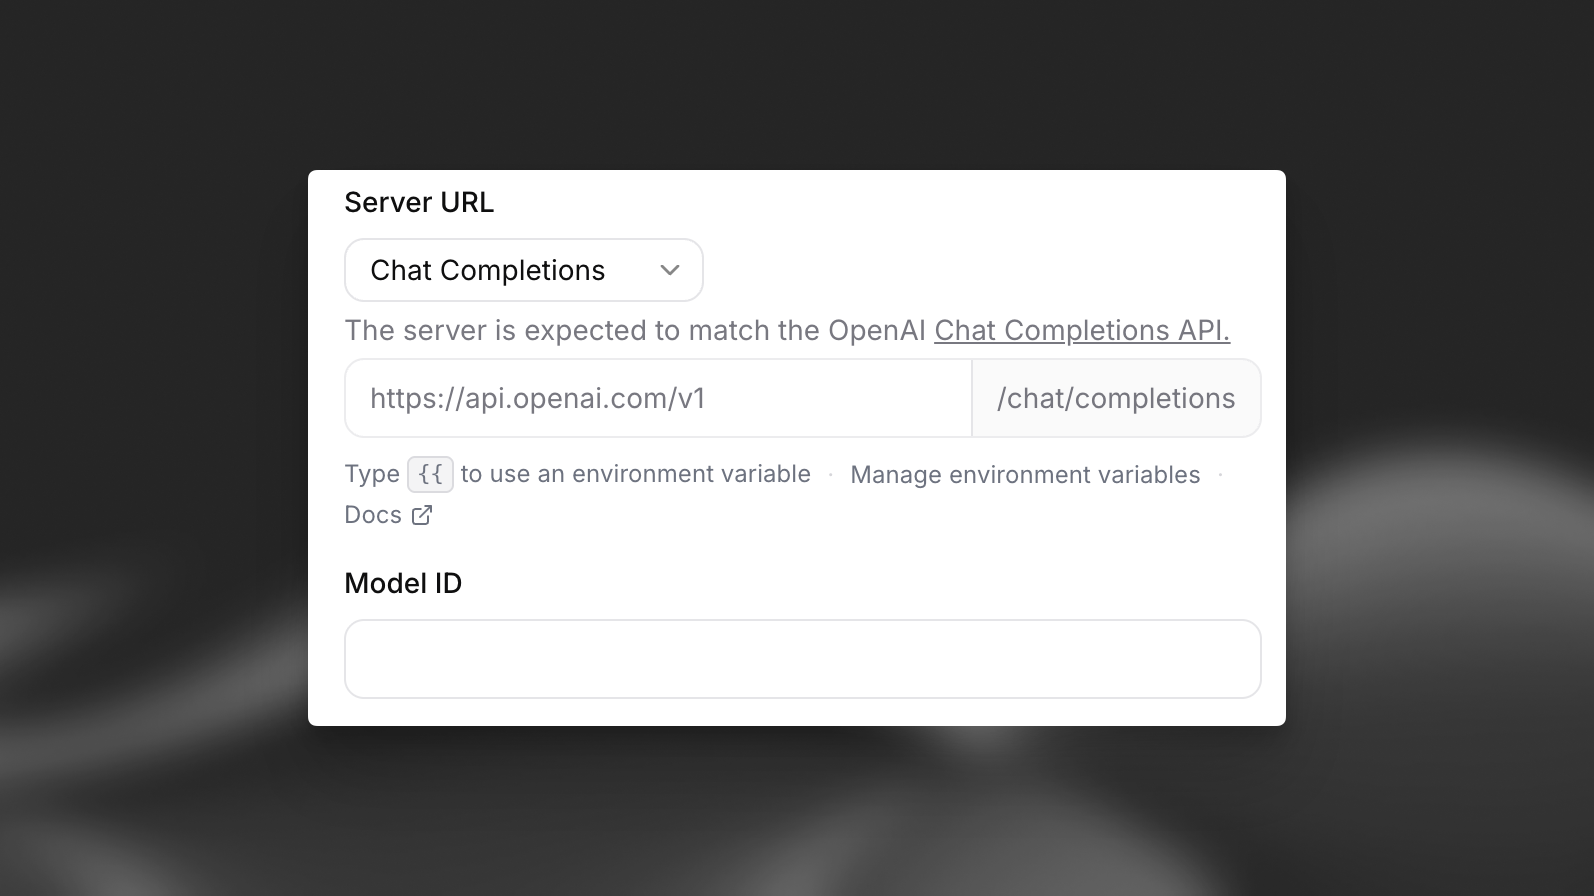
Um einen benutzerdefinierten OpenAI-Schlüssel zu integrieren, aktualisieren Sie die Einstellungen Ihres Agenten im ElevenLabs-Dashboard, sodass sie auf Ihren benutzerdefinierten LLM-Server verweisen, und erstellen Sie ein Secret mit Ihrem OPENAI_API_KEY:
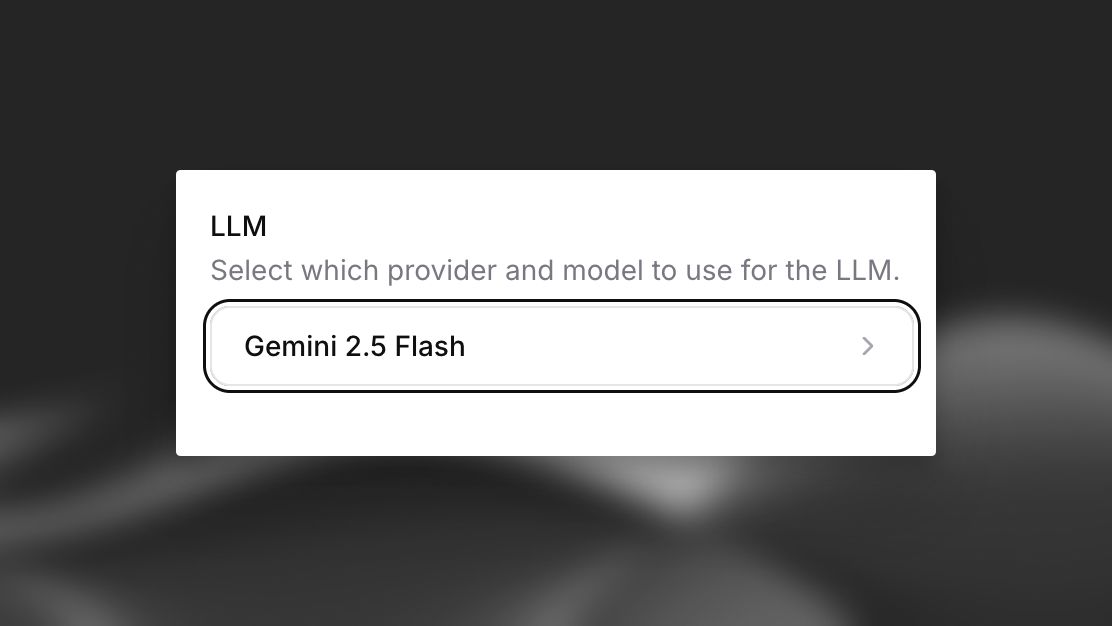
Wählen Sie in den Agent-Einstellungen im ElevenLabs-Dashboard rechts im Dropdown-Menü „LLM“ die Option „Custom LLM“.
Benutzerdefinierter LLM-Server
Um einen benutzerdefinierten LLM-Server einzubinden, richten Sie einen kompatiblen Server-Endpunkt im Stil von OpenAI ein. Sie können entweder die Chat Completions API (/v1/chat/completions) oder die Responses API (/v1/responses) implementieren.
Beide Endpunkte müssen Antworten im SSE-Format (Server-Sent Events) mit Content-Type: text/event-stream zurückgeben.
Chat Completions API
Responses API
Die Chat Completions API verwendet den Endpunkt /v1/chat/completions.
Jeder Chunk muss als data: {json}\n\n formatiert sein und der Stream muss mit data: [DONE]\n\n enden.
Hier ist eine beispielhafte Serverimplementierung:
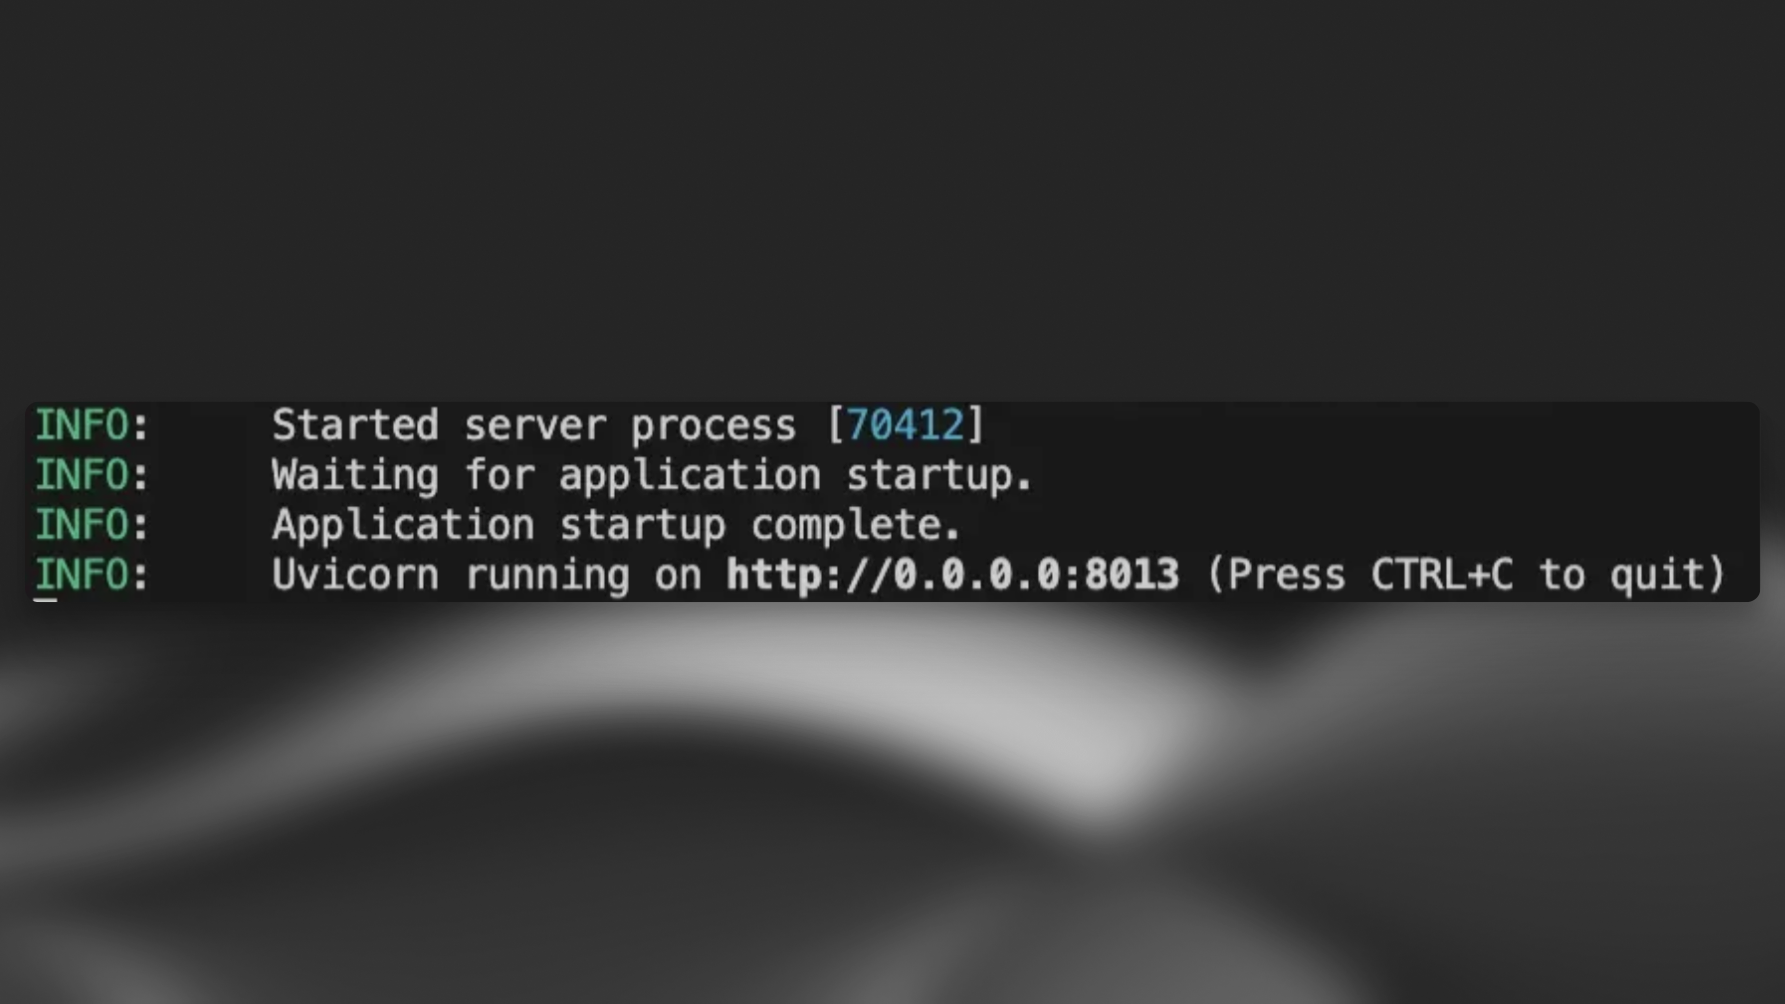
Führen Sie diesen Code oder Ihren eigenen Servercode aus.
Öffentliche URL für Ihren Server einrichten
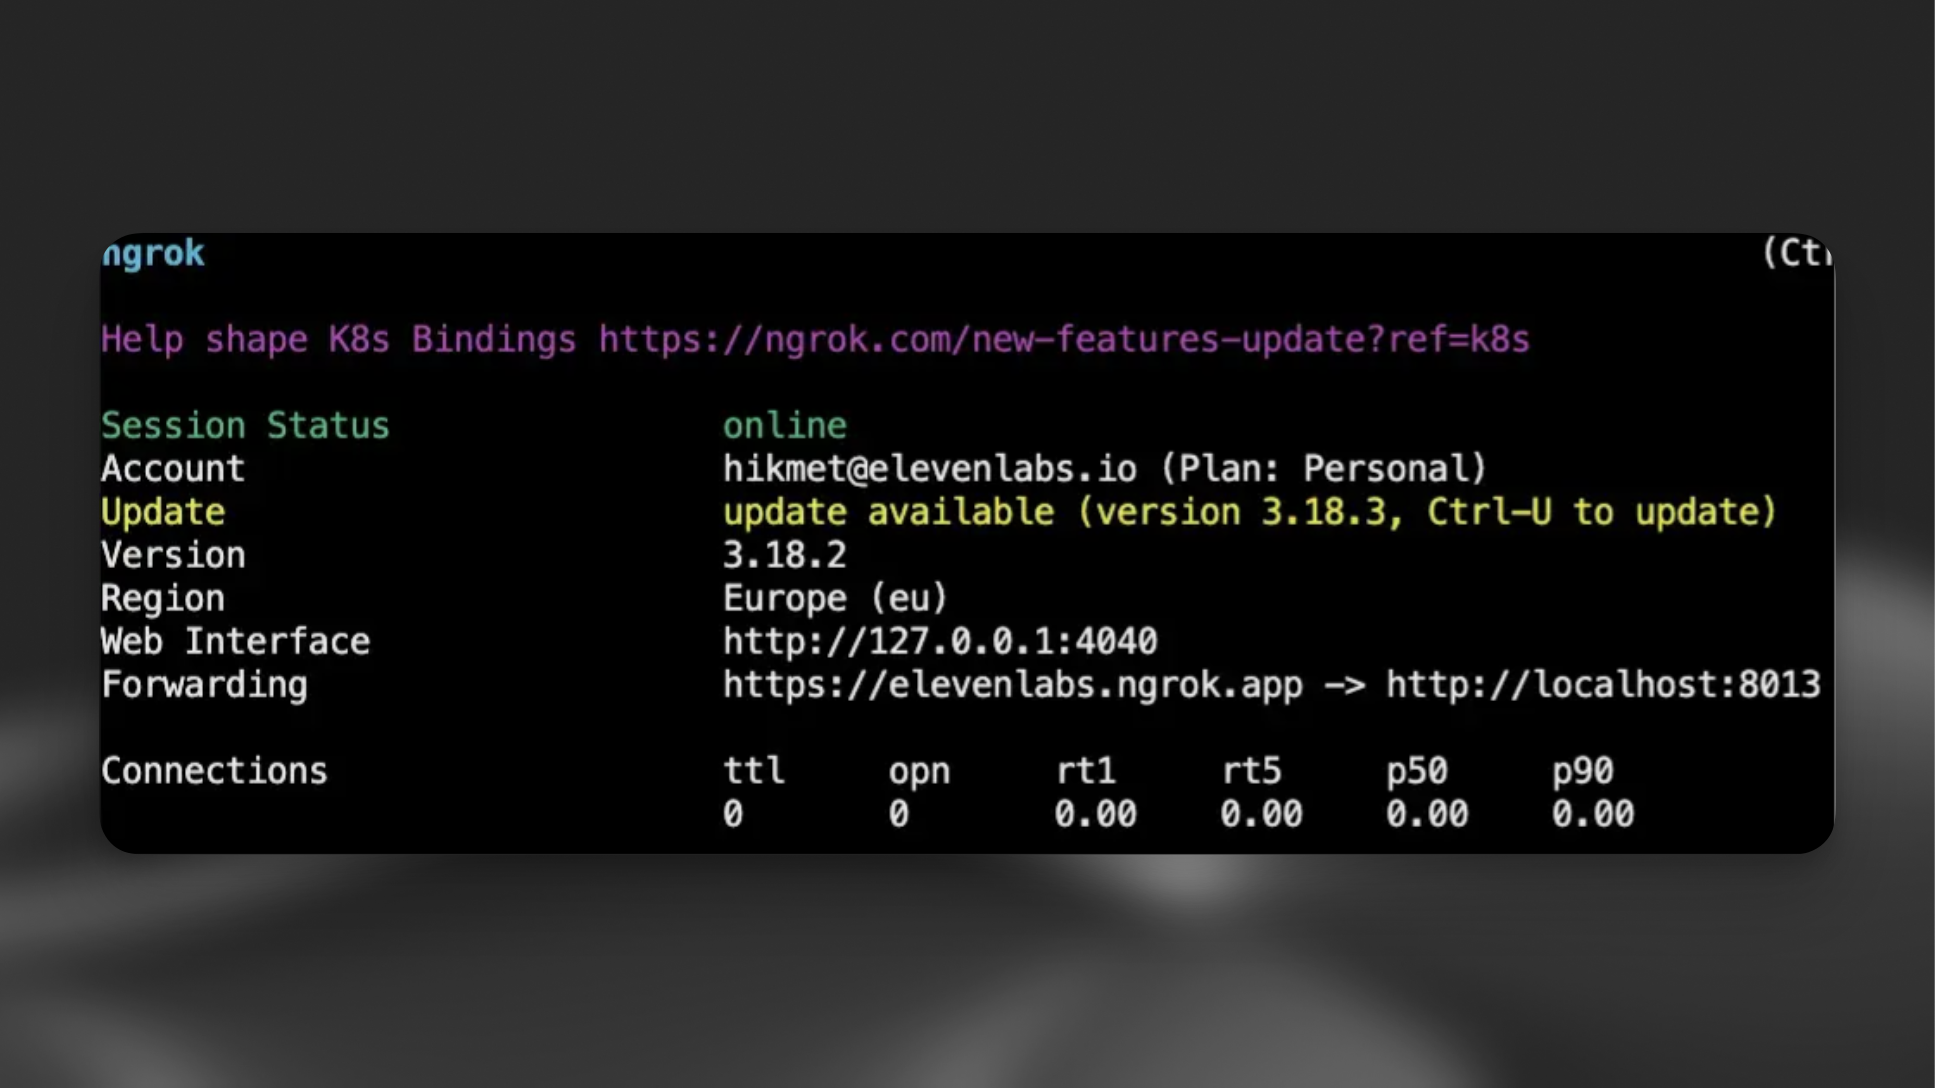
Um Ihren Server zugänglich zu machen, erstellen Sie mit einem Tunneling-Tool wie ngrok eine öffentliche URL:
ElevenLabs CustomLLM konfigurieren
Aktualisieren Sie als Nächstes die Einstellungen Ihres Agenten im ElevenLabs-Dashboard, sodass sie auf Ihren benutzerdefinierten LLM-Server verweisen.
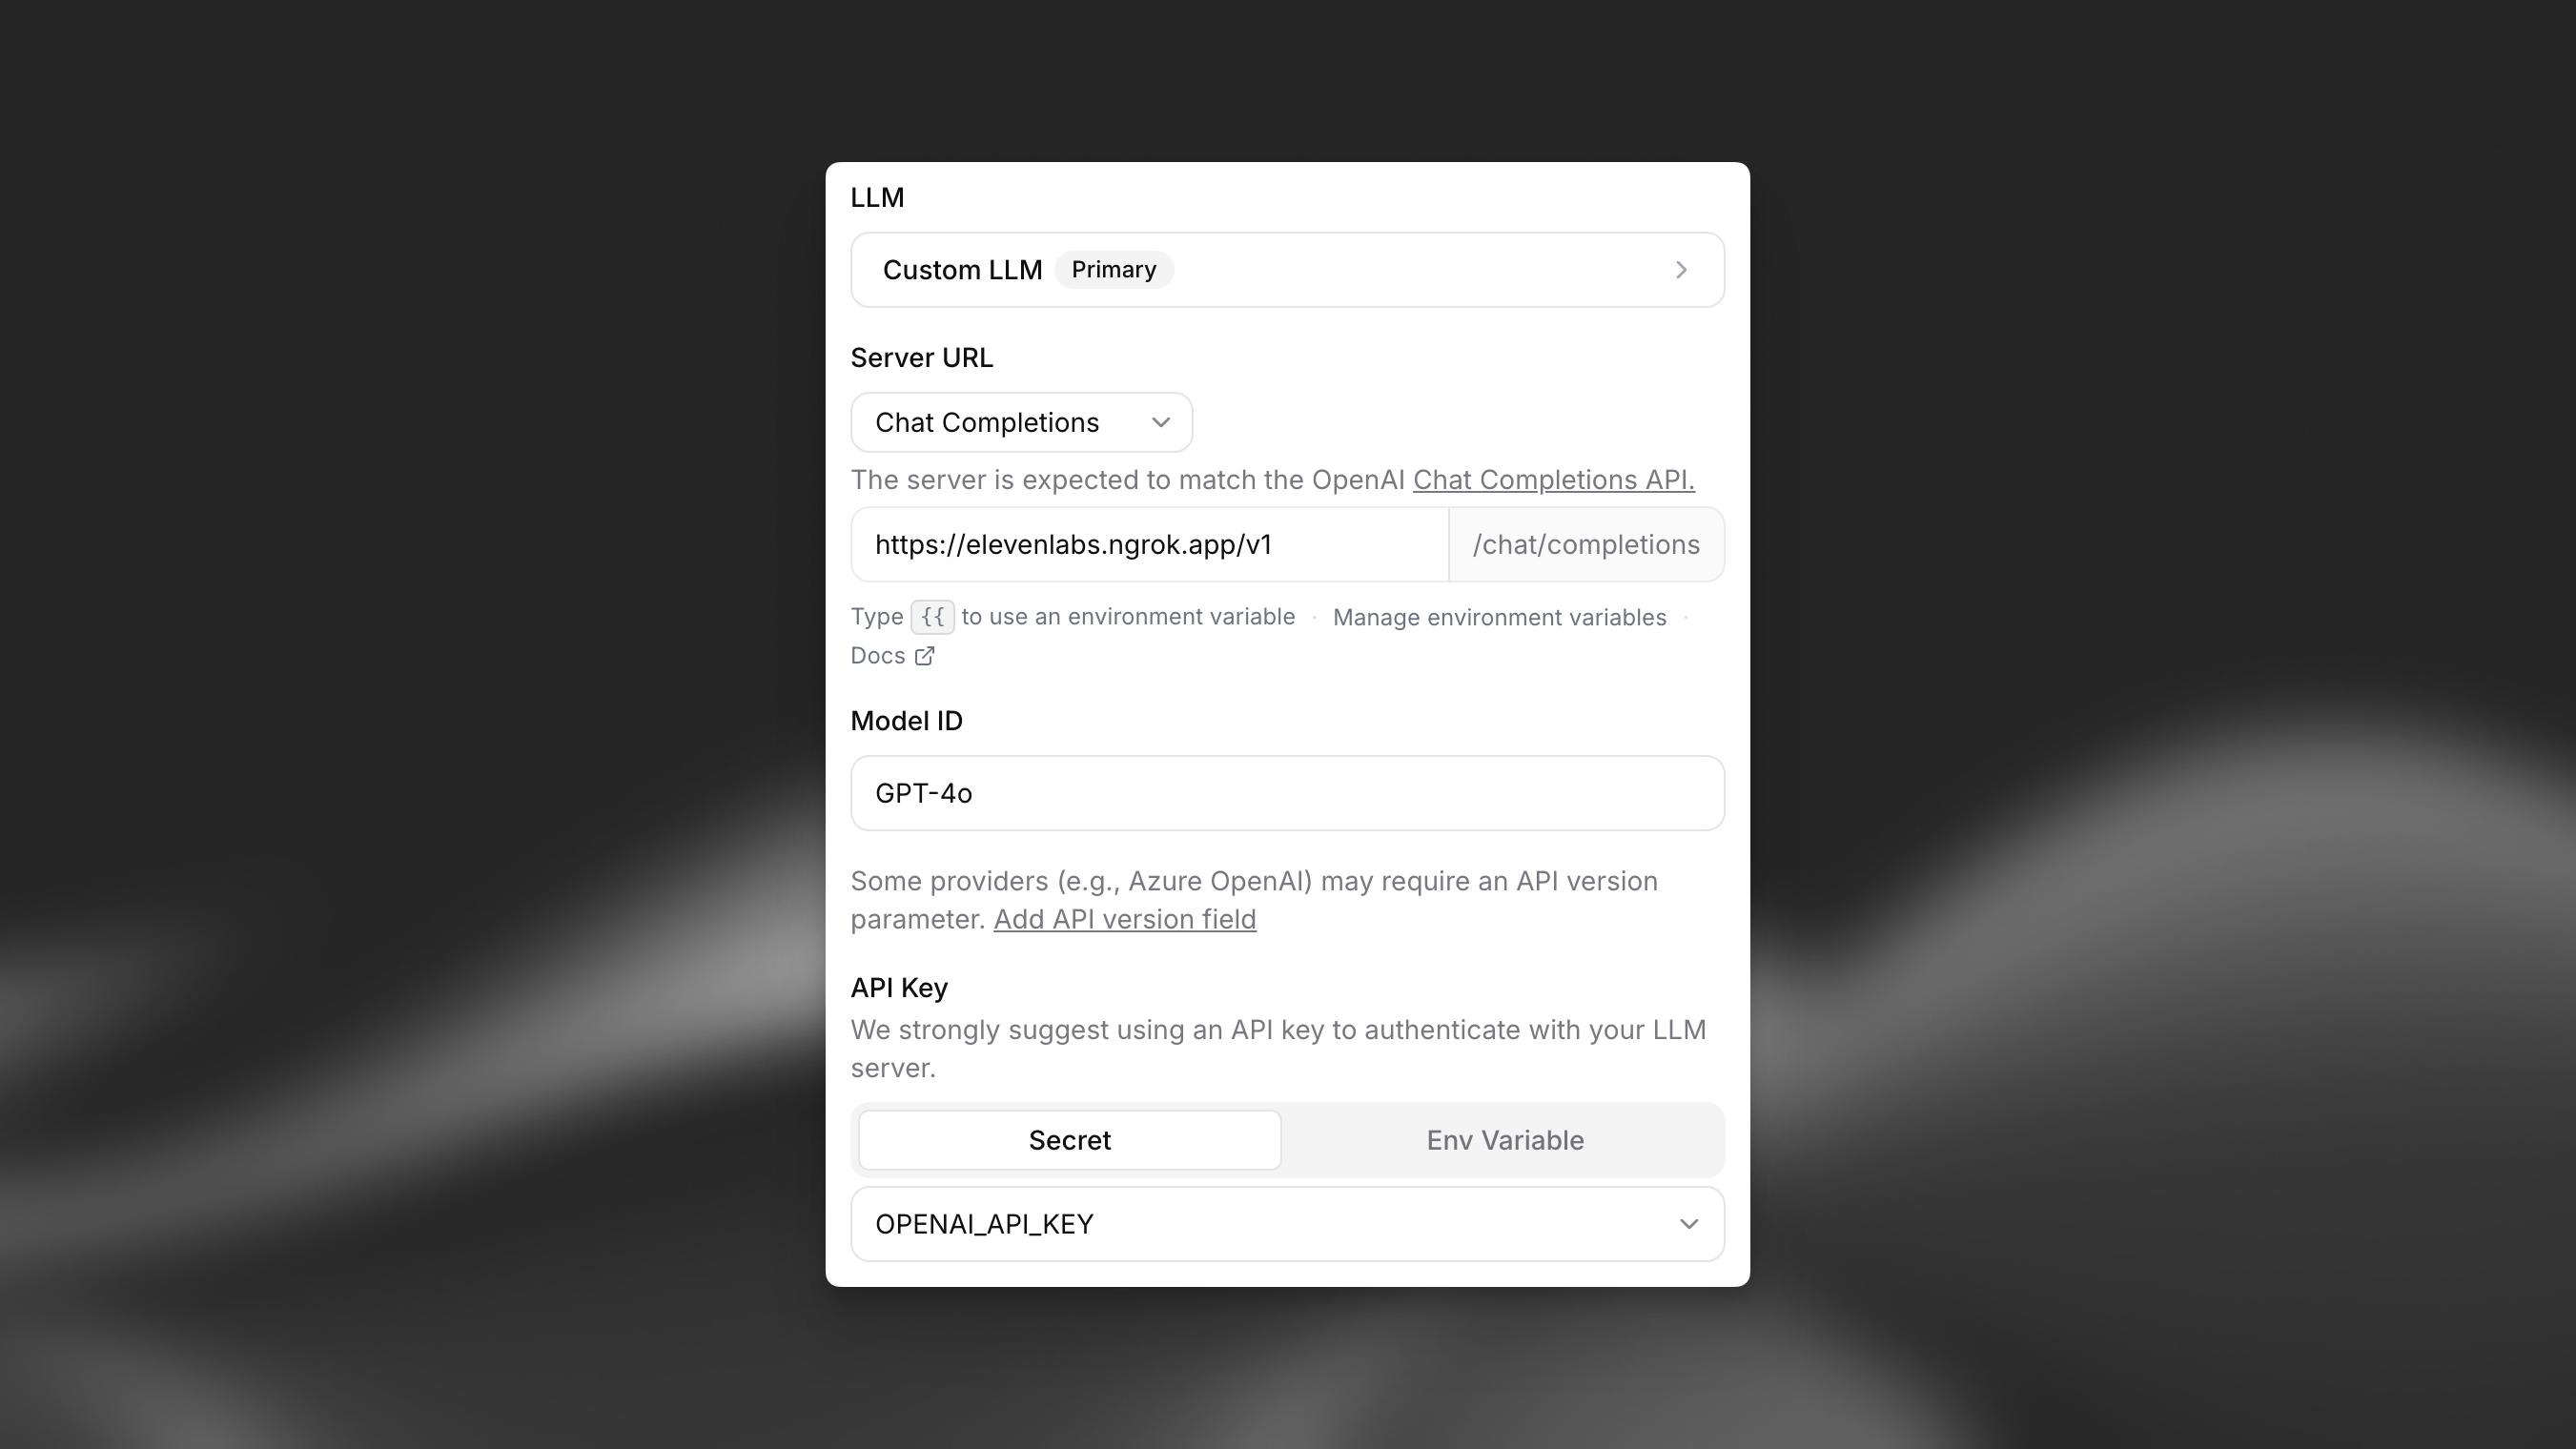
Verweisen Sie Ihre Server-URL auf den ngrok-Endpunkt und setzen Sie „Limit token usage“ auf 5000.
Sie können jetzt mit Ihrem Agenten über Ihren eigenen LLM-Server interagieren.
Optimierung für LLMs mit langsamer Verarbeitung
Wenn Ihr benutzerdefiniertes LLM langsame Verarbeitungszeiten hat (etwa aufgrund von agentischem Reasoning oder Vorverarbeitungsanforderungen), können Sie den Gesprächsfluss verbessern, indem Sie Pufferwörter in Ihren Streaming-Antworten verwenden. Diese Technik sorgt für eine natürliche Sprachprosodie, während Ihr LLM die vollständige Antwort generiert.
Pufferwörter
Wenn Ihr LLM mehr Zeit benötigt, um die vollständige Antwort zu verarbeiten, geben Sie eine erste Antwort zurück, die mit "... " endet (Auslassungspunkte gefolgt von einem Leerzeichen). So kann das Text to Speech-System den natürlichen Fluss beibehalten und das Gespräch dynamisch halten.
Dadurch entstehen natürliche Pausen, die gut in nachfolgende Inhalte übergehen, über die das LLM länger nachdenken kann. Das zusätzliche Leerzeichen ist entscheidend, damit der nachfolgende Inhalt nicht an die ”…” angehängt wird, was zu Audioverzerrungen führen kann.
Implementierung
So passen Sie Ihren benutzerdefinierten LLM-Server an, um Pufferwörter zu implementieren:
Integration von Systemtools
Ihr benutzerdefiniertes LLM kann Systemtools auslösen, um Gesprächsfluss und -status zu steuern. Diese Tools werden automatisch in den Parameter tools Ihrer Chat-Completion-Anfragen aufgenommen, wenn sie in Ihrem Agenten konfiguriert sind.
Funktionsweise von Systemtools
- LLM-Entscheidung: Ihr benutzerdefiniertes LLM entscheidet anhand des Gesprächskontexts, wann diese Tools aufgerufen werden.
- Tool-Antwort: Das LLM antwortet mit Funktionsaufrufen im Standardformat von OpenAI.
- Backend-Verarbeitung: ElevenLabs verarbeitet die Tool-Aufrufe und aktualisiert den Gesprächsstatus.
Weitere Informationen zu Systemtools finden Sie in unserem Leitfaden
Verfügbare Systemtools
Anruf beenden
Zweck: Gespräche automatisch beenden, wenn geeignete Bedingungen erfüllt sind.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- Die Hauptaufgabe abgeschlossen ist und der Nutzer zufrieden ist.
- Das Gespräch mit beiderseitigem Einverständnis zu einem natürlichen Abschluss gekommen ist.
- Der Nutzer ausdrücklich mitteilt, dass er das Gespräch beenden möchte.
Parameter:
reason(String, erforderlich): Der Grund für das Beenden des Anrufs.message(String, optional): Eine Abschiedsnachricht, die vor dem Beenden des Anrufs an den Nutzer gesendet wird.
Format des Funktionsaufrufs:
Implementierung: Konfigurieren Sie das Tool in Ihren Agenteneinstellungen als Systemtool. Das LLM erhält detaillierte Anweisungen dazu, wann es diese Funktion aufrufen soll.
Mehr erfahren: Tool zum Beenden von Anrufen
Spracherkennung
Zweck: Während Gesprächen automatisch zur erkannten Sprache des Nutzers wechseln.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- Der Nutzer in einer anderen Sprache als der aktuellen Gesprächssprache spricht.
- Der Nutzer ausdrücklich darum bittet, die Sprache zu wechseln.
- Das Gespräch Unterstützung für mehrere Sprachen benötigt.
Parameter:
reason(String, erforderlich): Der Grund für den Sprachwechsel.language(String, erforderlich): Der Sprachcode, zu dem gewechselt werden soll (muss in der Liste der unterstützten Sprachen enthalten sein).
Format des Funktionsaufrufs:
Implementierung: Konfigurieren Sie unterstützte Sprachen in den Agenteneinstellungen und fügen Sie das Systemtool zur Spracherkennung hinzu. Der Agent passt Stimme und Antworten automatisch an erkannte Sprachen an.
Mehr erfahren: Tool zur Spracherkennung
Agentenweiterleitung
Zweck: Gespräche je nach Nutzerbedarf zwischen spezialisierten KI-Agenten weiterleiten.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- Die Anfrage des Nutzers Spezialwissen oder andere Agentenfähigkeiten erfordert.
- Der aktuelle Agent die Anfrage nicht ausreichend bearbeiten kann.
- Der Gesprächsverlauf auf den Bedarf eines anderen Agententyps hinweist.
Parameter:
reason(String, optional): Der Grund für die Weiterleitung an einen Agenten.agent_number(Ganzzahl, erforderlich): Nullbasierte Nummer des Agenten, an den weitergeleitet werden soll (basierend auf den konfigurierten Weiterleitungsregeln).
Format des Funktionsaufrufs:
Implementierung: Definieren Sie Weiterleitungsregeln, die Bedingungen bestimmten Agenten-IDs zuordnen. Konfigurieren Sie, an welche Agenten der aktuelle Agent weiterleiten kann. Agenten werden in der Weiterleitungskonfiguration über nullbasierte Nummern referenziert.
Mehr erfahren: Tool zur Agentenweiterleitung
An Menschen weiterleiten
Zweck: Gespräche nahtlos an menschliche Mitarbeitende übergeben, wenn KI-Unterstützung nicht ausreicht.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- Komplexe Probleme menschliches Urteilsvermögen erfordern.
- Der Nutzer ausdrücklich menschliche Unterstützung anfordert.
- Die KI bei der konkreten Anfrage an ihre Leistungsgrenzen stößt.
- Eskalationsprotokolle ausgelöst werden.
Parameter:
reason(String, optional): Der Grund für die Weiterleitung.transfer_number(String, erforderlich): Die Telefonnummer, an die weitergeleitet werden soll (muss mit den konfigurierten Nummern übereinstimmen).client_message(String, erforderlich): Nachricht, die dem Kunden während des Wartens auf die Weiterleitung vorgelesen wird.agent_message(String, erforderlich): Nachricht für den menschlichen Mitarbeitenden, der den Anruf entgegennimmt.
Format des Funktionsaufrufs:
Implementierung: Konfigurieren Sie Weiterleitungsnummern und Bedingungen. Definieren Sie Nachrichten für den Kunden und den menschlichen Mitarbeitenden, der den Anruf übernimmt. Funktioniert mit Twilio und SIP-Trunking.
Mehr erfahren: Tool zur Weiterleitung an Menschen
Zug überspringen
Zweck: Dem Agenten erlauben, zu pausieren und auf Nutzereingaben zu warten, ohne zu sprechen.
Auslösebedingungen: Das LLM sollte dieses Tool aufrufen, wenn:
- Der Nutzer mitteilt, dass er einen Moment braucht (“Give me a second”, “Let me think”).
- Der Nutzer eine Pause im Gesprächsverlauf anfordert.
- Der Agent erkennt, dass der Nutzer Zeit braucht, um Informationen zu verarbeiten.
Parameter:
reason(String, optional): Freitextgrund, der erklärt, warum die Pause erforderlich ist.
Format des Funktionsaufrufs:
Implementierung: Keine zusätzliche Konfiguration erforderlich. Das Tool signalisiert dem Agenten lediglich, still zu bleiben, bis der Nutzer wieder spricht.
Mehr erfahren: Tool zum Überspringen eines Zugs
Mailbox-Erkennung
Parameter:
reason(string, erforderlich): Der Grund für die Erkennung einer Mailbox (z. B. „automatische Begrüßung erkannt“, „keine menschliche Antwort“)
Format des Funktionsaufrufs:
Mehr erfahren: Tool zur Mailbox-Erkennung
Beispielanfrage mit Systemtools
Wenn Systemtools konfiguriert sind, erhält Ihr benutzerdefiniertes LLM Anfragen, die die Tools im Standardformat von OpenAI enthalten:
Ihr benutzerdefiniertes LLM muss Funktionsaufrufe unterstützen, um Systemtools zu verwenden. Stellen Sie sicher, dass Ihr Modell korrekte Antworten für Funktionsaufrufe im OpenAI-Format generieren kann.
Zusätzliche Funktionen
Benutzerdefinierte LLM-Parameter
Sie können zusätzliche Parameter an Ihre benutzerdefinierte LLM-Implementierung übergeben.
Python
Beispielanfrage
Mit dieser benutzerdefinierten Nachrichteneinrichtung erhält Ihr LLM Anfragen in diesem Format: