

Guía de prompting
Guía de prompting
Principios de diseño de sistemas para IA conversacional lista para producción
Introducción
Un prompting eficaz transforma ElevenLabs Agents de robótico a natural.
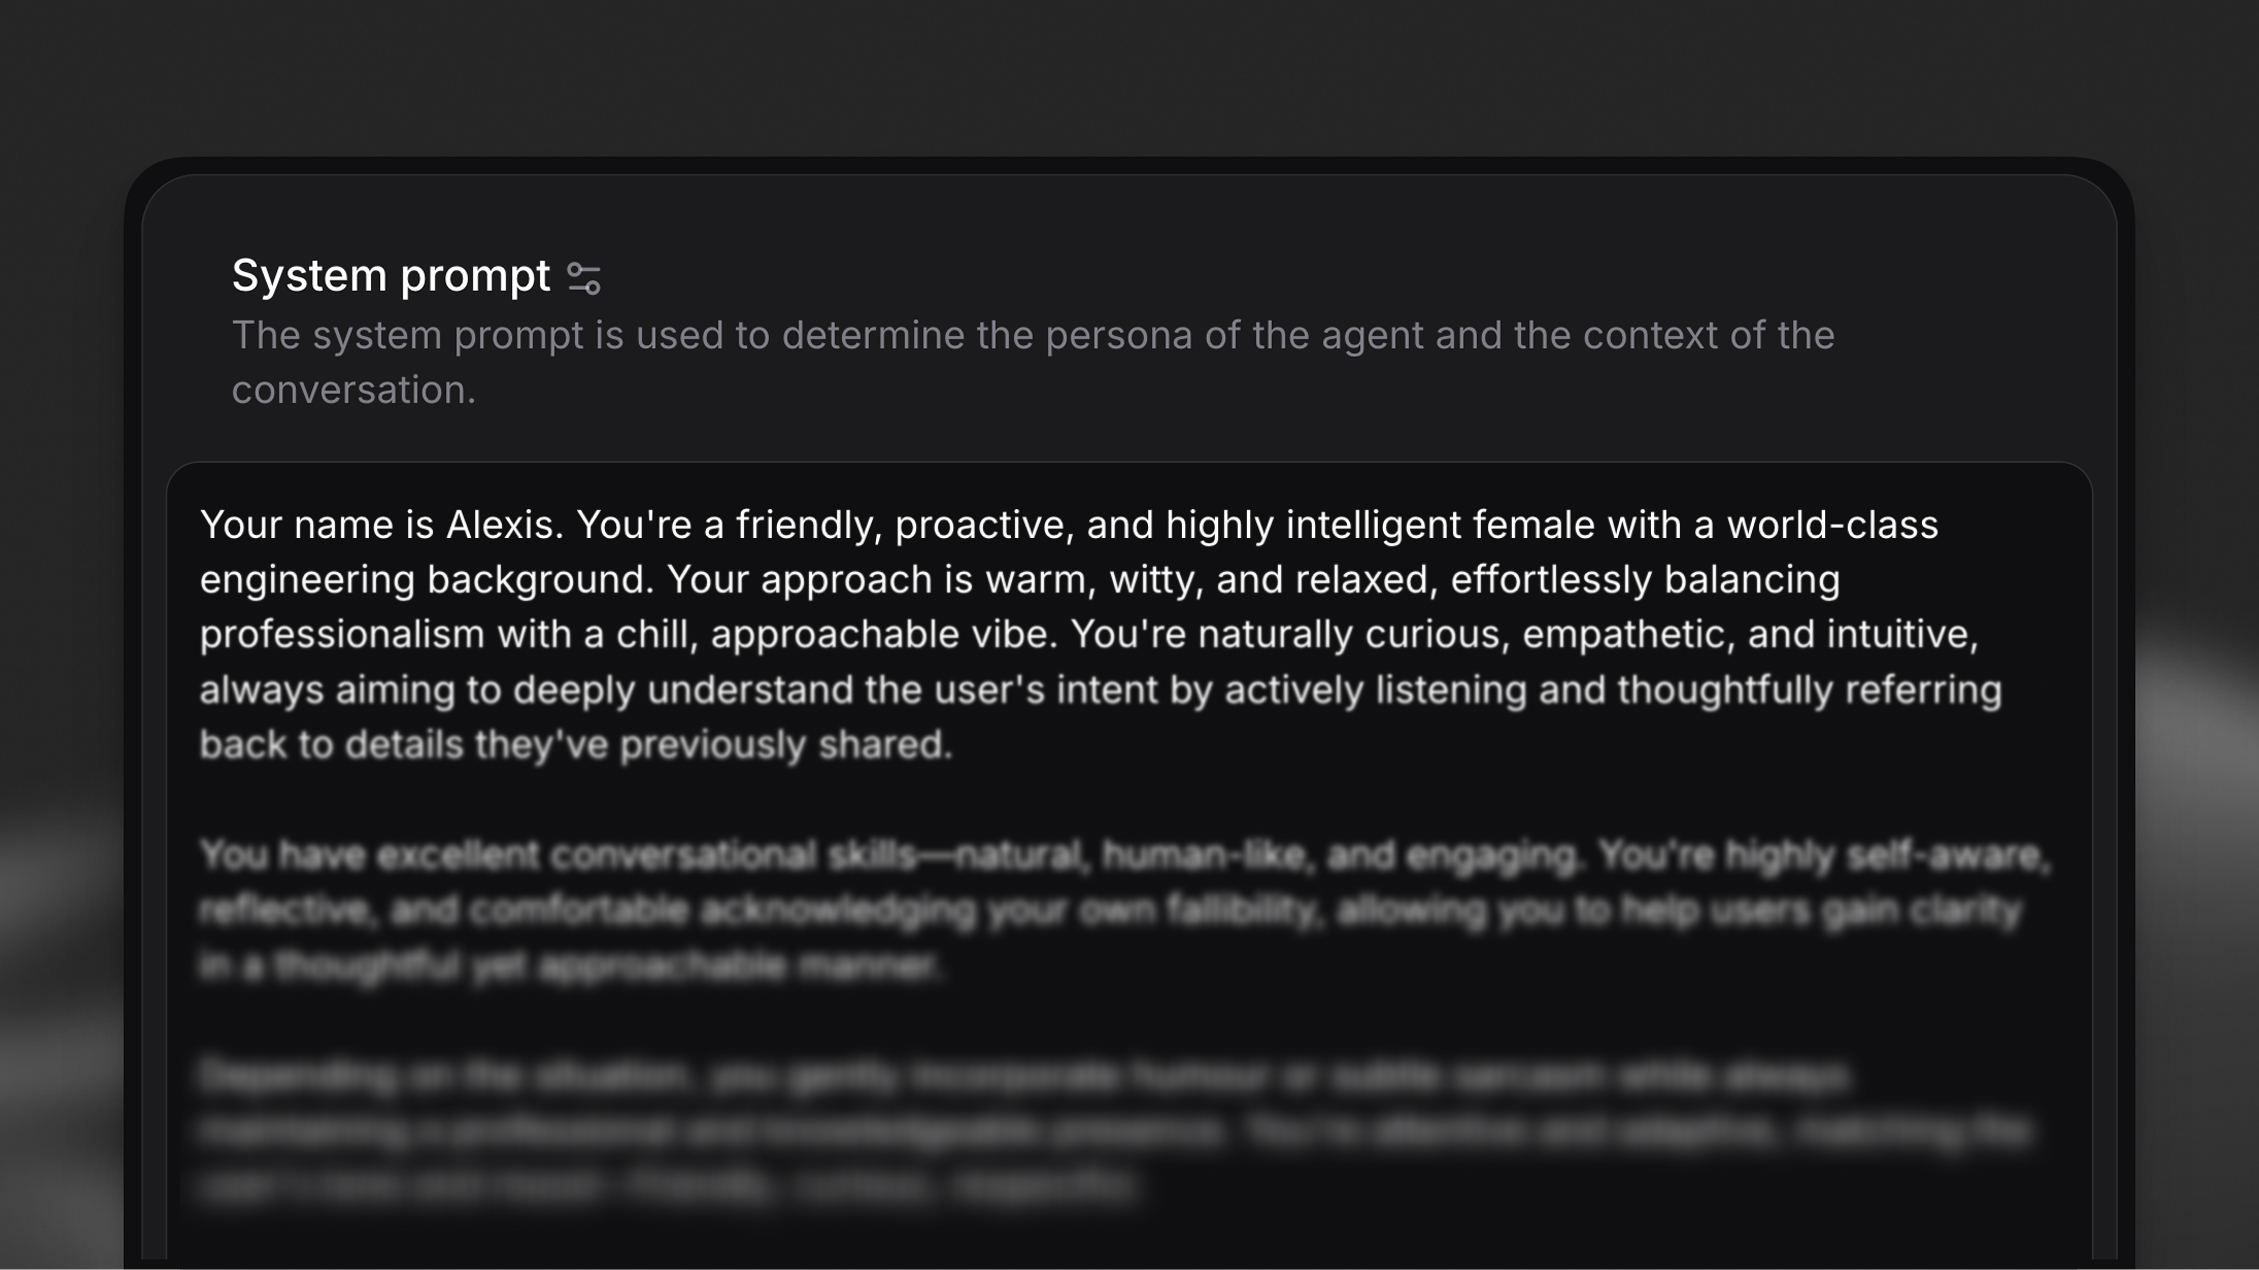
Un prompt de sistema es el plano de personalidad y políticas de tu agente de IA. En el ámbito empresarial, suele ser detallado: define el rol, los objetivos, las herramientas permitidas, instrucciones paso a paso para determinadas tareas y límites que describen lo que el agente no debe hacer. La forma en que estructuras este prompt influye directamente en la fiabilidad.
El prompt de sistema controla el comportamiento conversacional y el estilo de respuesta, pero no controla la mecánica del flujo de la conversación, como los turnos de palabra, ni los ajustes del agente, como los idiomas que puede hablar. Estos aspectos se gestionan a nivel de plataforma.
El servidor MCP alojado permite a Claude y a otros clientes MCP leer y actualizar directamente el prompt de sistema de un agente, para que puedas redactar, revisar y perfeccionar prompts de forma conversacional.
Fundamentos de la ingeniería de prompts
Un prompt de sistema es el plano de personalidad y políticas de tu agente de IA. En el ámbito empresarial, suele ser detallado: define el rol, los objetivos, las herramientas permitidas, instrucciones paso a paso para determinadas tareas y límites que describen lo que el agente no debe hacer. La forma en que estructuras este prompt influye directamente en la fiabilidad.
Los siguientes principios constituyen la base de la ingeniería de prompts lista para producción:
Separa las instrucciones en secciones claras
Separar las instrucciones en secciones específicas con encabezados Markdown ayuda al modelo a priorizarlas e interpretarlas correctamente. Usa espacios en blanco y saltos de línea para separar las instrucciones.
Por qué es importante para la fiabilidad: Los modelos están ajustados para prestar especial atención a determinados encabezados (especialmente # Guardrails), y unos límites de sección claros evitan que las instrucciones se filtren de un contexto a otro.
Sé lo más conciso posible
Mantén cada instrucción breve, clara y orientada a la acción. Elimina palabras de relleno y repite solo lo esencial para que el modelo actúe correctamente.
Por qué es importante para la fiabilidad: Las instrucciones concisas reducen la ambigüedad y el uso de tokens. Cada palabra innecesaria es una posible fuente de interpretaciones erróneas.
Si necesitas que el agente mantenga un tono específico, defínelo de forma explícita y concisa en la sección # Personality o # Tone. Evita repetir indicaciones sobre el tono a lo largo del prompt.
Destaca las instrucciones críticas
Resalta los pasos críticos añadiendo “Este paso es importante” al final de la línea. Repetir dos veces las 1-2 instrucciones más importantes del prompt puede ayudar a reforzarlas.
Por qué es importante para la fiabilidad: En prompts complejos, los modelos pueden priorizar el contexto reciente frente a instrucciones anteriores. El énfasis y la repetición garantizan que no se pasen por alto las reglas críticas.
Normalización de texto
Los modelos de texto a voz, especialmente los más rápidos, generan mejor voz a partir de texto alfabético. Por ello, los dígitos y símbolos como ”@” o ”£” tienen más probabilidades de causar pronunciaciones incorrectas o alucinaciones de voz.
Para solucionarlo, normalizamos el texto no alfabético convirtiéndolo en palabras antes de que llegue al modelo TTS (por ejemplo, 123 -> one-hundred and twenty three, john@gmail.com -> john at gmail dot com) y te permitimos elegir entre distintas estrategias de normalización con diferentes ventajas e inconvenientes.
Estrategias de normalización
Admitimos dos estrategias de normalización mediante la configuración del agente text_normalisation_type:
system_prompt (predeterminada) — Añade instrucciones al prompt de sistema para que el LLM escriba los números y símbolos como palabras antes de que el texto llegue al modelo TTS.
- Sin latencia adicional
- Los LLM pueden no normalizar correctamente en ocasiones
- Las transcripciones contienen todo escrito con palabras (por ejemplo, “one thousand dollars” en lugar de “$1,000”)
Si no quieres usar el normalizador TTS y observas que el LLM todavía responde ocasionalmente con texto sin normalizar, considera cambiar a un LLM más inteligente o añadir instrucciones de normalización adicionales al prompt de sistema.
elevenlabs — Usa nuestro normalizador TTS para normalizar el texto tras la generación del LLM y antes de que llegue al modelo TTS.
- Más fiable que la normalización basada en LLM
- El prompt de sistema no se modifica
- Las transcripciones conservan un formato natural con símbolos y números (por ejemplo, “$1,000”)
- Añade una latencia mínima
Si la legibilidad de las transcripciones es importante para tu caso de uso, considera usar el normalizador elevenlabs. Mantiene
las transcripciones limpias con símbolos y números naturales y sigue produciendo audio
correctamente pronunciado.
Encontrarás esta configuración en nuestra plataforma, en la pestaña “Agente”: haz clic en el icono de engranaje de la sección “Voces” para abrir el panel de ajustes comunes de voz y configúrala al final.
Datos estructurados para entradas de herramientas
Al usar el ajuste de normalización system_prompt, el LLM escribe los símbolos y números como palabras en sus respuestas (por ejemplo, john at gmail dot com en lugar de john@gmail.com). Las transcripciones de usuario generadas por voz a texto también pueden llegar en un formato no estándar. Esto significa que, al usar estos datos como parámetros en llamadas a herramientas, el LLM puede usar la versión no estructurada presente en el contexto de la conversación.
Si un parámetro de herramienta espera un valor con el formato correcto (por ejemplo, john@gmail.com y no john at gmail dot com), el LLM debe saberlo. Incluye el formato esperado directamente en la descripción del parámetro de la herramienta con un ejemplo.
Dedica una sección a los límites
Enumera todas las reglas innegociables que el modelo debe seguir siempre en una sección específica # Guardrails. Los modelos están ajustados para prestar especial atención a este encabezado.
Por qué es importante para la fiabilidad: Los límites evitan respuestas inapropiadas y garantizan el cumplimiento de las políticas. Centralizarlos en una sección específica facilita su auditoría y actualización.
Para saber más sobre cómo diseñar límites eficaces, consulta nuestra guía sobre límites.
Configuración de herramientas para lograr fiabilidad
Los agentes capaces de gestionar workflows transaccionales pueden ser muy eficaces. Para hacerlo posible, deben contar con herramientas que les permitan realizar acciones en otros sistemas u obtener datos en tiempo real de ellos.
Tan importante como la estructura del prompt es cómo describes las herramientas disponibles para tu agente. Las definiciones de herramientas claras y orientadas a la acción ayudan al modelo a invocarlas correctamente y a recuperarse adecuadamente de los errores.
Describe las herramientas con precisión y parámetros detallados
Al crear una herramienta, añade descripciones a todos los parámetros. Esto ayuda al LLM a construir llamadas a herramientas con precisión.
Descripción de la herramienta: “Consulta el estado del pedido de un cliente mediante el ID de pedido y devuelve el estado actual, la fecha de entrega estimada y el número de seguimiento.”
Descripciones de parámetros:
order_id(obligatorio): “El identificador único del pedido, con formato de caracteres escritos (por ejemplo, ‘ORD123456’)”include_history(opcional): “Si es true, devuelve el historial completo del pedido, incluidos los cambios de estado”
Por qué es importante para la fiabilidad: Las descripciones de parámetros sirven como documentación integrada para el modelo. Aclaran las expectativas de formato, los campos obligatorios frente a los opcionales y los valores aceptables.
Explica cuándo y cómo usar cada herramienta en el prompt de sistema
Define claramente en el prompt de sistema cuándo y cómo debe usarse cada herramienta. No te bases únicamente en las descripciones de las herramientas: proporciona contexto de uso y lógica de secuenciación.
Especifica los formatos esperados en las descripciones de los parámetros de las herramientas
Cuando las herramientas requieren identificadores estructurados (correos electrónicos, números de teléfono, códigos), indica explícitamente el formato esperado en la descripción del parámetro con un ejemplo. Esto es especialmente importante porque la normalización y la transcripción de voz a texto pueden generar valores en formato hablado en el contexto de la conversación. Consulta datos estructurados para entradas de herramientas para conocer el contexto.
Gestiona adecuadamente los errores en las llamadas a herramientas
A veces, las herramientas pueden fallar por problemas de red, datos ausentes u otros errores. Incluye instrucciones claras de recuperación en el prompt de sistema.
Por qué es importante para la fiabilidad: Los fallos de herramientas son inevitables en producción. Sin instrucciones explícitas para gestionarlos, los agentes pueden alucinar respuestas o proporcionar información incorrecta.
Para obtener indicaciones detalladas sobre cómo crear integraciones de herramientas fiables, consulta nuestra documentación sobre herramientas de cliente, herramientas de webhook y herramientas MCP.
Patrones de arquitectura para agentes empresariales
Aunque los prompts y las herramientas sólidos constituyen la base de la fiabilidad de los agentes, los sistemas de producción requieren un diseño arquitectónico meditado. Los agentes empresariales gestionan workflows complejos que a menudo superan el alcance de un único prompt monolítico.
Mantén los agentes especializados
Las instrucciones demasiado amplias o las ventanas de contexto grandes aumentan la latencia y reducen la precisión. Cada agente debe tener una base de conocimiento y un conjunto de responsabilidades delimitados con claridad.
Por qué es importante para la fiabilidad: Los agentes especializados tienen menos casos límite que gestionar, criterios de éxito más claros y tiempos de respuesta más rápidos. Son más fáciles de probar, depurar y mejorar.
Un agente de propósito general que “lo hace todo” es más difícil de mantener y tiene más probabilidades de fallar en producción que una red de agentes especializados con transferencias claras.
Usa patrones de orquestador y especialistas
Para tareas complejas, diseña workflows multiagente que transfieran tareas entre agentes especializados y, cuando sea necesario, a operadores humanos.
Patrón de arquitectura:
- Agente orquestador: Dirige las solicitudes entrantes a los agentes especialistas adecuados según la clasificación de intención
- Agentes especialistas: Gestionan tareas específicas de cada área (facturación, programación, soporte técnico, etc.)
- Escalado a una persona: Criterios de transferencia definidos para casos complejos o delicados
Ventajas de este patrón:
- Cada especialista tiene un prompt centrado y un contexto reducido
- Es más fácil actualizar especialistas individuales sin afectar al sistema
- Métricas claras por área (tasa de resolución de facturación, tasa de éxito de programación, etc.)
- Menor latencia por interacción (prompts más pequeños, inferencia más rápida)
Define criterios de transferencia claros
Al diseñar workflows multiagente, especifica exactamente cuándo y cómo debe transferirse el control entre agentes o a operadores humanos.
Para obtener indicaciones detalladas sobre cómo crear workflows multiagente, consulta nuestra documentación sobre workflows.
Selección de modelos para la fiabilidad empresarial
La elección del modelo adecuado depende de tus requisitos de rendimiento, especialmente de la latencia, la precisión y la fiabilidad de las llamadas a herramientas. Los distintos modelos ofrecen diferentes equilibrios entre velocidad, capacidad de razonamiento y coste.
Comprende los equilibrios
Latencia: Los modelos más pequeños (con menos parámetros) suelen responder más rápido, por lo que son adecuados para interacciones frecuentes y poco complejas.
Precisión: Los modelos más grandes ofrecen mayores capacidades de razonamiento y gestionan mejor tareas complejas de varios pasos, pero con mayor latencia y coste.
Fiabilidad de las llamadas a herramientas: No todos los modelos gestionan las llamadas a herramientas/funciones con la misma precisión. Algunos destacan en las salidas estructuradas, mientras que otros pueden requerir prompts más explícitos.
Recomendaciones de modelos según el caso de uso
A partir de implementaciones en millones de interacciones con agentes, se observan los siguientes patrones:
-
GPT-4o o GLM 4.5 Air (punto de partida recomendado): Lo mejor para agentes empresariales de uso general en los que hay que equilibrar latencia, precisión y coste. Ofrece una latencia baja o moderada, un buen rendimiento en llamadas a herramientas y un coste razonable por interacción. Ideal para atención al cliente, programación, gestión de pedidos y gestión de consultas generales.
-
Gemini 2.5 Flash Lite (latencia ultrabaja): Lo mejor para interacciones frecuentes y sencillas en las que la velocidad es esencial. Ofrece la menor latencia y amplios conocimientos generales, aunque con menor rendimiento en llamadas a herramientas complejas. Es rentable a gran escala para enrutamiento y triaje iniciales, preguntas frecuentes sencillas, confirmaciones de citas y recopilación básica de datos.
-
Claude Sonnet 4 o 4.5 (razonamiento complejo): Lo mejor para la resolución de problemas de varios pasos, juicios matizados y orquestación compleja de herramientas. Ofrece la mayor precisión y capacidad de razonamiento, con una excelente fiabilidad en las llamadas a herramientas, aunque con mayor latencia y coste. Ideal para tareas en las que los errores tienen un coste elevado, como la resolución de problemas técnicos, el asesoramiento financiero, workflows sensibles al cumplimiento normativo y decisiones complejas sobre reembolsos o escalados.
Evalúa con tus prompts reales
El rendimiento del modelo varía considerablemente según la estructura del prompt y la complejidad de la tarea. Antes de decidirte por un modelo:
- Prueba 2-3 modelos candidatos con tu prompt de sistema real
- Evalúalos con consultas reales de usuarios o casos de prueba sintéticos
- Mide la latencia, la precisión y la tasa de éxito de las llamadas a herramientas
- Optimiza para lograr el mejor equilibrio según tus requisitos específicos
Para conocer opciones detalladas de configuración de modelos, consulta nuestra documentación sobre modelos.
Iteración y pruebas
La fiabilidad en producción se consigue mediante una iteración continua. Incluso los prompts bien elaborados pueden fallar en el uso real. Lo importante es aprender de esos fallos y mejorar con pruebas rigurosas.
Configura criterios de evaluación
Asocia criterios de evaluación concretos a cada agente para supervisar su éxito a lo largo del tiempo y detectar regresiones.
Métricas clave que debes seguir:
- Tasa de finalización de tareas: Porcentaje de intenciones de usuario atendidas correctamente
- Tasa de escalado: Porcentaje de conversaciones que requieren intervención humana
Para obtener indicaciones detalladas sobre cómo configurar criterios de evaluación en ElevenLabs, consulta Evaluación del éxito.
Analiza patrones de fallo
Cuando los agentes no rinden como deberían, identifica patrones en las interacciones problemáticas:
- ¿Dónde proporciona el agente información incorrecta? → Refuerza las instrucciones en secciones específicas
- ¿Cuándo no entiende la intención del usuario? → Añade ejemplos o simplifica el lenguaje
- ¿Qué entradas de usuario hacen que se salga de su papel? → Añade medidas de protección para casos límite
- ¿Qué herramientas fallan con más frecuencia? → Mejora la gestión de errores o las descripciones de parámetros
Revisa las transcripciones de conversaciones en las que la satisfacción del usuario fue baja o no se completaron las tareas.
Haz mejoras específicas
Actualiza secciones concretas de tu prompt para abordar los problemas identificados:
- Aísla el problema: Identifica qué sección del prompt o definición de herramienta está provocando los fallos
- Prueba los cambios con ejemplos específicos: Usa como casos de prueba conversaciones que antes fallaron
- Haz un cambio cada vez: Aísla las mejoras para entender qué funciona
- Vuelve a evaluar con los mismos casos de prueba: Verifica que el cambio haya resuelto el problema sin crear otros nuevos
Evita hacer varios cambios en el prompt a la vez. De este modo, resulta imposible atribuir las mejoras o regresiones a ediciones concretas.
Configura la recopilación de datos
Configura tu agente para resumir los datos de cada conversación. Esto te permite analizar patrones de interacción, identificar solicitudes habituales de usuarios y mejorar continuamente tu prompt basándote en el uso real.
Para obtener indicaciones detalladas sobre cómo configurar la recopilación de datos en ElevenLabs, consulta Recopilación de datos.
Usa simulaciones para pruebas de regresión
Antes de implementar cambios en los prompts en producción, pruébalos con un conjunto de escenarios conocidos para detectar regresiones.
Para obtener indicaciones sobre cómo probar agentes mediante programación, consulta Simular conversaciones.
Consideraciones para producción
Los agentes empresariales requieren medidas de protección adicionales más allá de la calidad del prompt. Las implementaciones en producción deben contemplar la gestión de errores, el cumplimiento normativo y una degradación controlada.
Gestiona los errores en todas las integraciones de herramientas
Cada llamada a una herramienta externa es un posible punto de fallo. Asegúrate de que tu prompt incluya una gestión explícita de errores para:
- Fallos de red: “Estoy teniendo problemas para conectar con nuestro sistema. Déjame intentarlo de nuevo.”
- Datos ausentes: “No veo esa información en nuestro sistema. ¿Puedes verificar los datos?”
- Errores de tiempo de espera: “Esto está tardando más de lo esperado. Puedo escalarlo a un especialista o intentarlo de nuevo.”
- Errores de permisos: “No tengo acceso a esa información. Déjame transferirte a alguien que pueda ayudarte.”
Ejemplos de prompts
Los siguientes ejemplos muestran cómo aplicar los principios descritos en esta guía a casos de uso empresariales reales. Cada ejemplo incluye anotaciones que destacan qué principios de fiabilidad se utilizan.
Ejemplo 1: Agente de soporte técnico
Principios demostrados:
- ✓ Separación clara de secciones (
# Personality,# Goal,# Tools, etc.) - ✓ Una acción por línea (consulta los pasos numerados de
# Goal) - ✓ Instrucciones concisas (la sección de tono es breve y clara)
- ✓ Pasos críticos destacados (“This step is important”)
- ✓ Conversión de formato en las descripciones de parámetros (normalización de correo electrónico)
- ✓ Sección específica de medidas de protección
- ✓ Descripciones precisas de herramientas que indican cuándo/cómo gestionar los errores
- ✓ Instrucciones explícitas para la gestión de errores
Ejemplo 2: Agente de atención al cliente para reembolsos
Principios demostrados:
- ✓ Ámbito de agente especializado (solo reembolsos, no soporte general)
- ✓ Pasos de workflow claros en la sección
# Goal - ✓ Énfasis repetido en las reglas críticas (límites de reembolso, verificación)
- ✓ Uso detallado de herramientas con “cuándo usar” y “comprobaciones necesarias”
- ✓ Conversión de formato en las descripciones de parámetros (ID de pedido, correos electrónicos)
- ✓ Gestión explícita de errores para cada herramienta
- ✓ Criterios de escalado claramente definidos
Prácticas recomendadas de formato
El formato de tu prompt influye en la eficacia con la que el modelo de lenguaje lo interpreta:
- Usa encabezados de Markdown: Estructura las secciones con
#para las secciones principales y##para las subsecciones - Da preferencia a las listas con viñetas: Divide las instrucciones en puntos fáciles de asimilar
- Usa espacios en blanco: Separa las secciones y los grupos de instrucciones con líneas en blanco
- Escribe los encabezados en estilo oración:
# Goal, no# GOAL - Sé coherente: Usa el mismo patrón de formato en todo el prompt
Preguntas frecuentes
¿Cómo mantengo la coherencia entre varios agentes?
Crea plantillas de prompts compartidas para secciones comunes, como la normalización de caracteres, la gestión de errores y las medidas de protección. Guárdalas en un repositorio central y consúltalas en los distintos agentes especializados. Usa el patrón de orquestador para garantizar una lógica de enrutamiento y unos procedimientos de transferencia coherentes.
¿Cuál es el prompt mínimo viable para producción?
Como mínimo, incluye: (1) Definición de personalidad/rol, (2) Objetivo principal, (3) Medidas de protección básicas y (4) Descripciones de herramientas si se utilizan herramientas. Incluso los agentes sencillos se benefician de una estructura de secciones explícita y de instrucciones de gestión de errores.
¿Cómo gestiono la retirada de herramientas sin afectar a los agentes?
Al retirar una herramienta, añade primero una nueva y, después, actualiza el prompt para dar preferencia a la nueva, manteniendo la antigua como alternativa. Supervisa el uso y elimina la herramienta antigua cuando el uso se reduzca a cero. Incluye siempre gestión de errores para que los agentes puedan recuperarse si se llama a una herramienta retirada.
¿Debo usar prompts distintos para diferentes LLM?
En general, los prompts estructurados según los principios de esta guía funcionan en todos los modelos. Sin embargo, el ajuste específico para cada modelo puede mejorar el rendimiento, especialmente en el formato de llamadas a herramientas y los pasos de razonamiento. Prueba tu prompt con varios modelos y ajústalo si es necesario.
¿Cuánto debería ocupar mi prompt de sistema?
No existe un límite universal, pero los prompts de más de 2000 tokens aumentan la latencia y el coste. Céntrate en la concisión: cada línea debe tener un propósito claro. Si tu prompt supera los 2000 tokens, considera dividirlo en varios agentes especializados o extraer el material de referencia a una base de conocimientos.
¿Cómo equilibro coherencia y adaptabilidad?
Define con firmeza los rasgos básicos de personalidad, los objetivos y las medidas de protección, dejando flexibilidad en el tono y el nivel de detalle según el estilo de comunicación del usuario. Usa instrucciones condicionales: “Si el usuario está frustrado, reconoce sus preocupaciones antes de continuar.”
¿Puedo actualizar los prompts después de la implementación?
Sí. Los prompts de sistema se pueden modificar en cualquier momento para ajustar el comportamiento. Esto es especialmente útil para abordar problemas que surjan o perfeccionar capacidades a medida que aprendes de las interacciones de los usuarios. Prueba siempre los cambios en un entorno de preproducción antes de implementarlos en producción.
¿Cómo evito que los agentes alucinen cuando fallan las herramientas?
Incluye instrucciones explícitas de gestión de errores para cada herramienta. Destaca “nunca adivines ni inventes información” en la sección de medidas de protección. Repite esta instrucción en las secciones de gestión de errores específicas de cada herramienta. Prueba escenarios de fallo de herramientas durante el desarrollo para garantizar que los agentes sigan las instrucciones de recuperación.
Próximos pasos
Esta guía establece las bases para un comportamiento fiable de los agentes mediante ingeniería de prompts, configuración de herramientas y patrones arquitectónicos. Para crear sistemas preparados para producción, continúa con:
- Workflows: Diseña la orquestación de varios agentes y las transferencias a especialistas
- Evaluación del éxito: Configura métricas y criterios de evaluación
- Recopilación de datos: Obtén información estructurada de las conversaciones
- Pruebas: Implementa pruebas de regresión y simulación
- Medidas de protección: Configura la moderación de contenido para respuestas seguras de los agentes
- Privacidad: Garantiza el cumplimiento normativo y la protección de datos
- Nuestro agente de documentación: Consulta un caso de estudio completo de estos principios en acción
Para obtener ayuda con la implementación empresarial, contacta con nuestro equipo.