

独自モデルを統合する
独自モデルを統合する
独自のLLMにエージェントを接続するか、独自のサーバーをホストします。
Custom LLMでは、外部エンドポイントを介して会話を独自のLLMに接続できます。 ElevenLabsはネイティブ統合LLMにも対応しています。
Custom LLMでは、独自のOpenAI APIキーを使用することも、完全にカスタムなLLMサーバーを実行することもできます。
概要
デフォルトでは、OpenAIなどの人気モデルに対して独自の内部認証情報を使用します。カスタムLLMサーバーを使用するには、次のいずれかのOpenAI互換リクエスト/レスポンス構造に対応している必要があります:
- Chat Completions API(
/v1/chat/completions) - Responses API(
/v1/responses)
Responses APIは、追加機能をサポートするOpenAIの新しいAPI形式です。どちらのAPI形式も、 カスタムLLM統合で完全にサポートされています。
次のガイドでは、両方のユースケースを説明します:
- 独自のOpenAIキーを使用する:独自のOpenAI APIキーをプラットフォームで使用します。
- カスタムLLMサーバー:独自のLLMサーバー実装をホストして接続します。
以下の方法を学べます:
- OpenAI APIキーをElevenLabsに保存する
- OpenAIのChat CompletionsまたはResponsesエンドポイントを再現するサーバーをホストする
- ElevenLabsをカスタムエンドポイントに接続する
- 必要に応じてLLMに追加パラメータを渡す
推論の要約
エンドポイントは、最終回答とは別に推論を返す必要があります。ElevenLabsは最終回答から推論を生成しません。
サポートされているエンドポイントから推論をリクエストするには、エージェントのLLM設定でReasoning summaryをオンにするか、API経由でenable_reasoning_summaryを設定します。
推論を返す
エンドポイントに一致する形式を使用してください:
Chat Completions API
Responses API
各レスポンスデルタのreasoningまたはreasoning_contentフィールドで推論をストリーミングします。
Gemini互換エンドポイントの場合、ElevenLabsは
google.thinking_config.include_thoughtsで思考をリクエストし、
extra_content.google.thoughtでマークされたコンテンツを読み取ります。
保存、配信、制限については推論の要約を参照してください。
独自のOpenAIキーを使用する
カスタムOpenAIキーを統合するには、ElevenLabsダッシュボードでエージェント設定を更新してカスタムLLMサーバーを指定し、OPENAI_API_KEYを含むシークレットを作成します:
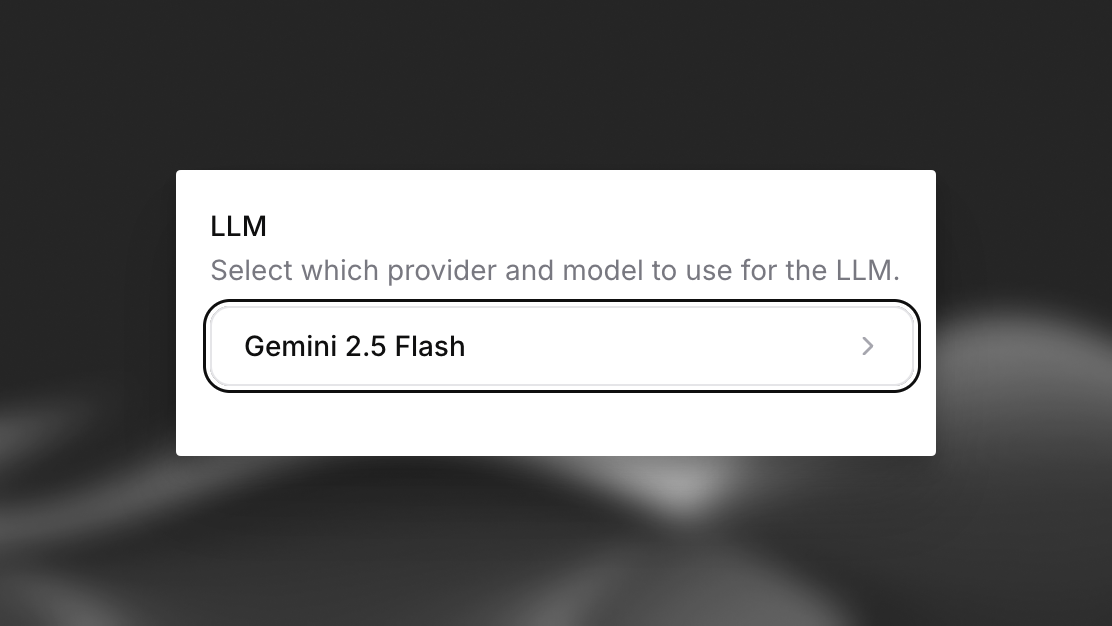
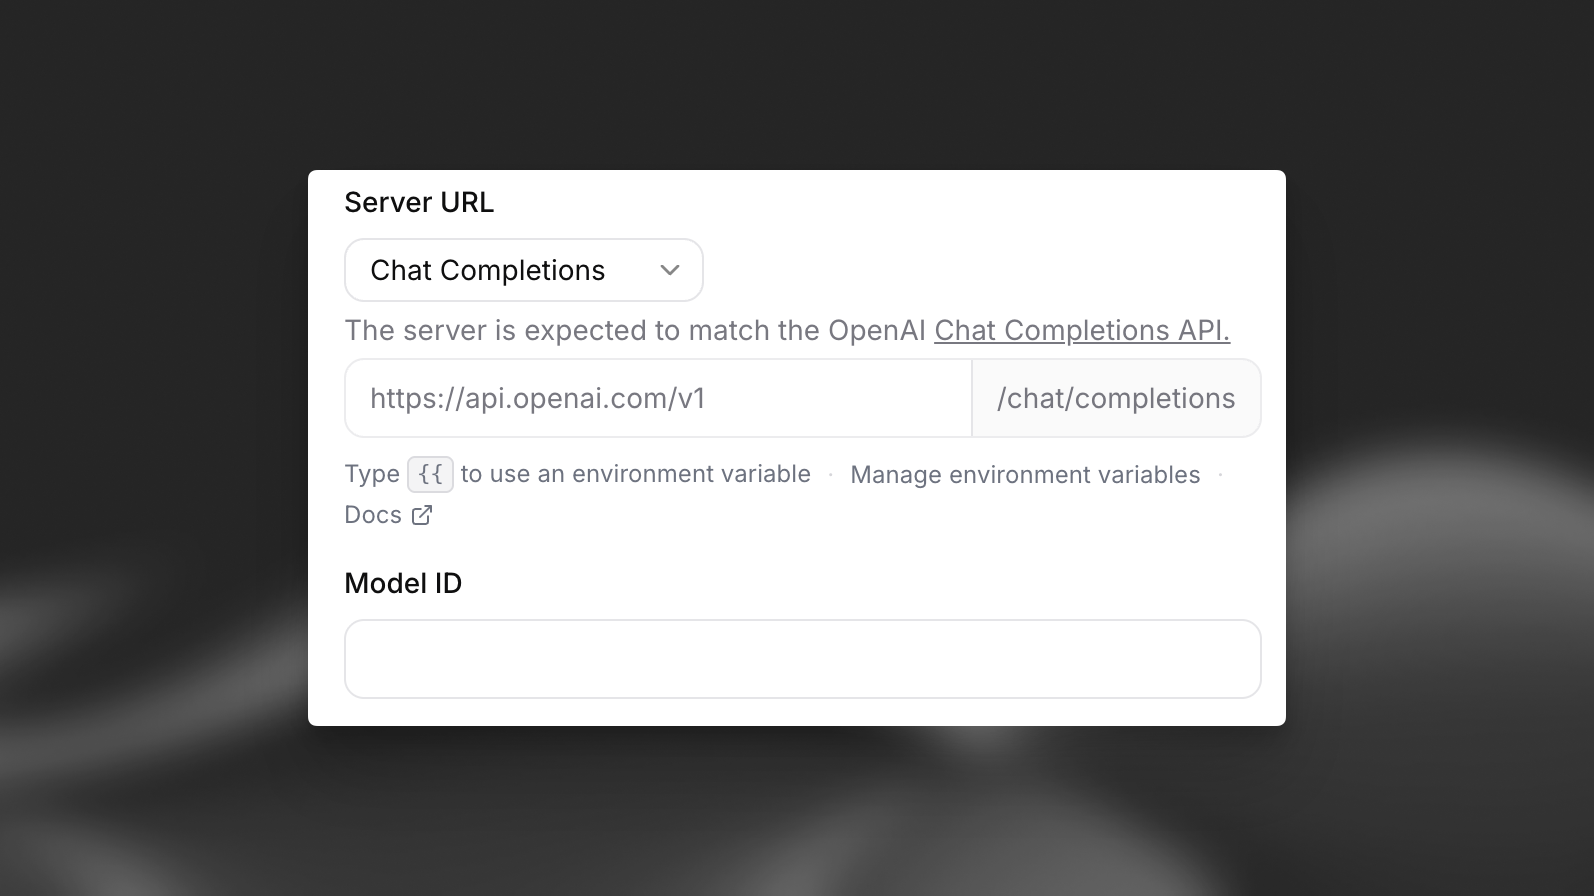
カスタムLLMサーバー
カスタムLLMサーバーを使用するには、OpenAI形式を利用した互換性のあるサーバーエンドポイントを設定します。Chat Completions API(/v1/chat/completions)またはResponses API(/v1/responses)のどちらかを実装できます。
どちらのエンドポイントも、Content-Type: text/event-streamを使用したSSE(Server-Sent Events)形式でレスポンスを返す必要があります。
Chat Completions API
Responses API
Chat Completions APIは/v1/chat/completionsエンドポイントを使用します。
各チャンクはdata: {json}\n\n形式で、ストリームはdata: [DONE]\n\nで終了する必要があります。
サーバー実装の例を示します:
このコード、または独自のサーバーコードを実行します。
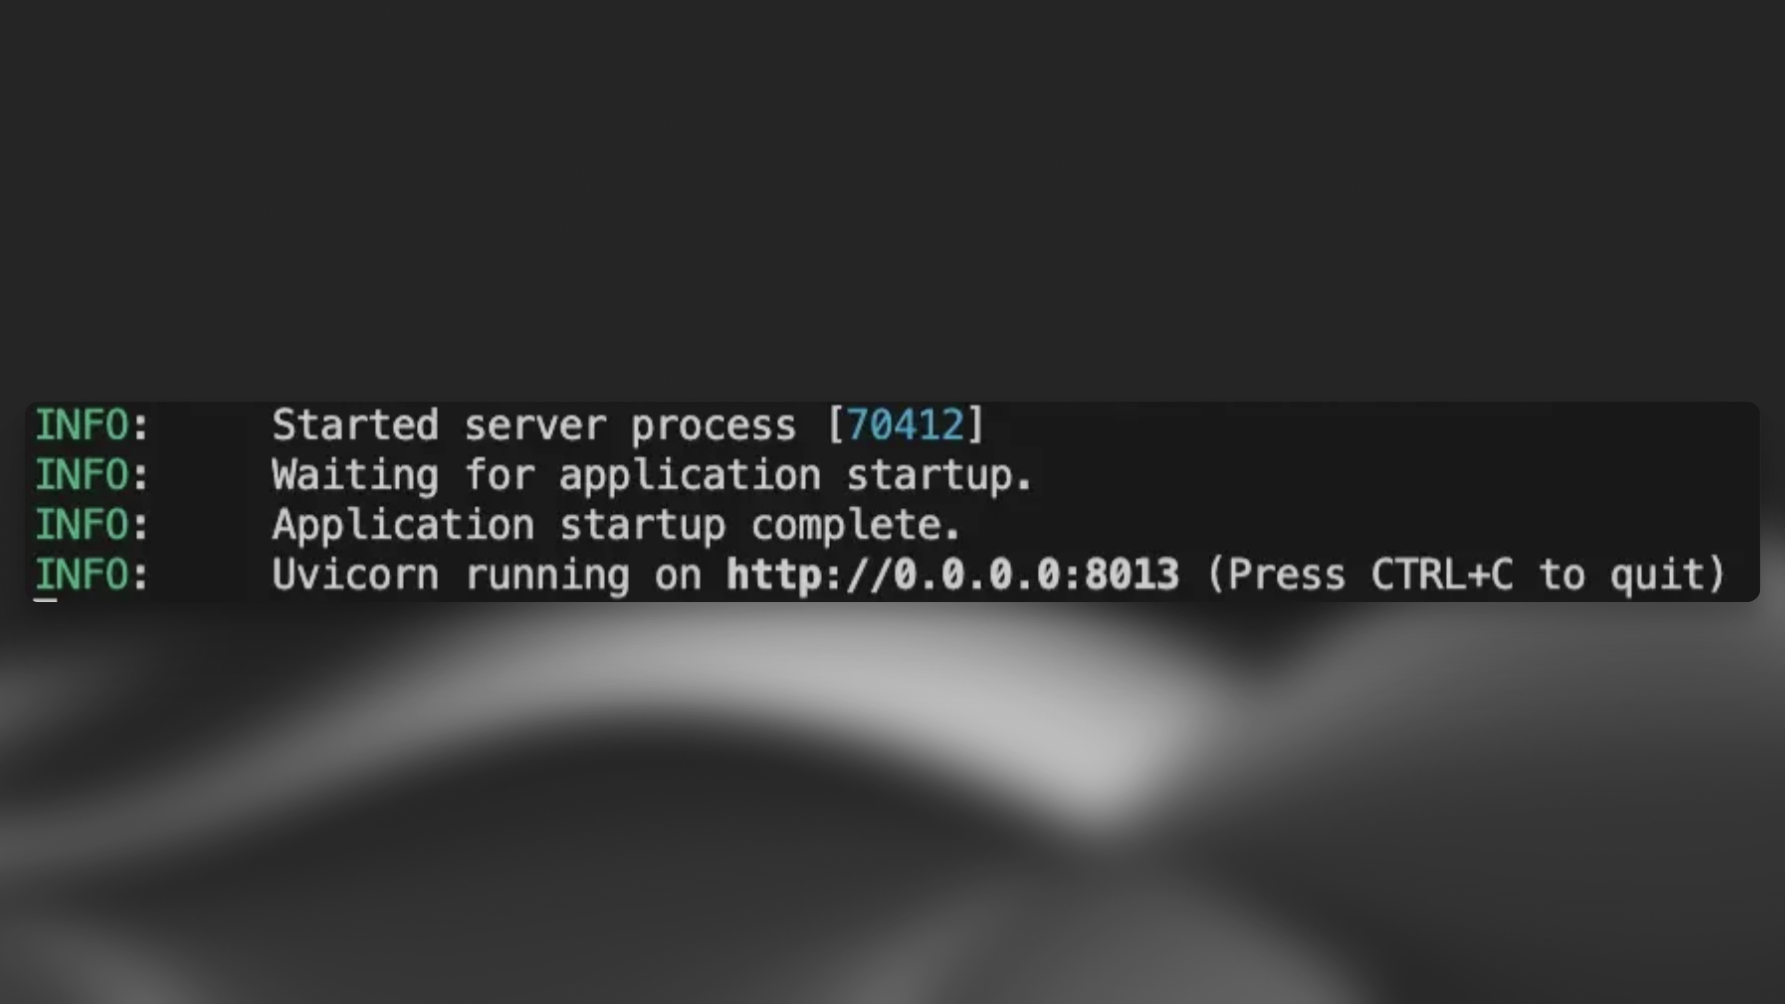
サーバーの公開URLを設定する
サーバーにアクセスできるようにするには、ngrokなどのトンネリングツールを使用して公開URLを作成します:
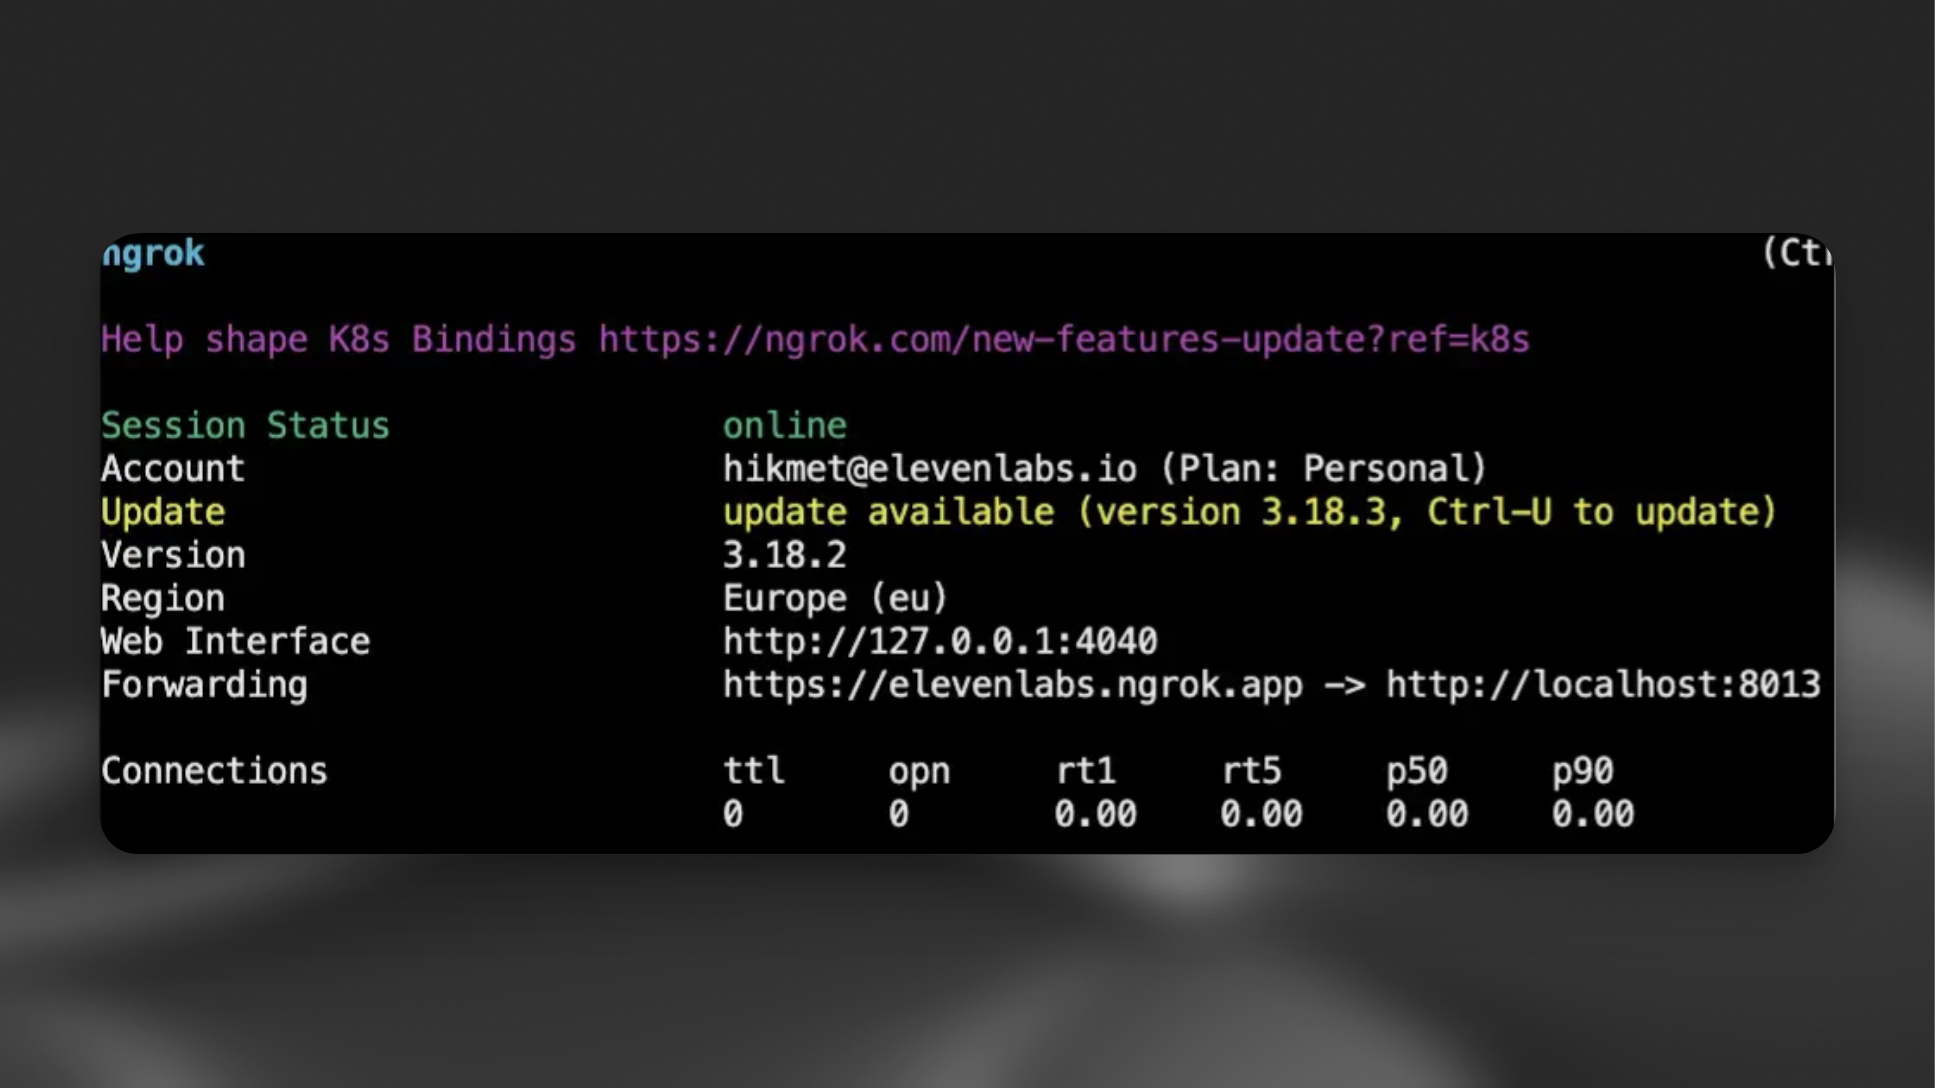
ElevenLabs CustomLLMを設定する
次に、ElevenLabsダッシュボードでエージェント設定を更新して、カスタムLLMサーバーを指定します。
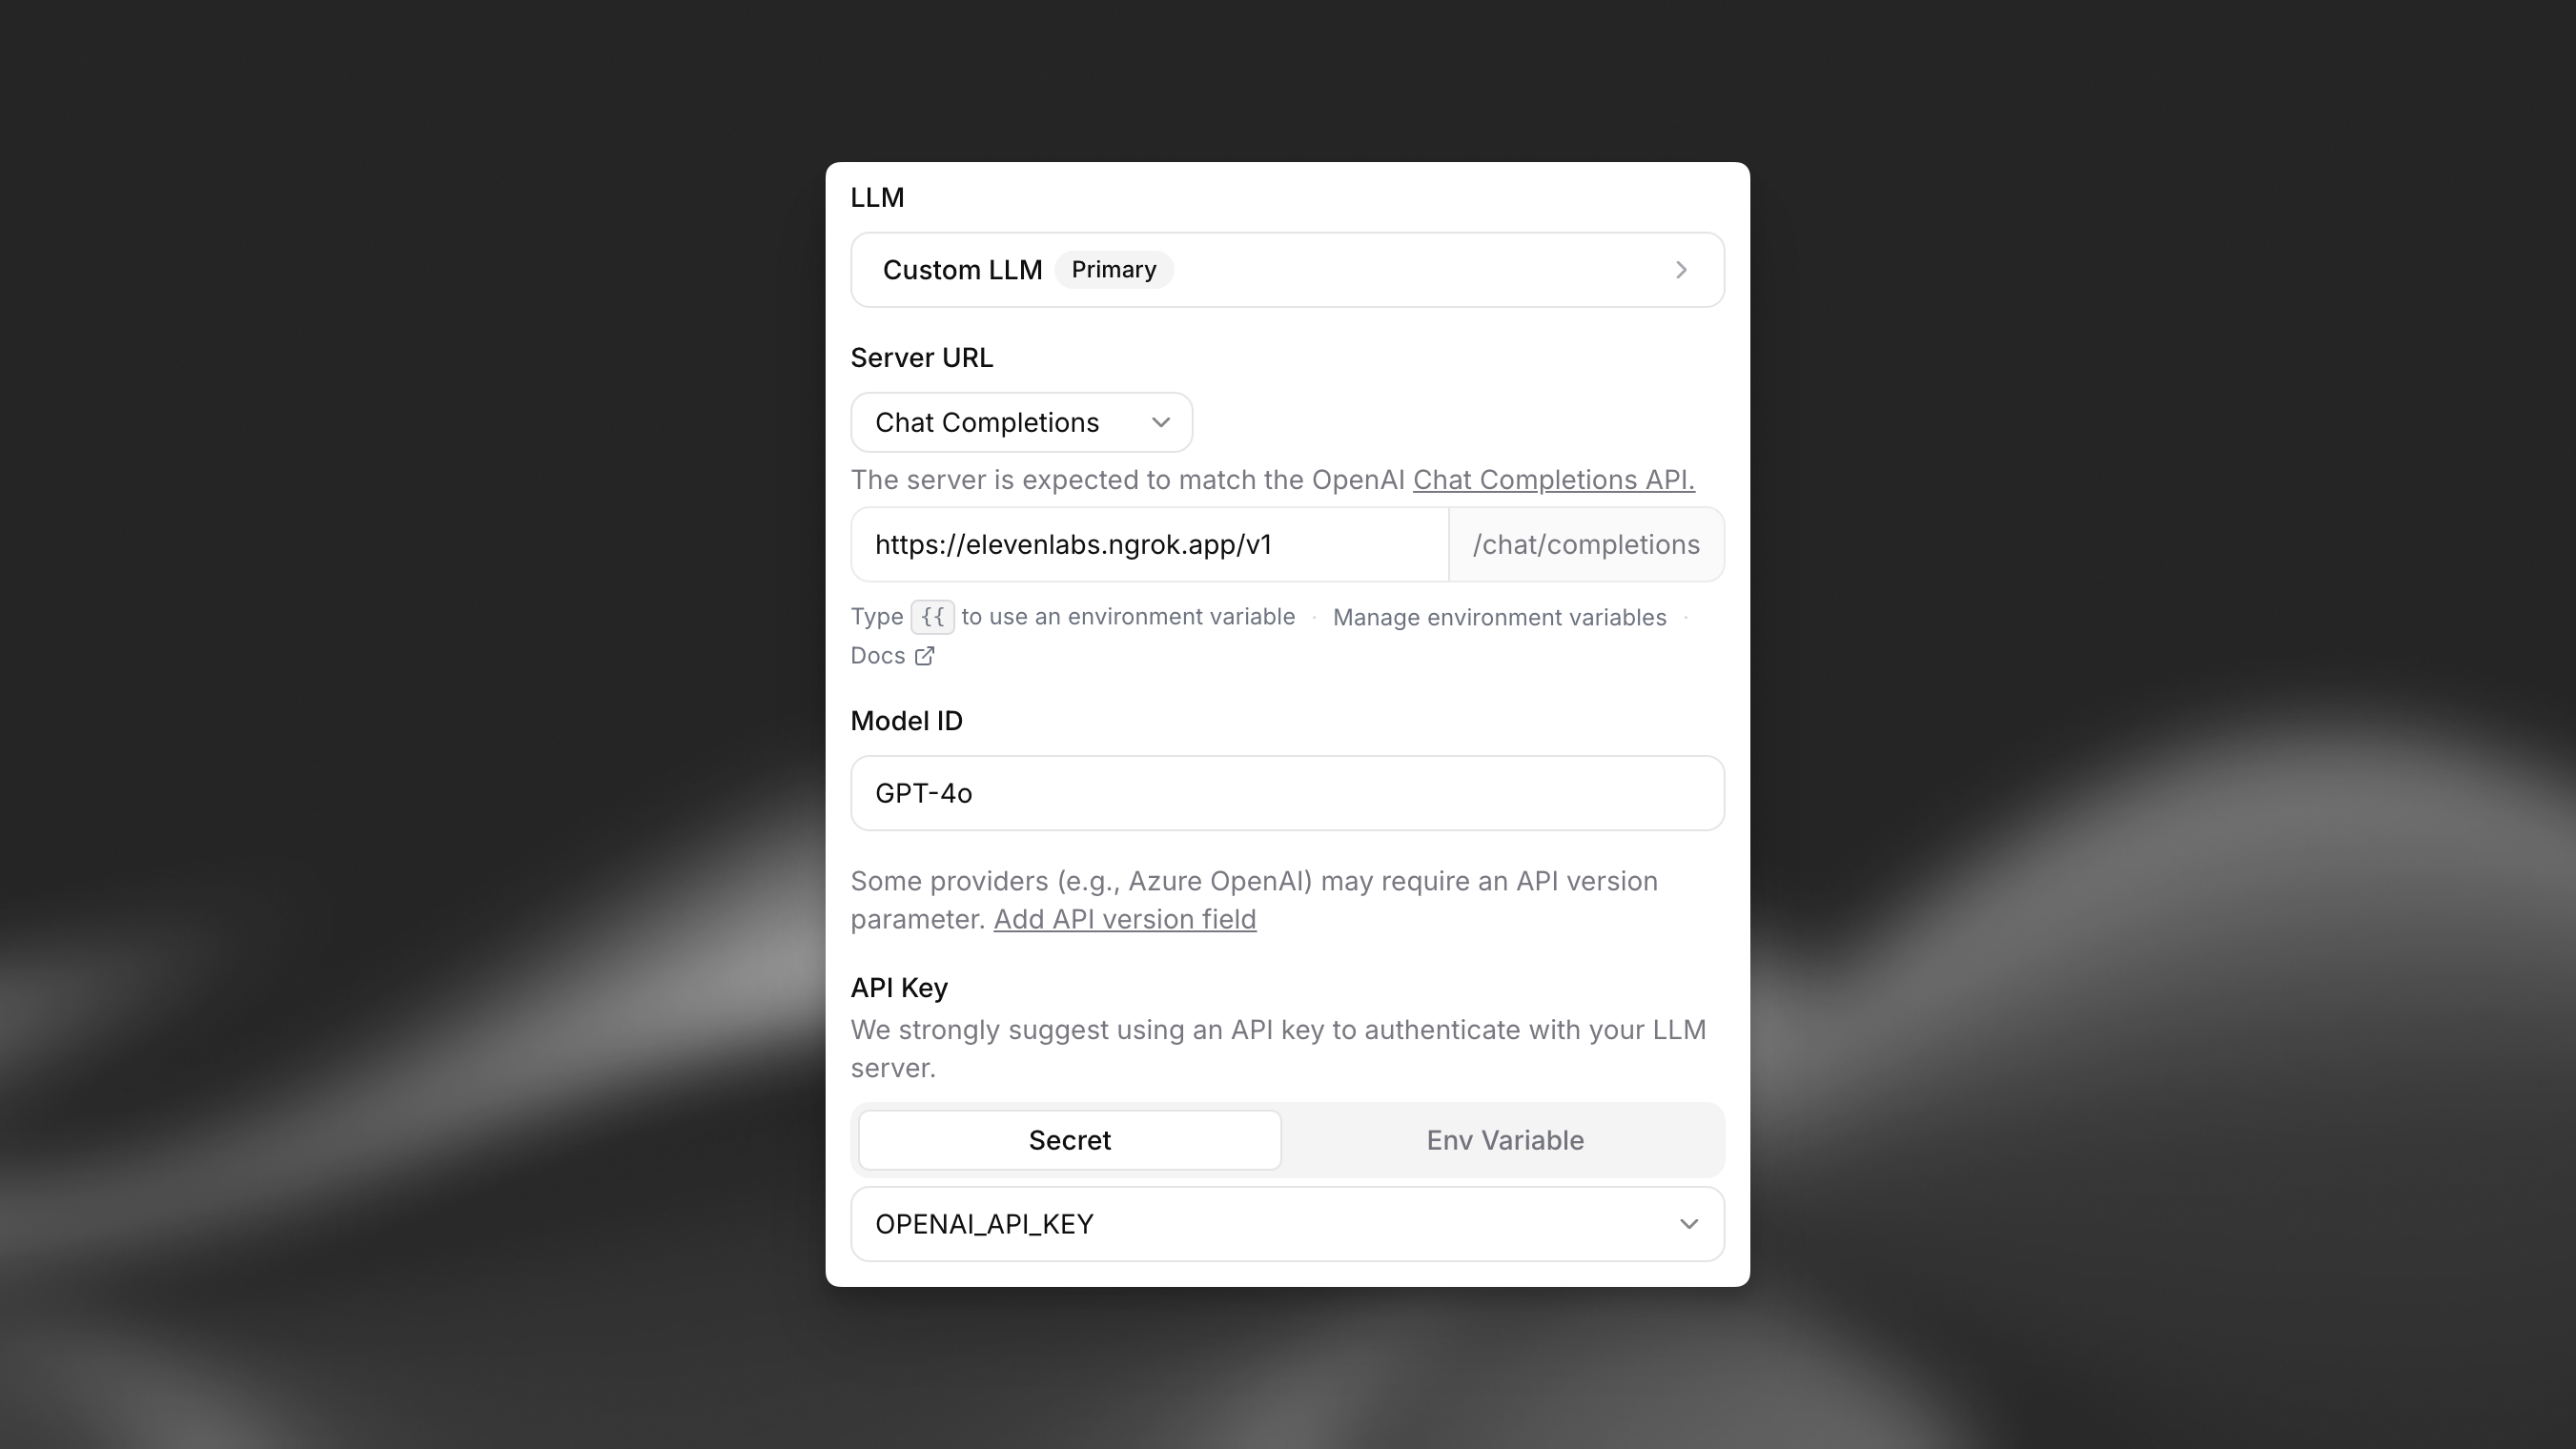
サーバーURLをngrokエンドポイントに指定し、「Limit token usage」を5000に設定します。
これで、独自のLLMサーバーを使用してエージェントとやり取りできます。
処理が遅いLLMの最適化
カスタムLLMの処理時間が遅い場合(エージェント型推論や前処理が必要な場合など)、ストリーミングレスポンスにバッファワードを実装すると、会話の流れを改善できます。この手法では、LLMが完全なレスポンスを生成している間も、自然な発話のプロソディを維持できます。
バッファワード
LLMが完全なレスポンスの処理により時間を要する場合は、末尾が"... "(省略記号の後にスペース)となる初期レスポンスを返します。これにより、会話の動的な感覚を保ちながら、テキスト読み上げシステムが自然な流れを維持できます。
これにより、LLMがより長く推論できる後続コンテンツへと自然につながる間が生まれます。後続のコンテンツが"..."に連結されるとオーディオの歪みにつながる可能性があるため、追加のスペースは重要です。
実装
カスタムLLMサーバーを変更してバッファワードを実装する方法は次のとおりです。
システムツールの統合
カスタムLLMは、システムツールをトリガーして、会話のフローと状態を制御できます。これらのツールは、エージェントで設定すると、チャット完了リクエストのtoolsパラメータに自動的に含まれます。
システムツールの仕組み
- LLMによる判断:カスタムLLMは会話のコンテキストに基づき、これらのツールを呼び出すタイミングを判断します
- ツールレスポンス:LLMは標準のOpenAI形式で関数呼び出しを返します
- バックエンド処理:ElevenLabsがツール呼び出しを処理し、会話の状態を更新します
システムツールの詳細については、ガイドをご覧ください。
利用可能なシステムツール
通話を終了
目的:適切な条件が満たされたときに、会話を自動的に終了します。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- 主なタスクが完了し、ユーザーが満足している
- 双方の合意により会話が自然に終了した
- ユーザーが会話を終了したいと明示的に示している
パラメータ:
reason(string、必須):通話を終了する理由message(string、任意):通話終了前にユーザーへ送信する別れのメッセージ
関数呼び出し形式:
実装:エージェント設定でシステムツールとして構成します。LLMは、この関数を呼び出すタイミングに関する詳細な指示を受け取ります。
詳細:通話終了ツール
言語検出
目的:会話中に検出されたユーザーの言語へ自動的に切り替えます。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- ユーザーが現在の会話言語とは異なる言語で話している
- ユーザーが言語の切り替えを明示的にリクエストしている
- 会話に多言語サポートが必要である
パラメータ:
reason(string、必須):言語を切り替える理由language(string、必須):切り替え先の言語コード(対応言語リストに含まれている必要があります)
関数呼び出し形式:
実装:エージェント設定で対応言語を構成し、言語検出システムツールを追加します。エージェントは、検出された言語に合わせて音声とレスポンスを自動的に切り替えます。
詳細:言語検出ツール
エージェント転送
目的:ユーザーのニーズに応じて、専門分野を持つAIエージェント間で会話を転送します。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- ユーザーのリクエストに専門知識や別のエージェント機能が必要である
- 現在のエージェントではクエリを十分に処理できない
- 会話の流れから別の種類のエージェントが必要であることが示されている
パラメータ:
reason(string、任意):エージェント転送の理由agent_number(integer、必須):転送先エージェントのゼロ始まり番号(構成された転送ルールに基づく)
関数呼び出し形式:
実装:条件を特定のエージェントIDにマッピングする転送ルールを定義します。現在のエージェントが転送できるエージェントを構成します。エージェントは転送設定でゼロ始まりの番号により参照されます。
詳細:エージェント転送ツール
人間に転送
目的:AIの支援が不十分な場合に、会話を人間のオペレーターへシームレスに引き継ぎます。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- 人間の判断が必要な複雑な問題
- ユーザーが人間の支援を明示的に求めている
- 特定のリクエストに対してAIの能力の限界に達している
- エスカレーションプロトコルがトリガーされている
パラメータ:
reason(string、任意):転送の理由transfer_number(string、必須):転送先の電話番号(設定済みの番号と一致する必要があります)client_message(string、必須):転送を待つ間にクライアントへ読み上げるメッセージagent_message(string、必須):通話を受ける人間のオペレーター向けメッセージ
関数呼び出し形式:
実装:転送先の電話番号と条件を構成します。顧客と通話を受ける人間のオペレーターの両方に対するメッセージを定義します。TwilioとSIPトランキングの両方に対応しています。
詳細:人間への転送ツール
ターンをスキップ
目的:エージェントが発話せずに、一時停止してユーザー入力を待てるようにします。
トリガー条件:LLMは次の場合にこのツールを呼び出す必要があります。
- ユーザーが少し時間が必要だと示している(「少々お待ちください」「考えさせてください」)
- ユーザーが会話フローの一時停止をリクエストしている
- エージェントがユーザーに情報を処理する時間が必要だと検出している
パラメータ:
reason(string、任意):一時停止が必要な理由を説明する自由形式の理由
関数呼び出し形式:
実装:追加の構成は必要ありません。このツールは、ユーザーが再び話すまでエージェントが沈黙を保つよう通知するだけです。
詳細:ターンスキップツール
留守番電話検出
システムツールを含むリクエスト例
システムツールを構成すると、カスタムLLMは標準のOpenAI形式でツールを含むリクエストを受け取ります。
システムツールを使用するには、カスタムLLMが関数呼び出しに対応している必要があります。モデルがOpenAI形式で 適切な関数呼び出しレスポンスを生成できることを確認してください。