

データ収集
データ収集
連絡先情報やビジネスデータなどの構造化情報を会話から抽出します。
データ収集では、LLMを活用した分析により、会話の文字起こしから構造化された情報を自動で抽出します。手作業なしで価値あるデータポイントを取得できるため、業務効率とデータ精度が向上します。
概要
データ収集では、会話の文字起こしを分析し、定義した特定の情報を特定・抽出します。抽出されたデータは指定した形式で構造化され、後続の処理や分析に利用できます。
対応データ型
データ収集では、さまざまな情報形式に対応する4種類のデータ型を利用できます。
- 文字列:テキストベースの情報(名前、メールアドレス、住所)
- ブール値:真偽値(同意状況、適格性)
- 整数:整数値(数量、年齢、評価)
- 数値:小数値(価格、割合、測定値)
設定
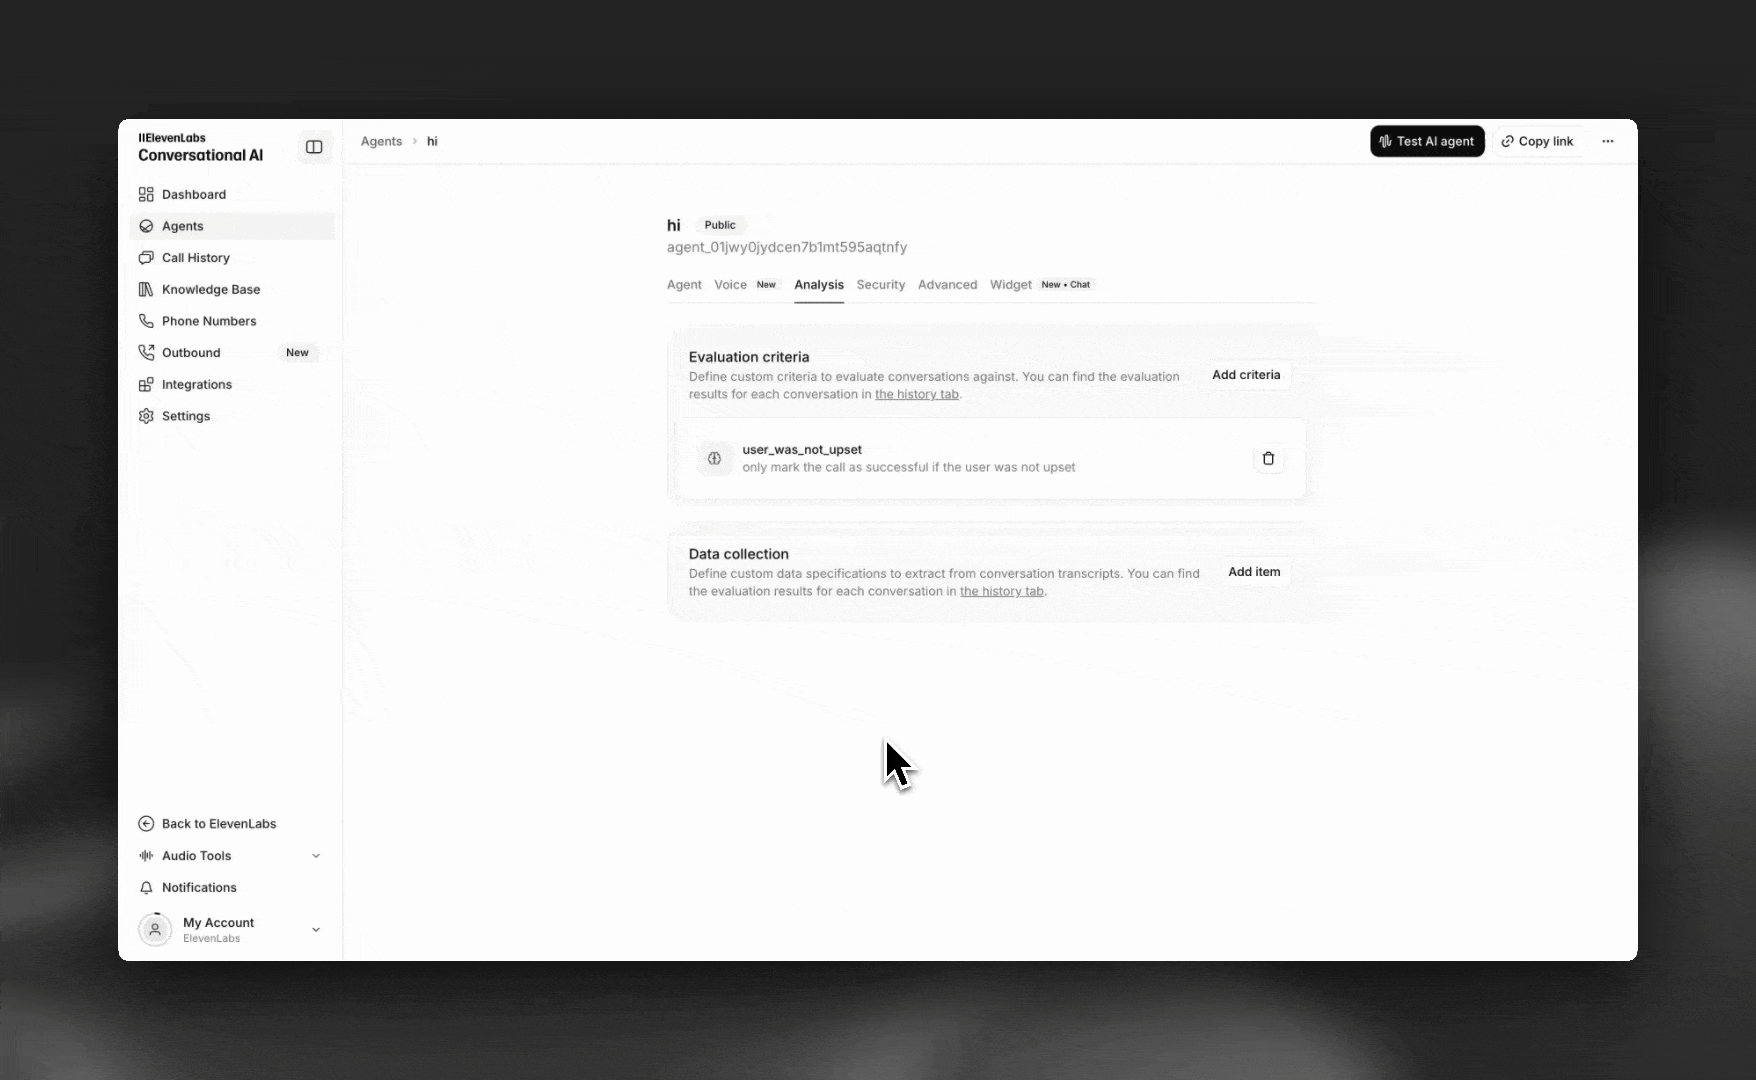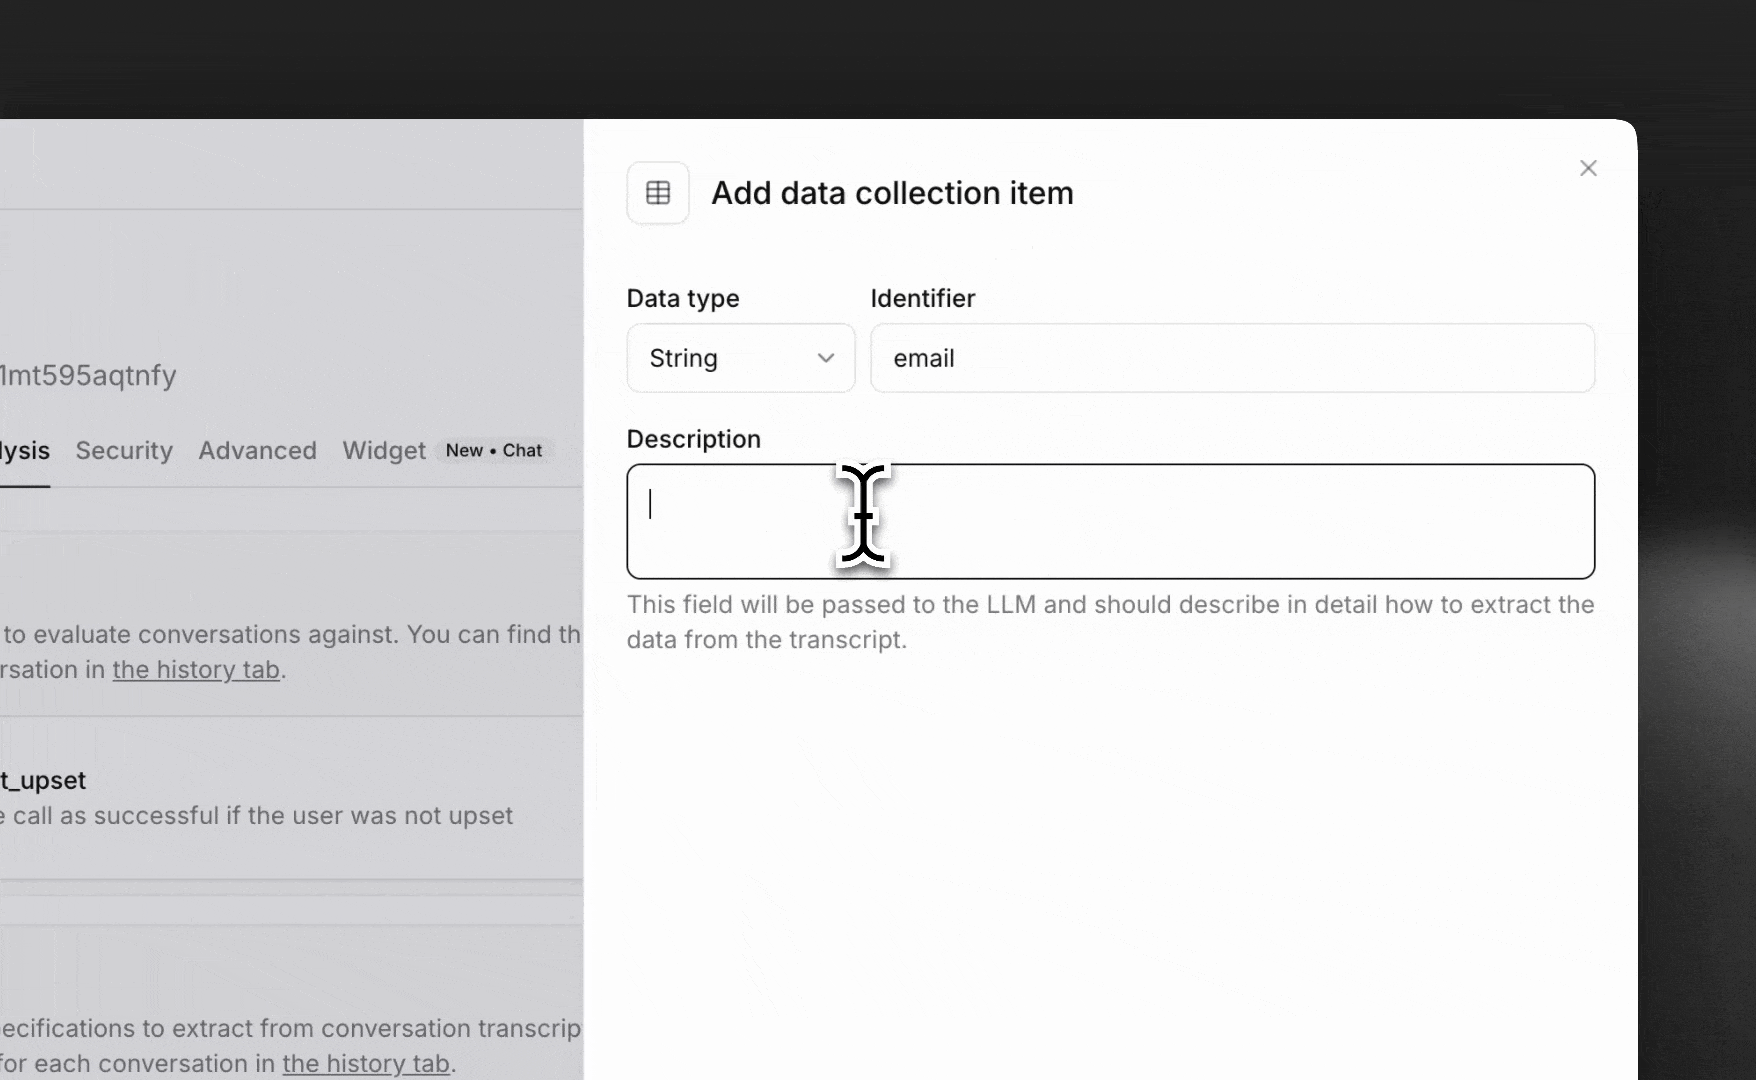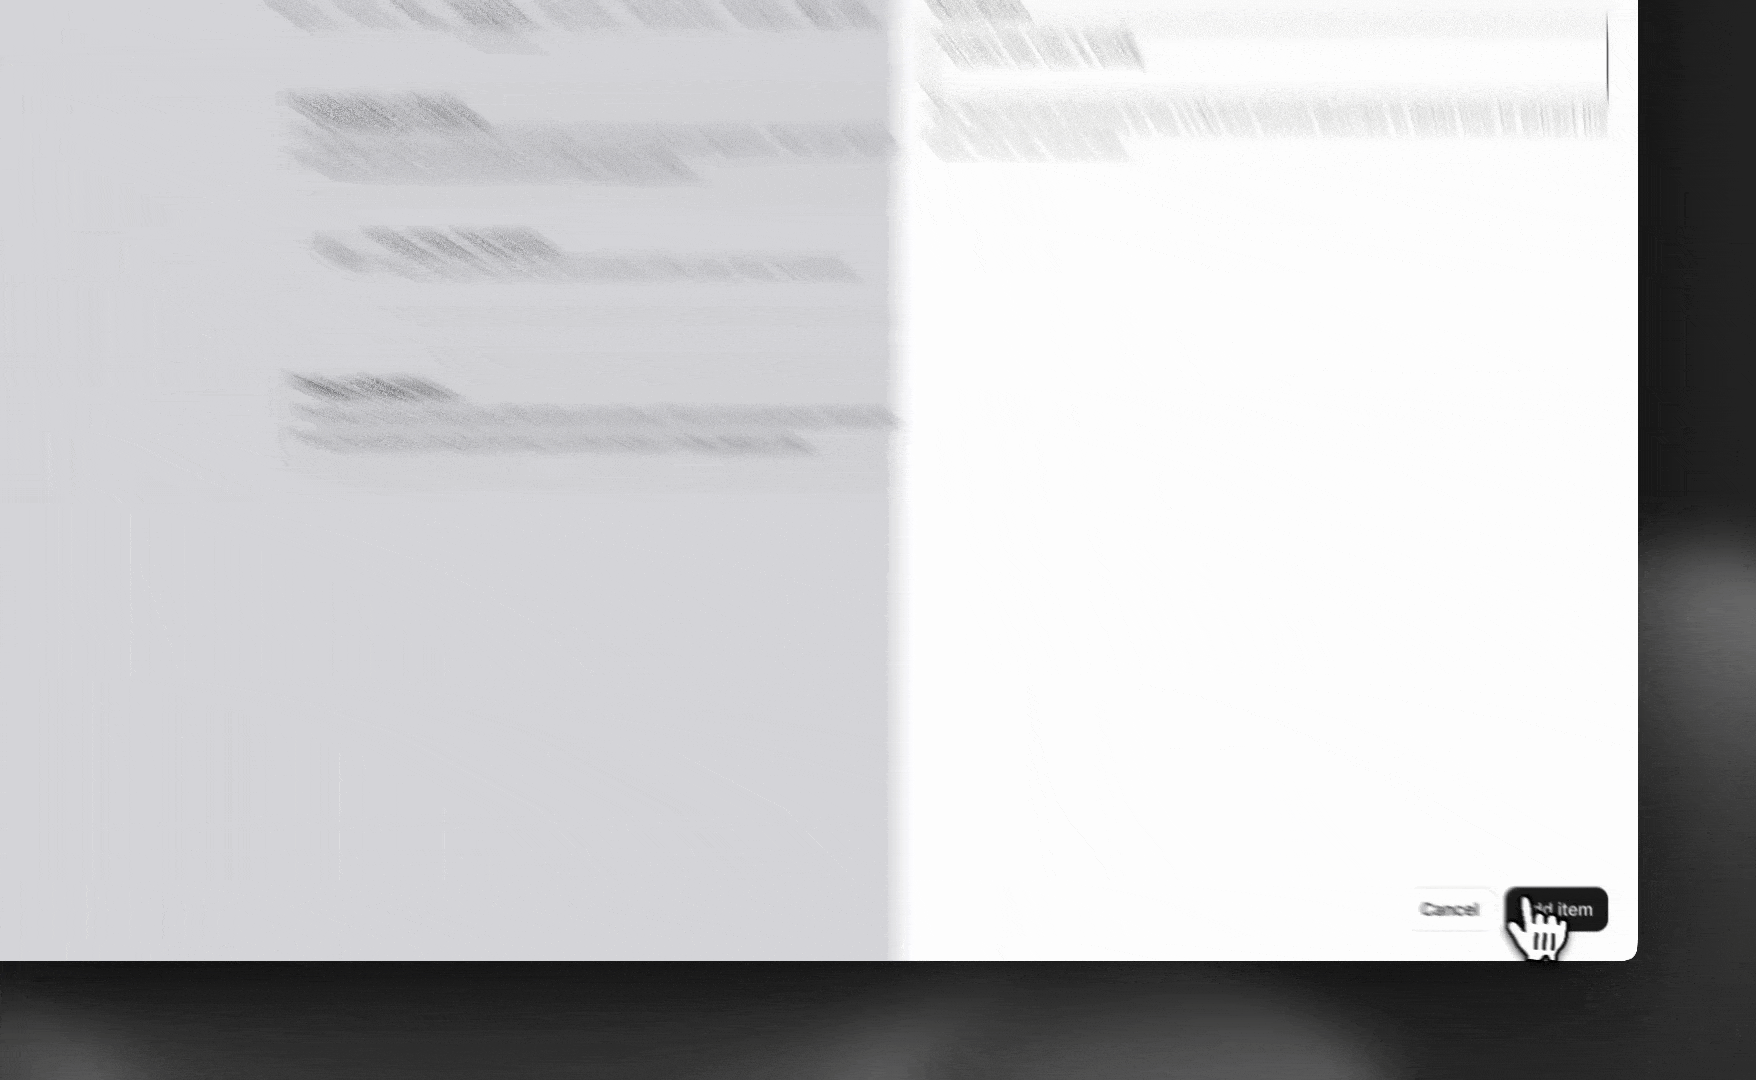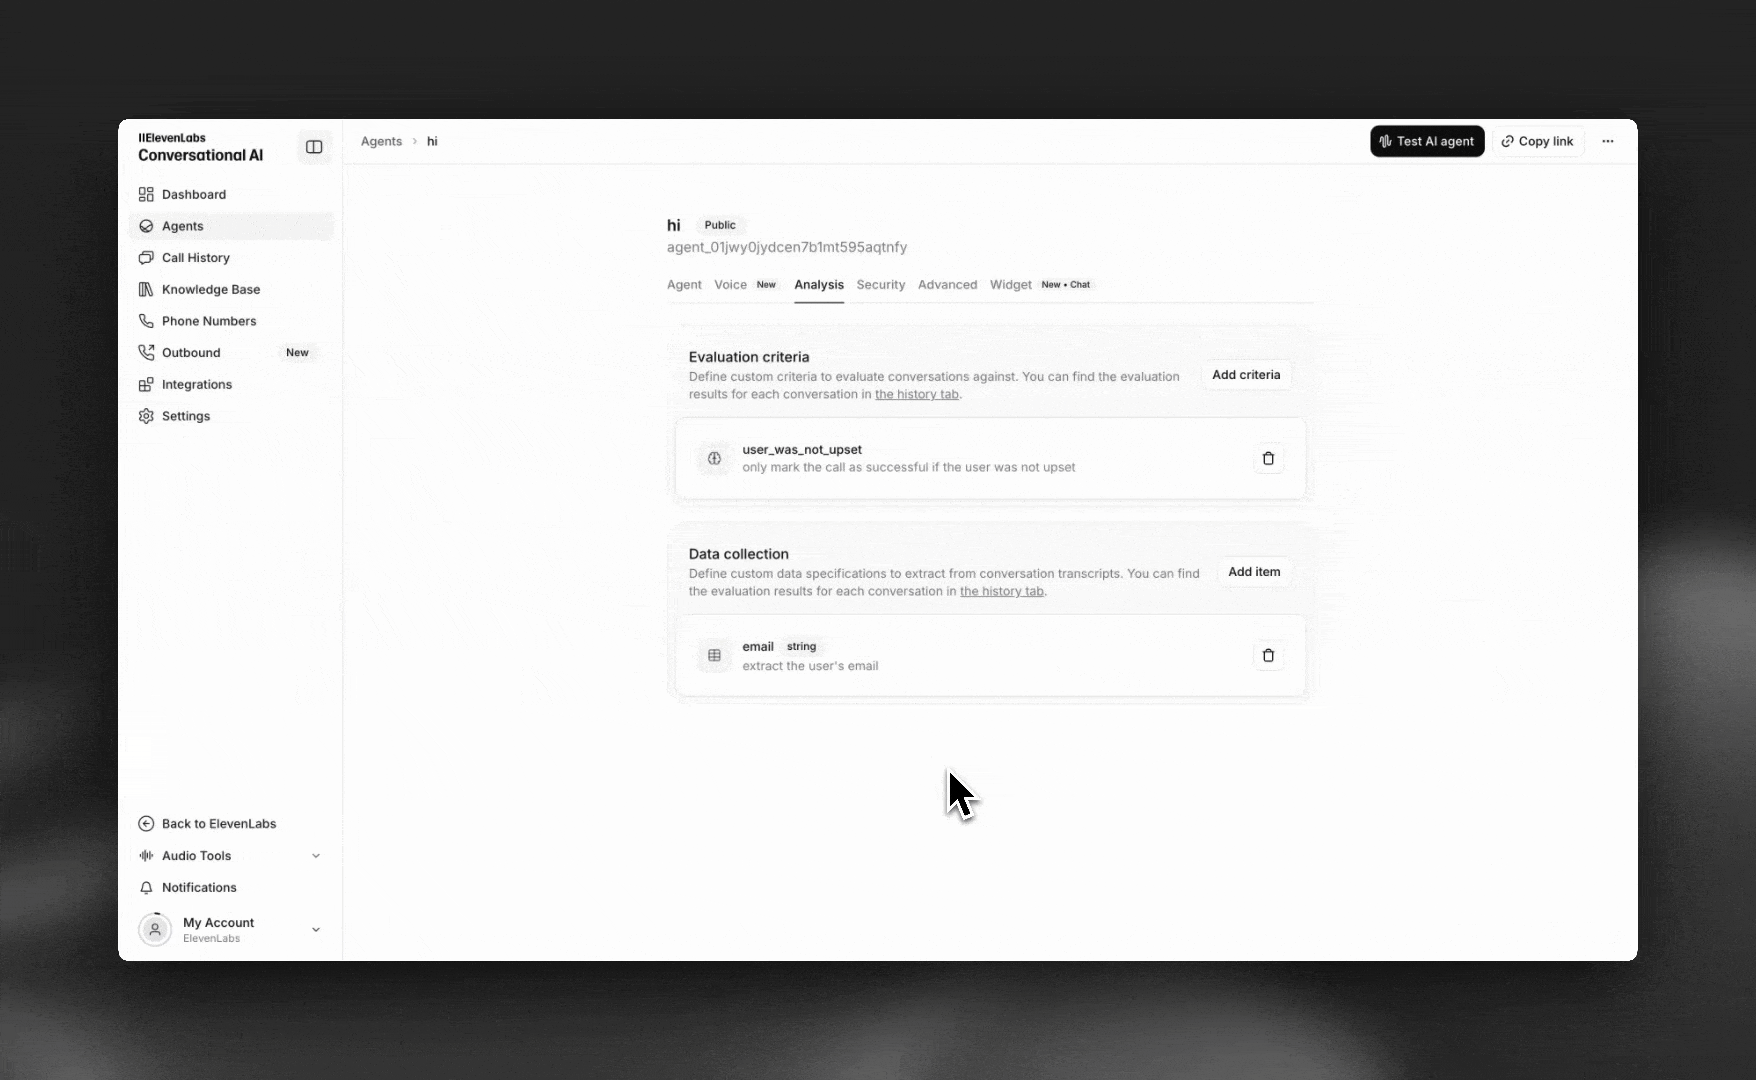
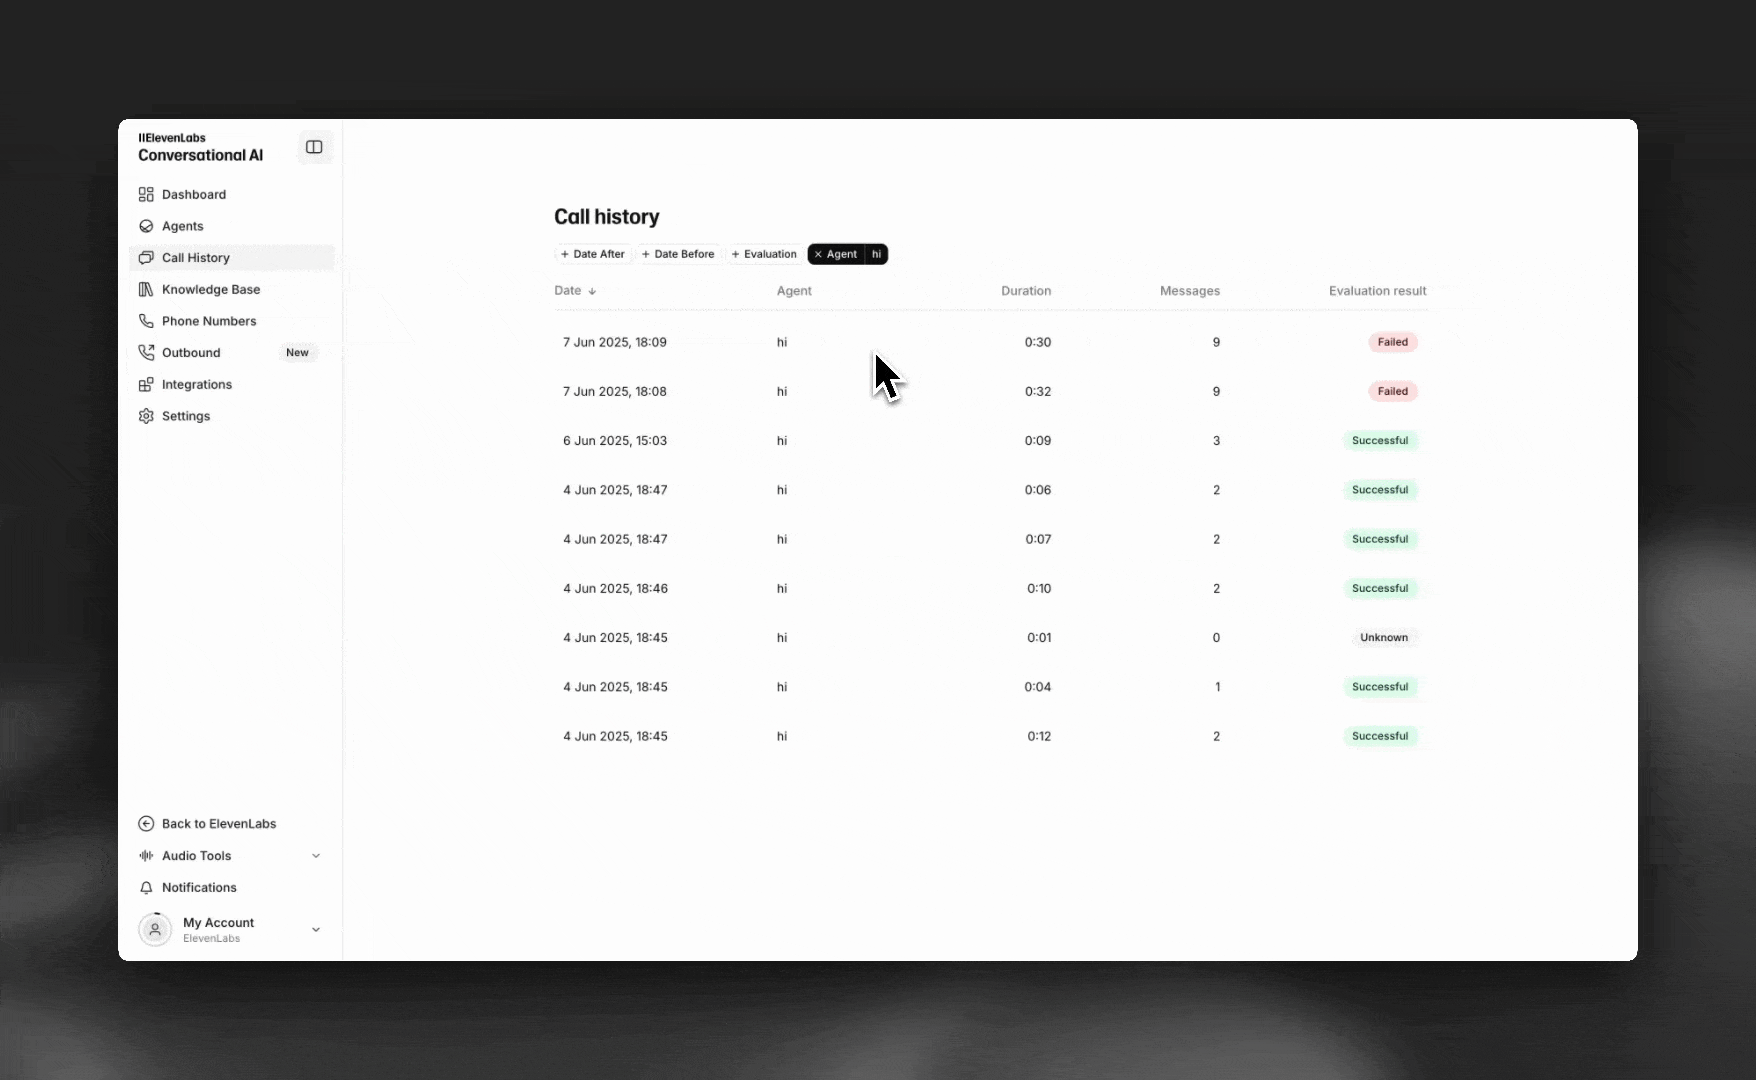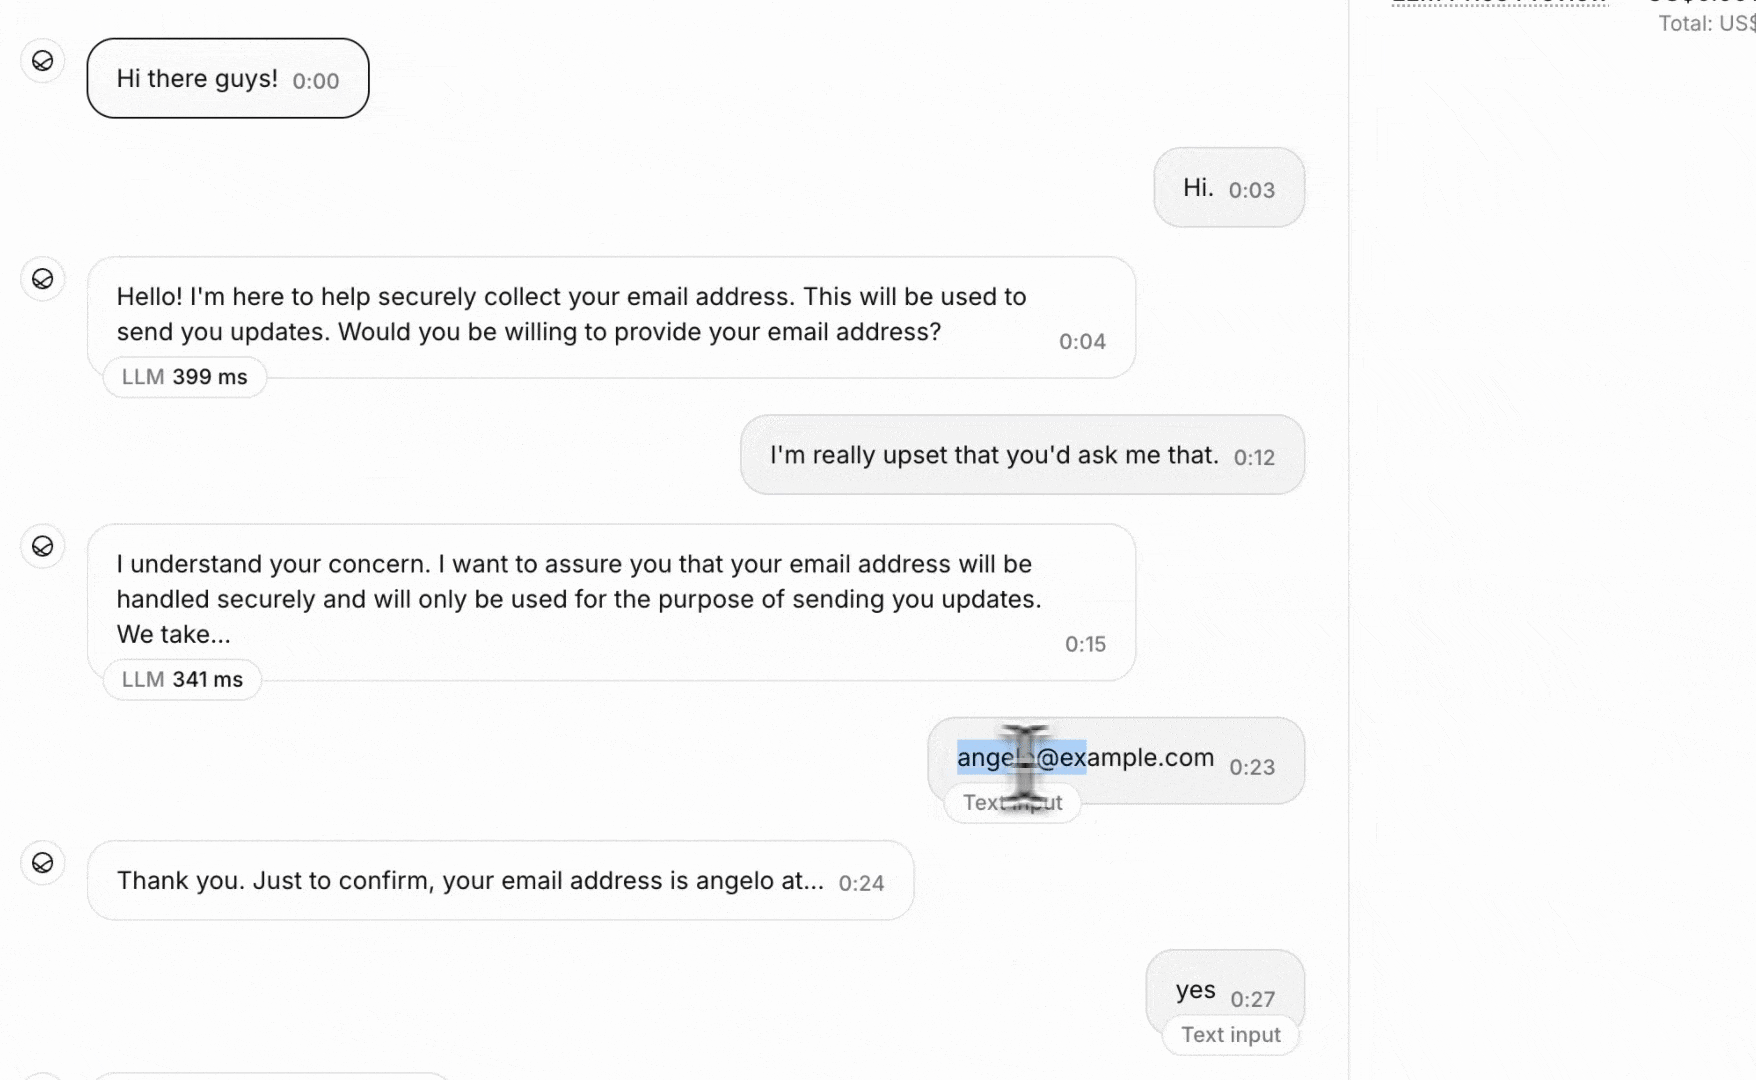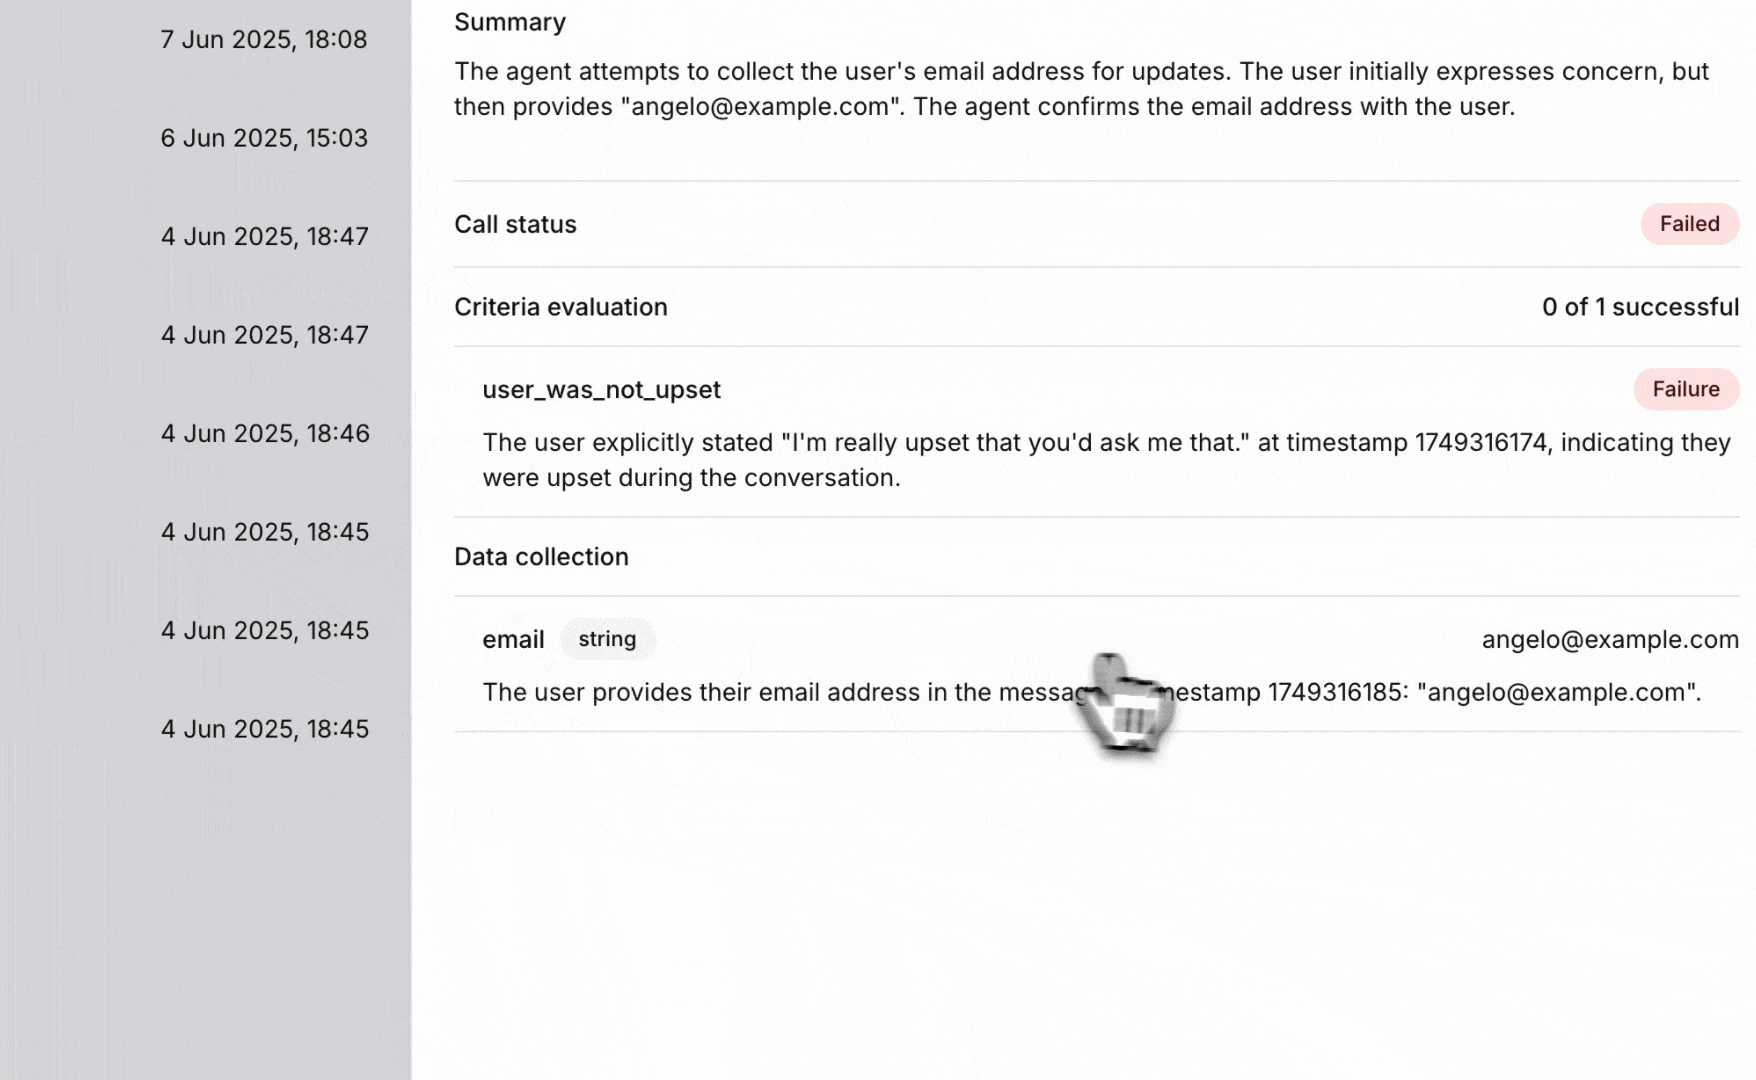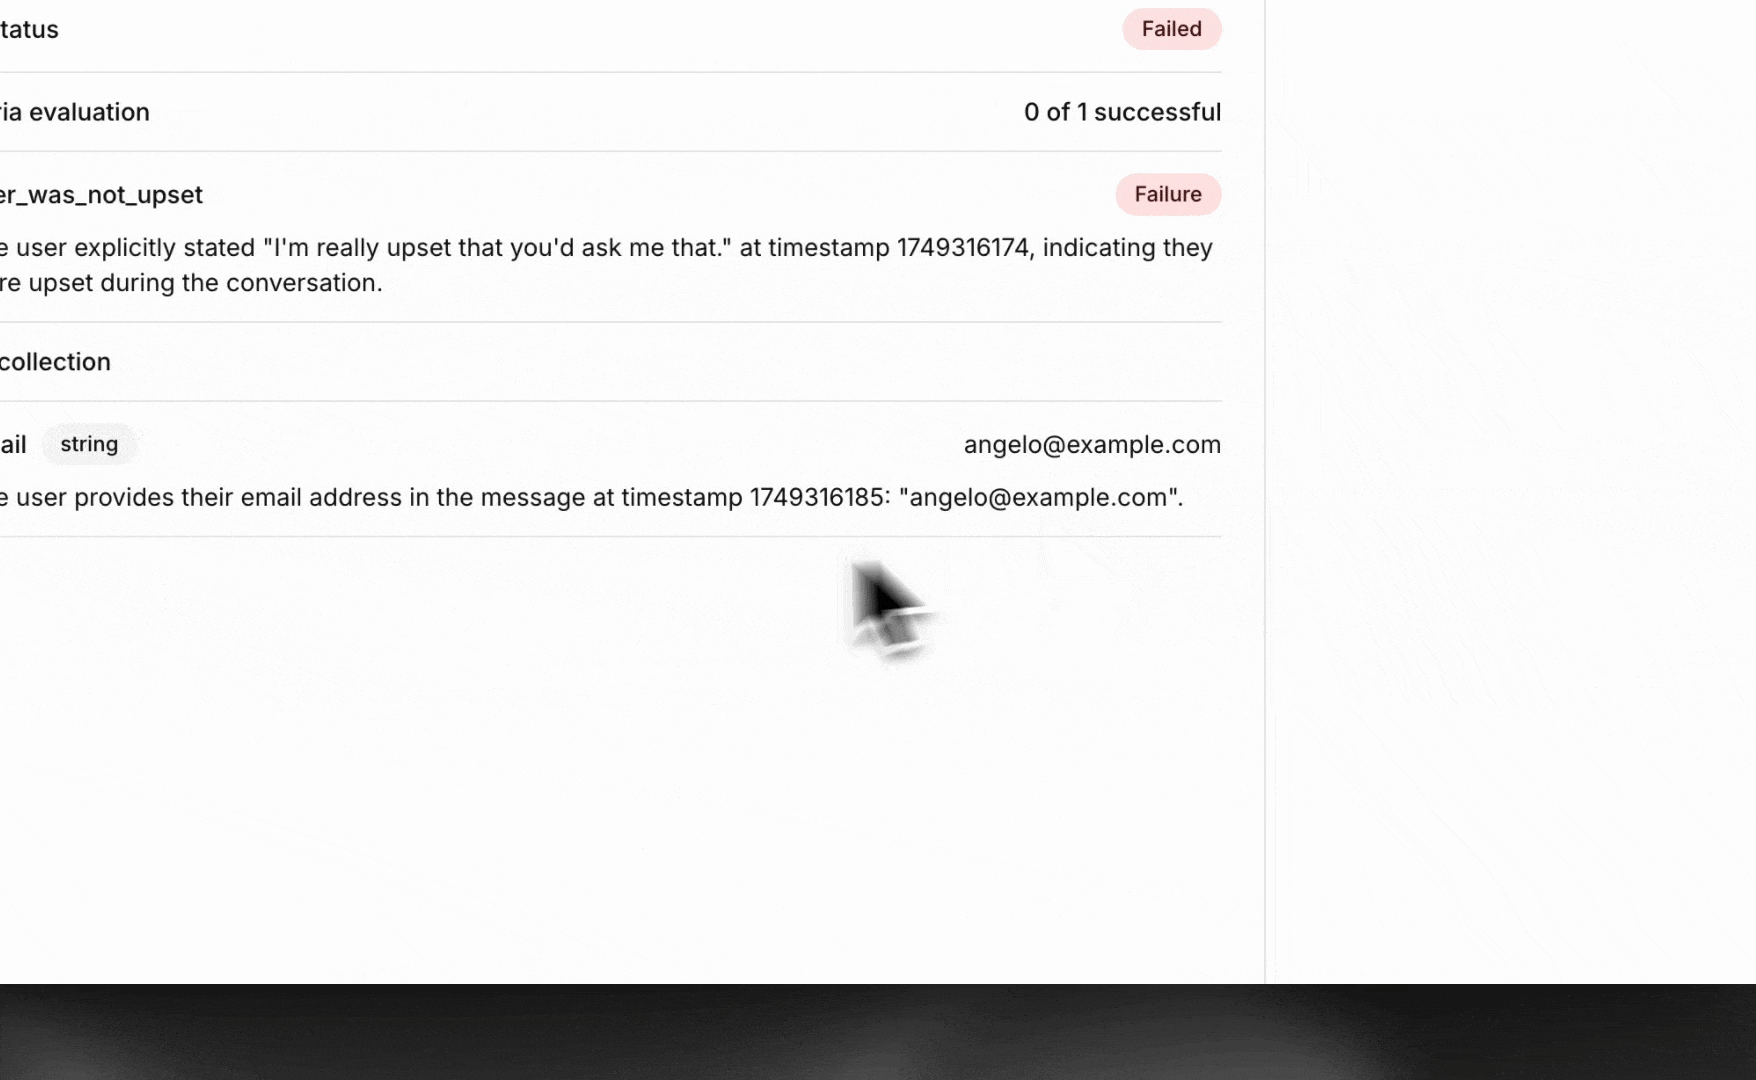
ベストプラクティス
効果的な抽出プロンプトの書き方
- 期待する形式を明確に指定する(例:「user@domain.com形式のメールアドレス」)
- 情報が欠けている場合や不明な場合の対応を指定する
- 有効なデータと無効なデータの例を含める
- 検証要件を記載する
一般的なデータ収集の例
連絡先情報:
email:「標準形式(user@domain.com)で顧客のメールアドレスを抽出」phone_number:「市外局番を含む顧客の電話番号を抽出」full_name:「顧客が提示したフルネームを抽出」
ビジネスデータ:
issue_category:「顧客の問題を、技術、請求、アカウント、一般のいずれかに分類」satisfaction_rating:「顧客が示した数値による満足度評価を抽出(1~10の尺度)」order_number:「顧客が言及した注文番号または参照番号を抽出」
行動データ:
was_angry:「通話中に顧客が怒りや不満を表したかどうかを判定」requested_callback:「顧客が折り返し連絡またはフォローアップを依頼したかどうかを判定」
欠落したデータや不明確なデータの処理
要求されたデータが文字起こし内に見つからない場合や曖昧な場合、抽出結果はnullまたは空の値になります。次の点を検討してください。
- アプリケーションで条件分岐を使用して欠損データを処理する
- 不完全な抽出に対するフォールバック基準を作成する
- 必要な情報を一貫して収集できるようエージェントをトレーニングする
データ型のガイドライン
文字列
ブール値
整数
数値
他の型に当てはまらないテキストベースの情報に使用します。
例:
- 顧客名
- メールアドレス
- プロダクトカテゴリ
- 問題の説明
ベストプラクティス:
- 必要に応じて期待する形式を指定する
- 検証要件を含める
- 標準化の必要性を検討する
ユースケース
トラブルシューティング
データ抽出で空の値が返される
- 会話の文字起こしにデータが存在することを確認する
- 抽出プロンプトが十分に具体的か確認する
- データ型が期待する形式と一致していることを確認する
- 会話中に情報が明確に伝えられたかを検討する
データ形式に一貫性がない
- 形式の指定について抽出プロンプトを確認する
- プロンプトに検証要件を追加する
- データ標準化のための後処理を検討する
- さまざまな会話シナリオでテストする
パフォーマンスに関する考慮事項
- データ収集ルールごとに処理時間が追加される
- 複雑な抽出ロジックは評価に時間がかかる場合がある
- 抽出精度と速度要件を監視する
- 可能な場合は効率のためにプロンプトを最適化する
抽出されたデータは、CRMシステム、データベース、分析プラットフォームとのインテグレーション用に通話後 Webhookから利用できます。