

Generazione aumentata dal recupero
Panoramica
Retrieval-Augmented Generation (RAG) consente al tuo agente di accedere e utilizzare grandi knowledge base durante le conversazioni. Anziché caricare documenti interi nella finestra di contesto, RAG recupera solo le informazioni più pertinenti per ogni query dell’utente, consentendo al tuo agente di:
- Accedere a knowledge base molto più grandi di quanto potrebbe contenere un prompt
- Fornire risposte più accurate e basate sulla knowledge base
- Ridurre le allucinazioni facendo riferimento al materiale sorgente
- Ampliare la knowledge base senza creare più agenti specializzati
RAG è ideale per gli agenti che devono fare riferimento a documenti di grandi dimensioni, manuali tecnici o knowledge base estese che supererebbero i limiti della finestra di contesto del prompting tradizionale. RAG aggiunge una leggera latenza al tempo di risposta dell’agente, circa 250 ms.
Questo video è stato registrato con una versione precedente della dashboard. I passaggi di configurazione di RAG sono invariati, ma alcuni elementi dell’interfaccia potrebbero apparire diversi.
Come funziona RAG
Quando RAG è abilitato, il tuo agente elabora le query degli utenti seguendo questi passaggi:
- Elaborazione della query: la domanda dell’utente viene analizzata e riformulata per un recupero ottimale.
- Generazione dell’embedding: la query elaborata viene convertita in un embedding vettoriale che rappresenta la domanda dell’utente.
- Recupero: il sistema trova i contenuti semanticamente più simili nella tua knowledge base.
- Generazione della risposta: l’agente genera una risposta usando sia il contesto della conversazione sia le informazioni recuperate.
Questo processo garantisce che le informazioni pertinenti alla query dell’utente vengano passate all’LLM per generare una risposta corretta dal punto di vista fattuale.
Guida
Prerequisiti
- Un account ElevenLabs
- Un agente conversazionale ElevenLabs configurato
- Almeno un documento aggiunto alla knowledge base dell’agente
Abilita RAG per il tuo agente
Aggiorna dalla dashboard
Aggiorna tramite CLI
Aggiorna tramite API
Nelle impostazioni dell’agente, vai alla sezione Knowledge Base e attiva l’opzione Use RAG. Configura il modello di embedding, il numero massimo di chunk di documenti e la distanza vettoriale massima nella scheda Advanced, secondo necessità.
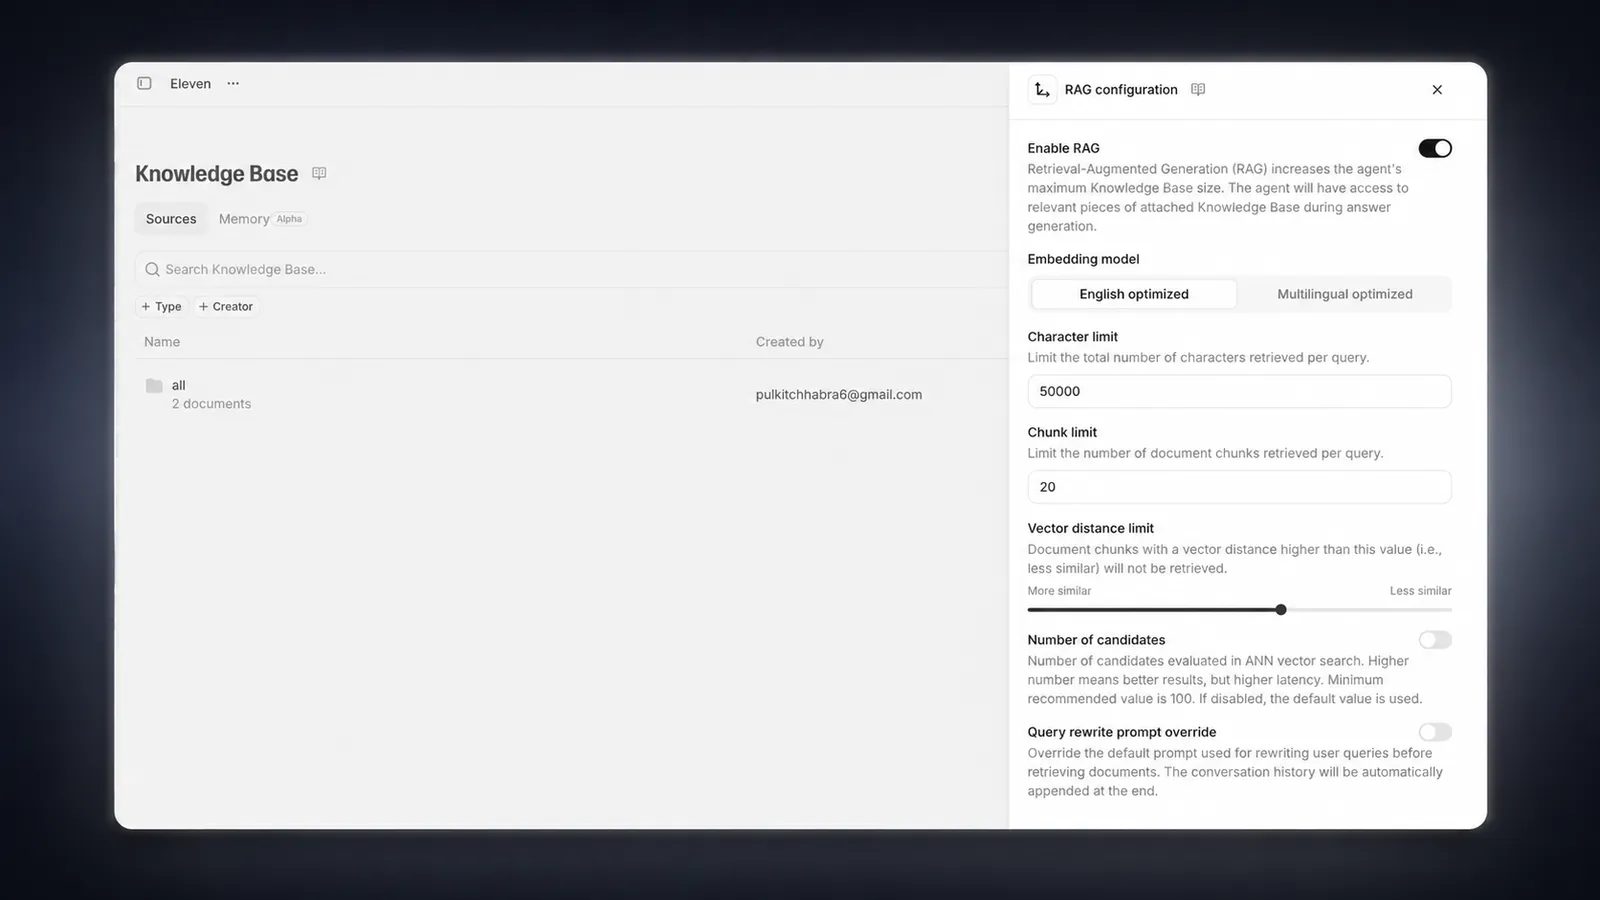
Indicizzazione della knowledge base
Ogni documento della knowledge base deve essere indicizzato prima di poter essere utilizzato con RAG. Questo processo avviene automaticamente quando un documento viene aggiunto a un agente con RAG abilitato.
L’indicizzazione di documenti di grandi dimensioni può richiedere alcuni minuti. Puoi controllarne lo stato nell’elenco della knowledge base.
Configura le modalità di utilizzo dei documenti (facoltativo)
Per ogni documento della knowledge base, puoi scegliere come utilizzarlo:
- Auto (predefinito): il documento viene recuperato solo quando è pertinente alla query
- Prompt: il documento viene sempre incluso nel prompt di sistema, indipendentemente dalla pertinenza
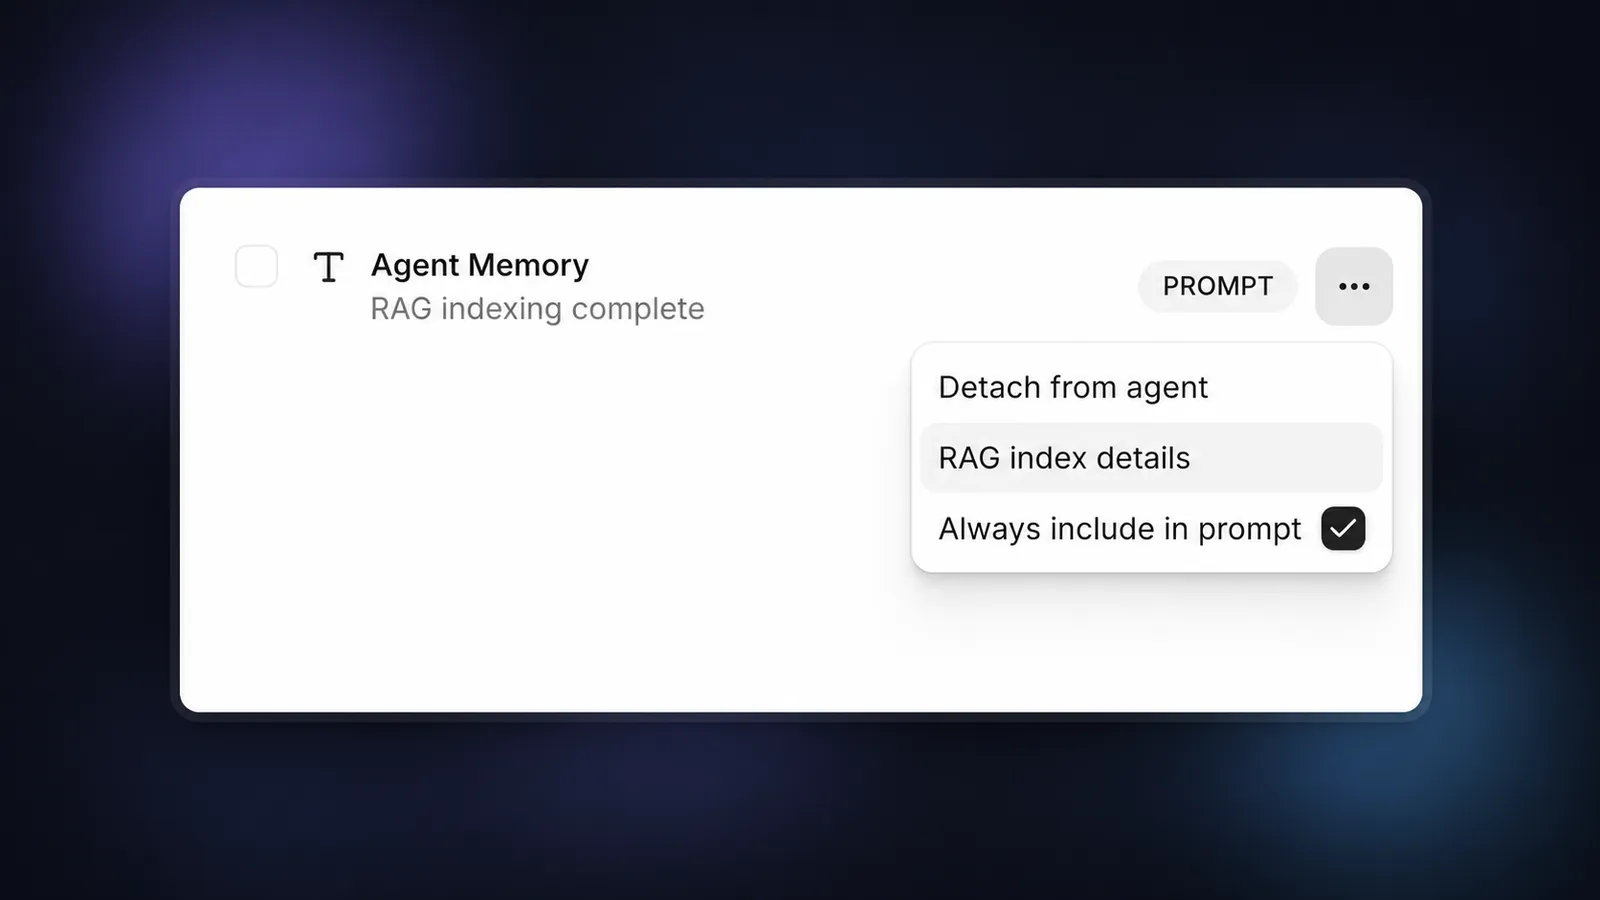
Impostare troppi documenti in modalità “Prompt” potrebbe superare i limiti di contesto. Usa questa opzione con parsimonia per le informazioni critiche.
Testa il tuo agente con RAG abilitato
Dopo aver salvato la configurazione, testa il tuo agente ponendo domande relative alla knowledge base. Ora l’agente dovrebbe essere in grado di recuperare e fare riferimento a informazioni specifiche nei documenti.
Limiti di utilizzo
Per garantire un’allocazione equa delle risorse, ElevenLabs applica limiti alla dimensione totale dei documenti che possono essere indicizzati per RAG in ogni workspace, in base al piano di abbonamento.
I limiti sono i seguenti:
Nota:
- Questi limiti si applicano alla dimensione originale del file totale dei documenti indicizzati per RAG, non alla dimensione di archiviazione interna dell’indice RAG stesso, che può essere significativamente maggiore.
- I documenti più piccoli di 500 byte non possono essere indicizzati per RAG e verranno invece utilizzati automaticamente nel prompt.
Implementazione API
Puoi anche implementare RAG tramite l’API: